$287 账单逼出的 16.9K star:给 AI agent 省 token 的可逆压缩层
一句话总结
headroom 是「AI agent 的上下文压缩层」——在内容(tool 输出、日志、RAG chunk、文件、对话历史)到达 LLM 前压缩,号称省 60-95% token、答案不变。起源极具传播力:Netflix 高级工程师 Tejas Chopra 在做 agent 时收到一张 $287 的 Claude Sonnet 账单,逆向发现高达 90% token 是冗余,遂动手做压缩。它最硬的差异化是 可逆(CCR)——本地永不删原文、向 LLM 注入 headroom_retrieve 工具,模型缺细节时自助回取,把「有损压缩」变成「默认有损、按需无损」。Rust 引擎 + Python 生态 + 自训 Kompress 模型,库/代理/MCP 三形态接入。16.9K star、Apache-2.0、5 个月爆发。
值得关注的理由
- 一个值得抄的核心范式:CCR 可逆压缩:
headroom/ccr/(3943 行)把激进压缩的风险化解掉——压缩器在产物里埋 marker([N items compressed. Retrieve: hash=abc123]),tool_injection按 provider(anthropic/openai/google 各自 schema)注入headroom_retrieve(hash, query?)工具 + system 指令,response_handler(含流式StreamingCCRHandler)拦截模型对该工具的调用执行回取,context_tracker还能跨轮主动建议 expansion。「压缩留 hash marker + 注入回取工具」可直接搬到任何「裁剪上下文但怕丢信息」的 RAG/agent 场景。 - 一条用真实事故换来的认知(最值千金):压缩和 provider 的 prompt caching 是两个互相打架的省钱手段——KV cache 要求 system prompt prefix 逐字节稳定才命中,而压缩/重写 prefix 会让 cache 全 miss,省下的 token 还不够赔上 cache miss 的钱(这正是 Issue #327「缓存命中率骤降」的本质)。
cache_aligner.py因此从「重写 prefix 抽离动态内容」退守到纯检测——只用结构化解析(UUID 走uuid模块、ISO8601 走fromisoformat、刻意不用 regex)检测易变 prefix 并告警,但不改一个字节。做 LLM 成本优化前必须先搞清它和 provider 端缓存的相互作用,别两个省钱手段互相抵消。 - 几个扎实的工程模式:① ContentRouter 类型路由(Rust magika 链检测内容类型 → 7 类专用压缩器 → 多级兜底 → 两层 TTL cache);② Rust↔Python parity harness(录制旧实现 fixture 带
input_sha256→ 新实现回放逐字段 diff、连 f64 1-ULP 抖动都归一,是任何重写/换语言迁移的黄金模式——不过诚实说 comparator 当前仍是 Phase 0 stub);③ 拒绝静默 fallback(未实现能力raise NotImplementedError、Rust 检测是硬依赖无假兜底);④ 长驻 ONNX 内存治理(关 arena/mem_pattern + 信号量限并发稳住代理 RSS)。
项目展示
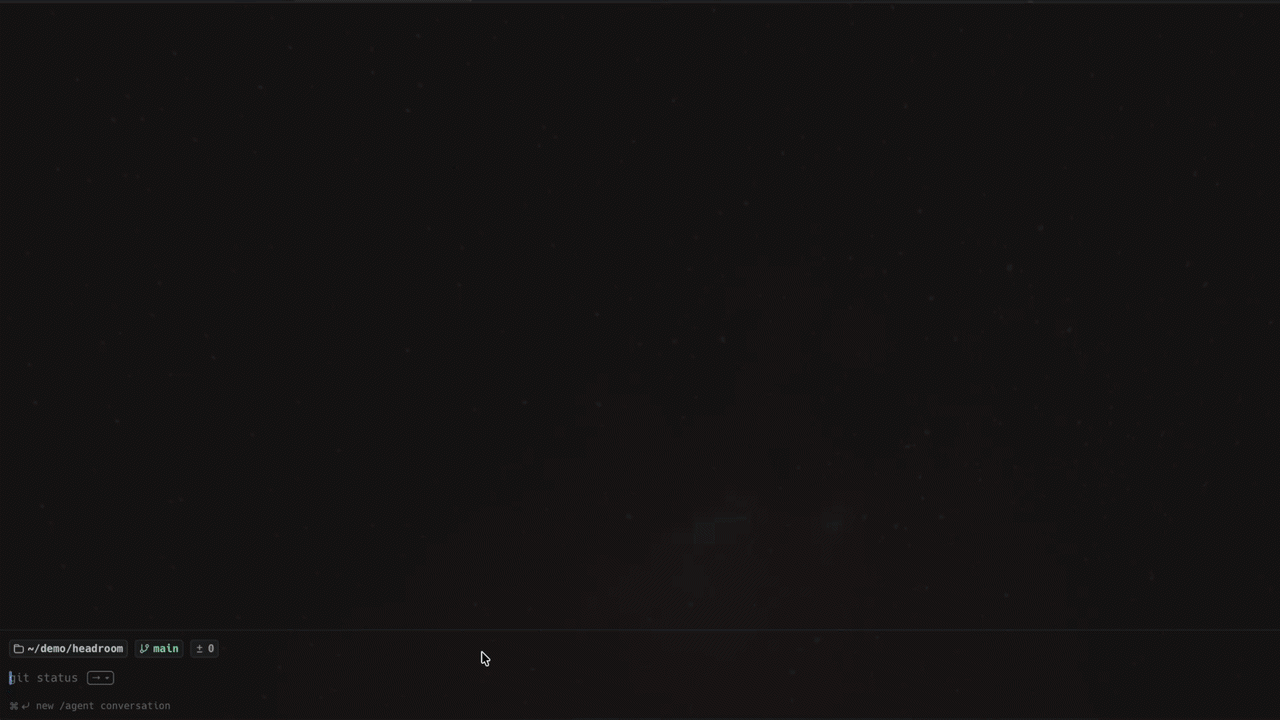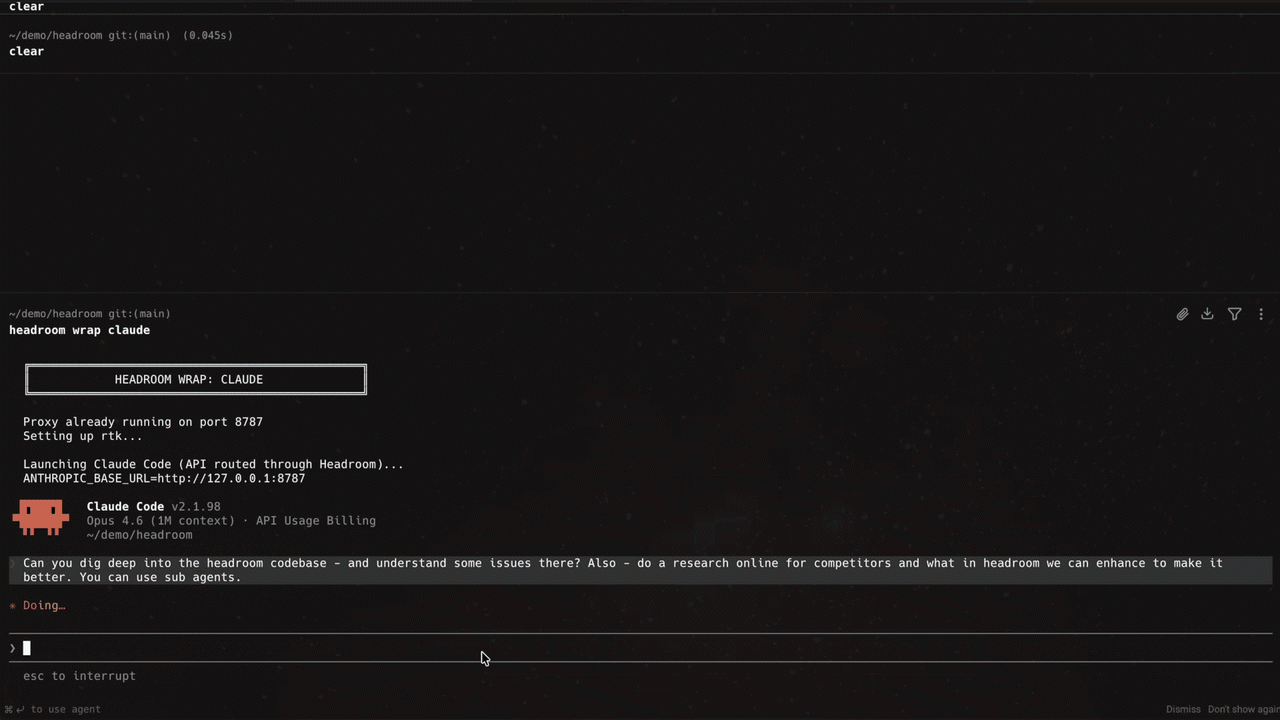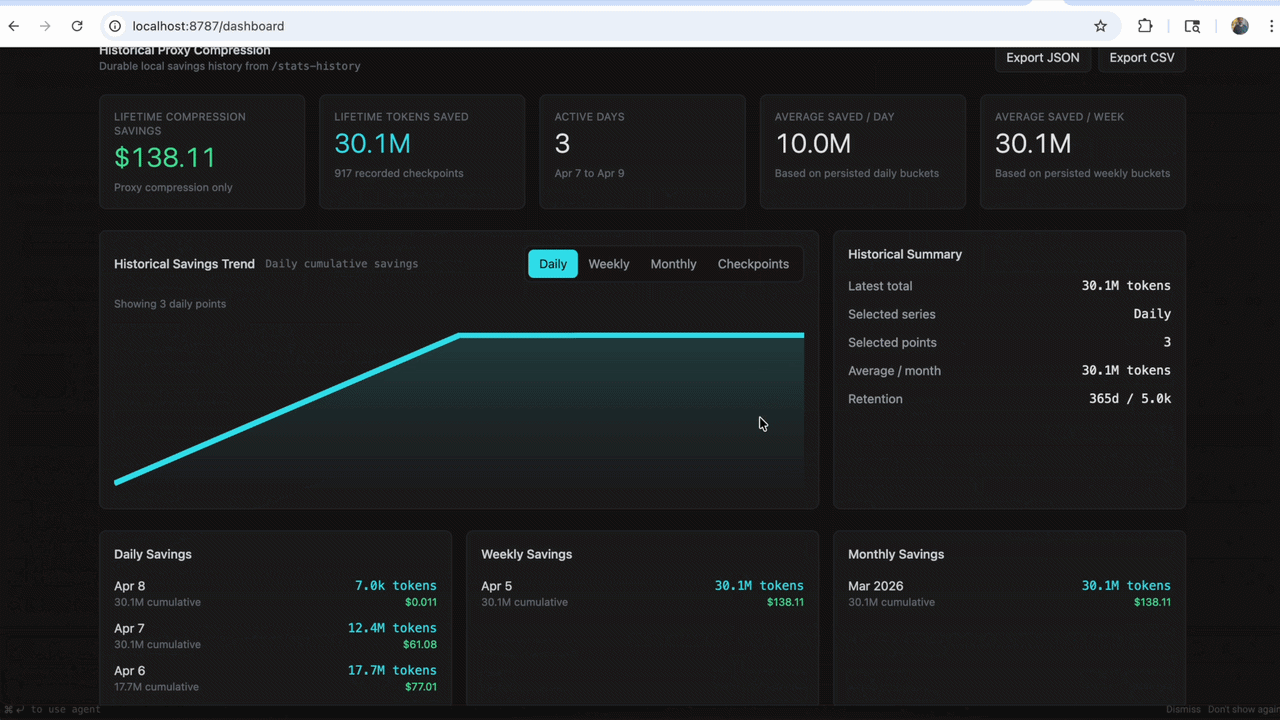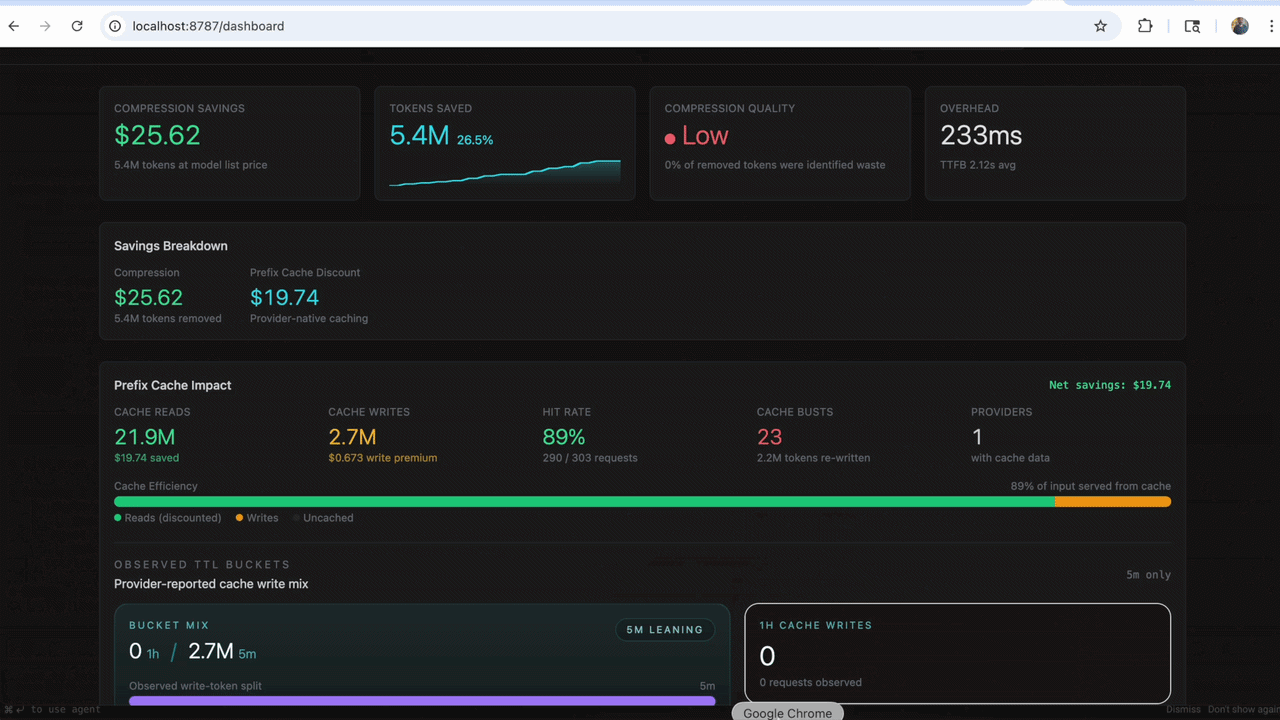
实时演示:10,144 → 1,260 token,同样找到那条 FATAL。库/代理/MCP 三形态接入,
headroom wrap claude一行包裹即用。文档 https://headroom-docs.vercel.app/docs。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/chopratejas/headroom |
| Star / Fork | 16,906 / 1,078(5 月底媒体报道时仅 ~2000 star,1 个月内 8 倍,病毒式爆发) |
| 代码行数 | 全仓 50.7 万行虚高——自研约 22 万行(Python 14.3万 + Rust 6.6万 + TS sdk 1万),压缩内核仅 ~1.5 万行;虚高来自 vendored Vercel AI SDK(33MB/20万+行)+ 测试(13万行)。注释比 0.241(重 docstring) |
| 项目年龄 | 5 个月(2026-01-07 起,今日仍活跃;近 90 天占全部提交 85%) |
| 开发阶段 | 密集开发(4 月 launch 暴增 677 commit,5/6 月回落到高位兼容性打磨) |
| 贡献模式 | 创始人主导 + 强力二号 + 社区(63 人;Tejas Chopra ~52%、JerrettDavis 237、周末 23%/深夜 21.9% all-in) |
| 热度定位 | 大众热门 · 爆发型(媒体集中报道「Netflix 工程师开源省 AI 钱工具」+ Trendshift) |
| 版本 | v0.23.0(154 tag / 5 月 ≈ 每天 1 版,SemVer,改完即发的激进 CD);已发 PyPI/npm headroom-ai |
| License | Apache-2.0(+ ENTERPRISE.md 企业版变现) |
| 质量评级 | 文档/测试/CI「优」· 代码/错误处理「良」 |
作者视角:为什么存在这个项目
创始人/作者背景
Tejas Chopra(chopratejas)——Netflix 高级工程师(Los Gatos),LinkedIn 显示 12+ 年大规模分布式系统经验,GitHub 13 年老号、43 repo、bio 仅写「Software」(低调老兵型)。名下其他 repo 全是个位数 star,headroom 是唯一爆款——不是网红连续创业,而是真痛点踩中风口。强力二号 JerrettDavis(237 commit) 显著缓解 bus factor,加 63 人社区,是「核心少数 + 真实社区」。
问题判断
起源故事极具传播力:开发 agent 时收到 Claude Sonnet $287 账单,逆向发现高达 ~90% token 是冗余(重复结构、无关行、未触发的分支)。这是典型的「系统工程师看成本曲线」视角——不把 LLM 当黑盒,而是把「送进模型的字节」当作一条可优化的数据管线。现有方案都不够:研究型 prompt 压缩库(LLMLingua-2)只压文本、是研究产物非生产中间件;RTK/lean-ctx 只压 CLI 输出且不可逆;托管 API(数据出本地);provider 原生 compaction 只压对话历史一维、不可逆、锁单一厂商。
解法哲学(可逆压缩 + Rust 性能 + 全链路 + fail loud)
三条信念在代码里有清晰落点:① 可逆优先于激进——CCR 本地永不删原文 + 注入回取工具;② Rust 拿性能、Python 拿生态——核心压缩器迁到 Rust(crates/headroom-core 34.8K 行),Python 端保留薄 PyO3 shim;③ 拒绝静默 fallback——内容检测 Rust 是硬依赖无 Python 兜底、未实现能力直接 raise NotImplementedError、proxy bypass header 当 contract assertion 无条件遵守。
战略意图(开源 + 企业版 + 多形态铺开)
分布式系统直觉处处可见:把压缩做成挡在数据流前的透明代理(像 sidecar/网关)、两套实现用 parity harness 防漂移(像多副本一致性校验)、CompressionCache 两层带 TTL(注明可换 memcached/Redis)。Apache-2.0 + ENTERPRISE.md(compression_decision.py 里就有 license_denied 分支)。多形态降低接入门槛:库/代理/MCP/agent wrap + LangChain/Agno/LiteLLM/Vercel AI SDK 集成。自训模型上 HuggingFace、包发 PyPI/npm、docker 镜像——「开源造势 + 企业版变现 + 全生态卡位」。
核心价值提炼
创新之处
- CCR 可逆压缩(marker + headroom_retrieve 回取工具)(新颖度 4/5,实用性 5/5,可迁移性 5/5):把有损压缩变成「默认有损、按需无损」,本地存原文 + 跨 provider 注入回取工具 + 流式/batch/主动 expansion 全覆盖。适用任何 agent 上下文裁剪、RAG chunk 压缩、工具输出去噪。
- ContentRouter 类型路由 + 兜底链(新颖度 3/5,实用性 5/5,可迁移性 5/5):内容检测(Rust magika 链)→ 7 类专用压缩器(JSON/源码 AST/日志/diff/搜索/纯文本 ML/图像)→ 多级 fallback → 两层 TTL cache。适用多模态/多格式数据处理管线。
- Kompress 双头 ModernBERT + ONNX INT8 长驻部署(新颖度 4/5,实用性 3/5):token 分类头(keep/discard)+ span CNN 头兜底(token 头犹豫时 span 头救场),ONNX 关 arena 稳 RSS。适用需本地、低延迟、无 LLM 调用的文本压缩。
- Rust↔Python parity harness(fixture 录制回放 diff)(新颖度 3/5,实用性 4/5,可迁移性 5/5):迁移期防漂移的契约工具,连 f64 ULP 都归一。适用任何重写/换语言/双实现项目。
- CacheAligner 退守 detector-only(压缩 vs prompt-cache 张力的解法)(新颖度 3/5,实用性 4/5):用结构化解析(非 regex)检测易变 prefix 并告警而不改写。适用所有 LLM 成本优化中间件。
- 四形态共用单条 pipeline(新颖度 3/5,实用性 5/5):库/代理/MCP/中间件全走
compress.py的同一TransformPipeline,接入面广而内核唯一。
可复用的模式与技巧
- 压缩留 hash marker + 注入回取工具:有损裁剪时埋
hash=...marker 并注入按 hash 回取的 tool——任何「裁剪上下文但怕丢信息」的场景。 - 检测 → 策略表 → 专用 handler → 兜底链:内容类型路由的通用骨架——多格式数据处理。
- fixture 录制回放做实现一致性测试:录旧实现 input/output(带 sha256)→ 新实现回放 diff(含浮点归一)——重写/换语言迁移。
- 拒绝静默 fallback(fail loud):未实现能力
raise NotImplementedError、硬依赖不给假兜底——提升可调试性。 - 两层 TTL 压缩缓存(skip set + result cache):先用「确定压不动」的 skip set 极速跳过、再查结果缓存。
- 长驻进程 ONNX 内存治理:关 arena/mem_pattern + 信号量限并发 + malloc_trim——任何跑本地 ML 推理的常驻服务。
关键设计决策
最值得记录的是 压缩 vs provider prompt caching 的张力(CacheAligner,#327)——这是被真实事故教育后的诚实撤退,也是整个 LLM 成本优化领域的认知陷阱。问题本质:压缩和 provider 的 prompt caching 是两个互相打架的省钱手段,provider KV cache 要求 prefix(system prompt)逐字节稳定才命中,而压缩/重写 prefix 会让 cache 全 miss,省下的压缩 token 还不够赔上 cache miss 的钱。cache_aligner.py 的解法是退守:旧的「strip 动态内容再 re-insert」路径违反 invariant I2(cache 热区/system prompt 绝不可变),已删除;现在只用结构化解析器检测易变内容(UUID 走 uuid 模块、JWT 看 shape、hex hash 看长度——刻意不用 regex),发 warning 告诉用户「你的 cache prefix 不稳」,但不改 prompt,压缩只发生在「live zone」(非缓存的活跃区)。这个 Trade-off 放弃了对 system prompt 的压缩收益,换取不破坏 provider cache——是诚实但有代价的妥协,也是一条值千金的工程认知。
真实核心解剖:
compress.py单例TransformPipeline(CacheAligner→ContentRouter,失败 fail-open 返回原文);transforms/(content_router 2677 行调度中枢 + 各类型压缩器);ccr/(3943 行可逆层);proxy/(最大主战场,handlers/openai.py 5859 行);crates/(Rust 引擎 + PyO3 + parity)。
竞品格局与定位
| 项目 | Stars | 定位 | 与 headroom 关系 |
|---|---|---|---|
| LLMLingua / LLMLingua-2 (MS) | 6.3K | prompt 压缩研究标杆 | Kompress 直接对标(号称 drop-in 替代、快 2.3x);但 LLMLingua 只压文本/不可逆/研究产物,headroom 把它对应能力只当 7 类压缩器中「纯文本」那一类 |
| Selective Context | 421 | 困惑度上下文裁剪研究 | 小众、近停更、研究原型 |
| LiteLLM | 49.6K | LLM 网关/路由(100+ provider) | 互补非竞品:路由不压缩;headroom 通过 callback 接入被集成 |
| GPTCache | 8.1K | LLM 语义缓存 | 互补:缓存(命中不调 LLM)vs 压缩(调但少送 token),方向正交可叠加 |
差异化护城河
全链路(tool 输出/RAG/历史/日志全压)+ 可逆(CCR)+ 多形态(库/代理/MCP)+ 自训模型四件套同时具备的「生产成品」,目前没有直接对手把这四样凑齐。可逆 CCR + 四形态共用单内核是最硬的两块。真正的冲突对象不是 GPTCache 这类缓存,而是 provider 原生 prompt caching(#327)——这点比和任何竞品的关系都重要。
竞争风险
- 效果可信度:headline「60-95%」来自精选的高冗余 workload(code search/SRE 日志),而严谨 benchmark(SQuAD/BFCL)压缩率只有 19%/32%(虽准确率保住);方法论部分未公开、accuracy 表 N=100 偏小;#46「Doesn’t seem headroom is compressing」反映信任鸿沟。
- Kompress 循环验证:训练标签由 Claude Sonnet 生成、benchmark 又可能 Claude 评分(Claude 评分 7.9 vs LLMLingua-2 5.9),「快 2.3x/同等效果」说服力打折。
- 代理兼容是长期税:handlers 巨大(openai.py 5859 行)、fix 占 ~50% 多来自此,#71 Codex 鉴权、#84/#488 订阅制鉴权难适配是命门,provider 一变就追。
- bus factor + v0.x raw:两人主导、每天 ~1 版激进 CD;parity comparator 仍是 Phase 0 stub。
- $700K 省钱/2000 亿 token 回收为厂商口径,无独立审计。
生态定位
「LLM 成本中间件」赛道里目前最完整的开源生产实现,靠多形态接入卡位、靠 CCR 可逆建立差异、企业版变现。与 LLMLingua(研究库)错位、与 LiteLLM/GPTCache 互补。
套利机会分析
- 信息差:三重叠加——强需求(LLM token 是真金白银的痛点)+ 强叙事($287 账单 → Netflix 工程师 → 5 个月 16.9K star → 省下 $70 万)+ 天然争议点(真能无损省 token 吗)。中文圈对「CCR 可逆压缩」「压缩 vs prompt-cache 张力」「ContentRouter 类型路由」「Rust-Python parity」的拆解稀缺。
- 技术借鉴:CCR marker+回取工具、内容类型路由+兜底链、fixture 录制回放 parity、fail loud、ONNX 长驻内存治理——可迁移到任何 RAG/agent 上下文优化/重写迁移/本地 ML 服务。
- 生态位:填补「全链路 + 可逆 + 多形态 + 自训模型」的 LLM 成本中间件空白;与 LLMLingua 错位、与 LiteLLM/GPTCache 互补。
- 趋势判断:踩在「LLM 成本优化 + context engineering」趋势上;长期看「benchmark 方法论公开可信 + 代理兼容收口 + 解决压缩-缓存张力 + 摆脱循环验证」决定其口碑能否撑住爆发的热度。
风险与不足
- benchmark 偏乐观:headline 数字来自精选高冗余场景,严谨 benchmark 压缩率低得多、方法论部分未公开、样本小。
- 压缩 vs prompt-cache 张力(#327):真实存在,两个省钱手段可能互相抵消,CacheAligner 退守是诚实但有代价的妥协。
- 代理兼容负担:drop-in 代理要替每家翻译鉴权/流式,fix 占 50%,订阅制鉴权(#84/#488)难适配。
- Kompress 循环验证嫌疑:Claude 造标签 + 可能 Claude 评分。
- 可见性/信任鸿沟:fail-open 会掩盖压缩失效(#46 用户感知不到没压)。
- bus factor + v0.x raw:两人主导,每天一版激进发布,parity comparator 尚未填满。
行动建议
- 如果你要用它:适合每天跑 AI coding agent(Claude Code/Cursor/Codex/Aider/Copilot)、想零改代码省 token 的人;
pip install headroom-ai或headroom wrap claude一行包裹。务必先实测你自己的 workload 压缩率(headline 数字是精选场景)、确认不和你依赖的 provider prompt caching 打架(#327)、订阅制鉴权场景先查兼容性。只用单一 provider 原生 compaction、或在不能跑本地进程的沙箱里则不适合。 - 如果你要学它:直奔
headroom/ccr/(CCR 可逆机制,最值得抄)+headroom/transforms/content_router.py(类型路由 + 兜底链)+headroom/transforms/cache_aligner.py(压缩-缓存张力的认知,看头部注释)+headroom/compress.py(四形态共用单 pipeline)+crates/headroom-parity(迁移一致性 harness)+onnx_runtime.py(长驻 ONNX 内存治理)。 - 如果你要 fork / 借鉴它:CCR marker+回取工具、内容类型路由、fixture 录制回放 parity、fail loud、两层 TTL cache 是可直接迁移的设计。Apache-2.0 友好(含专利授权);但注意企业版 license gating、benchmark 需自验、代理兼容是长期维护税。
知识入口
| 资源 | 链接 |
|---|---|
| 官方文档 | https://headroom-docs.vercel.app/docs(7 算法、benchmark 表、三形态接入) |
| DeepWiki | https://deepwiki.com/chopratejas/headroom(架构总览:Transform Pipeline / CCR / TOIN 学习层,架构速读首选) |
| HuggingFace 模型 | https://huggingface.co/chopratejas/kompress-base(ModernBERT 150M 双头、21.5 万标签、对标 LLMLingua-2) |
| 安装 | pip install headroom-ai(PyPI)/ npm i headroom-ai;headroom wrap claude 一行包裹 |
| 社区 | Discord:https://discord.gg/yRmaUNpsPJ |