GitHub推荐:2.6 个月 12.7K stars:browser-use 用 12KB 文本替代 4500 万 token,把 LLM 变成视频剪辑师
一句话总结
video-use 是 browser-use 团队把「AI 浏览器代理」思路平移到视频剪辑领域——拒绝把每帧 dump 给 LLM,而是让模型「读」12KB 转录文本 + 按需生成 PNG 时间线图,用自然语言对话直接产出 final.mp4。
值得关注的理由
- token 经济学反转:30,000 帧 × 1,500 token = 4500 万 token 噪声 → 12KB 转录文本 + 数张 PNG。这是一个值得任何「LLM × 模态」项目借鉴的感知抽象范式。
- Skill-first 产品形态:仓库没有传统 CLI/library 入口,整个项目就是一份 1,030 行的
SKILL.md+ 1,925 行 helper——把工艺 know-how 编码为 LLM 可读的 prompt 范式,与 LangChain/Haystack 的「框架」路线截然相反。 - 头部公司矩阵背书 + 单日破圈:隶属 browser-use(主仓 10 万 star、融资 $17M),单日涌入 100+ star 仍处叙事红利期;Gregor Žunič(CTO)个人 50% 投入 + 6 位外部贡献者,典型的「公司旗舰仓 + 周边探索性 Skill」模式。
项目展示
项目封面图:video-use 品牌 banner
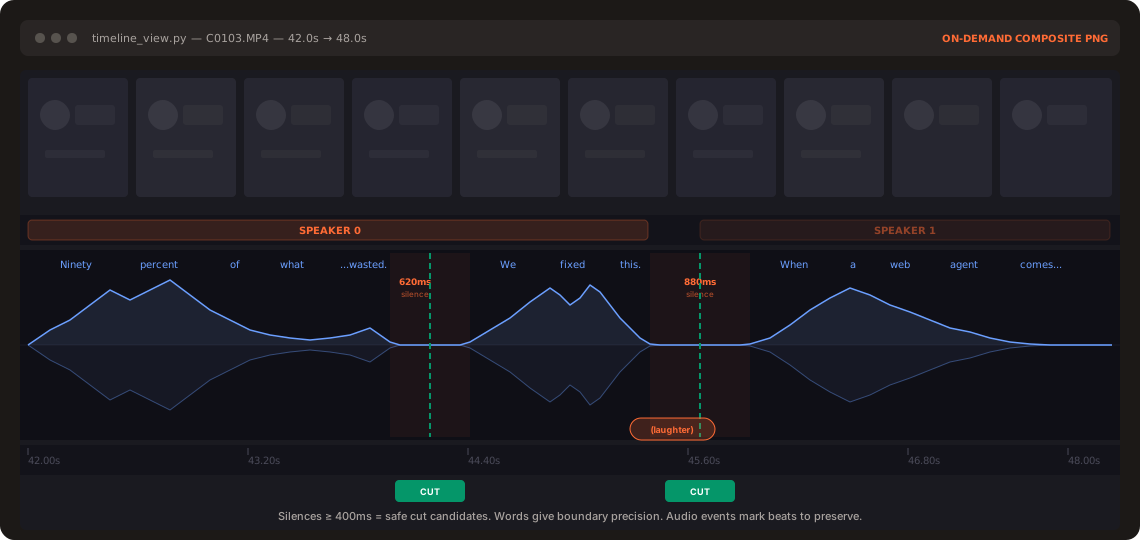
核心可视化抽象:filmstrip + 说话人轨道 + 波形 + 词级标签 + 静音缺口候选——这就是 LLM 「读」视频的方式
视频 demo(15 秒):https://www.tiktok.com/@browser_use/video/7639824093721758989(Browser Use Box 远程自动剪辑演示)
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/browser-use/video-use |
| Star / Fork | 12,704 / 1,610(70 watchers) |
| 代码行数 | 1,995 行(Python 76.6% / HTML 14.4% / SVG 7.3% / TOML 1.0%) |
| 项目年龄 | 2.6 个月(首 commit 2026-04-11) |
| 开发阶段 | 稳定维护(18 commit / 7 贡献者,单日 100+ star 涌入) |
| 贡献模式 | 公司组织仓 + CTO 主导(Top1 占 50%,其余 5 人各 1-4 commit) |
| 热度定位 | 大众热门(12.7K stars,单日破圈红利期) |
| 质量评级 | 代码[良好] 文档[优秀] 测试[无] |
作者视角:为什么存在这个项目
创始人/作者背景
Gregor Žunič(browser-use CTO)是 video-use 唯一主创,9/18 commits = 50%。browser-use 主仓 2024-12 立项,15 个月内做到 10 万 star、融资 $17M,是 2025 年最被关注的 AI 浏览器代理框架之一。video-use 是该公司「AI agent × 多模态内容」矩阵的延伸。
问题判断
“Naive approach: 30,000 frames × 1,500 tokens = 45M tokens of noise. Video Use: 12KB text + a handful of PNGs.”
作者看到了 LLM × 视频的最大障碍:不是模型不够强,而是帧的 token 成本。如果用 LLM 做视频编辑,朴素方案(每帧 dump)注定破产。同样的洞察在 browser-use 主仓里被验证过——把网页的视觉截图变成结构化 DOM,让 LLM 用文本「读」浏览器。video-use 是这套「LLM 读 X」思路的第二次落地,只是 X 从网页换成了视频。
解法哲学
- Two-Layer Perception:Layer 1 是音频转录(必加载),Layer 2 是可视化合成(按需)。
- 音频驱动剪辑:cut 跟随 speech boundary 与 silence gap,视觉只是 drill-down 验证。
- Ask → Confirm → Execute → Self-Eval → Persist 5 段循环,最多重试 3 次。
- 12 条硬性生产规则 + 大量 worked examples:把 ffmpeg 那些「silent failure」陷阱(字幕被覆盖、PTS 偏移、音频 pop、ASR 时间戳漂移)固化为 hard rule;taste 与艺术风格留给 worked example,由 LLM 在材料面前做判断。
- 零内容假设:talking heads / montages / tutorials / 旅行 / 访谈全部走同一条管道。
战略意图
video-use 在 browser-use 的产品矩阵里属于「LLM × 多模态内容」的能力外延,与主仓(浏览器代理)、workflow-use(4K★,工作流)、browser-harness(15.5K★)形成互文。商业化路径有两条:① 把 skill 直接卖给个人创作者(Browser Use Cloud 上有入口);② 把它做成「always-on editing from your own VPS or Telegram」的 Browser Use Box 增值服务。典型的 open-core 试探:Skill 本身开源,云端 + Box 是商业层。
外部深度视角:未找到有独立分析深度的文章(项目太新,独立评测尚少)。DeepWiki 已收录完整架构拆解。
核心价值提炼
创新之处
-
「LLM 读视频」的两层抽象(新颖度 5/5 / 实用性 5/5 / 可迁移性 5/5)
- 12KB 转录 + 按需 PNG,彻底绕开帧的 token 陷阱。
- 可迁移到任何「LLM × 高维模态」场景:音频、3D 点云、长文档扫描件。
-
12 hard rules + worked examples 双层 prompt(新颖度 4/5 / 实用性 5/5 / 可迁移性 5/5)
- 把 ffmpeg 的「silent failure」陷阱和工艺 know-how 编码为 LLM 可读的硬规则;taste 留给 worked examples。
- 这是「LLM-as-craftsman」的 prompt 范式,可迁移到任何「LLM 当专业编辑/律师/医生」的项目。
-
Per-segment extract → lossless
-c copyconcat(新颖度 3/5 / 实用性 5/5 / 可迁移性 4/5)- 拒绝单次 filtergraph,避免叠加 overlay 时双编码浪费。可迁移到任何 ffmpeg 多段合成场景。
-
HDR auto tone-map(HLG/PQ → Rec.709)(新颖度 3/5 / 实用性 4/5 / 可迁移性 3/5)
- 自动检测 HDR 源并降级映射,省去用户手工选 LUT。
-
Auto-grade bounded adjustments(±8% cap)(新颖度 4/5 / 实用性 4/5 / 可迁移性 4/5)
- 拒绝 creative LUT,约束在 ±8% 内的自动调色;保留 taste 空间给 LLM/用户。
-
Self-eval bounded loop(≤3 轮)(新颖度 4/5 / 实用性 5/5 / 可迁移性 5/5)
- 在渲染输出上对每个 cut boundary ±1.5s 取样检查,跳出无限循环。这是 agent 系统的通用教训:没有上界的 self-loop 是死亡螺旋。
-
Skill 组合而非代码组合(新颖度 5/5 / 实用性 4/5 / 可迁移性 4/5)
skills/manim-video/整目录 vendor 进来作为子技能,跨 Skill 协作不需要写胶水代码。
-
平台 safe zone 入 hard rule(MarginV=90)(新颖度 2/5 / 实用性 4/5 / 可迁移性 3/5)
- TikTok/Reels/Shorts 各自有不被 UI 遮挡的安全区,被写成 hard rule 防止字幕被评论/点赞按钮挡住。
-
「Text + on-demand visual」= browser-use 思路的视频版本(新颖度 4/5 / 实用性 5/5 / 可迁移性 5/5)
- 把 LLM 看「结构化 DOM」的能力平移到视频领域,展示了「LLM 读 X」是一个通用范式。
-
Session memory in
project.md(新颖度 3/5 / 实用性 4/5 / 可迁移性 4/5)- 把对话历史与编辑决策 append 到项目级 markdown,下次 session 自动续上。
可复用的模式与技巧
- 「Layer 1 必加载 + Layer 2 按需」:避免一上来把昂贵模态塞进 context。
- 「12 hard rules + 大量 worked example」:硬规则管正确性,例子管 taste。
- 「Skill 是仓库,prompt 是产品」:整个 repo 就是一份可被 LLM 加载的说明书。
- 「per-segment 管线 + PTS-STARTPTS+T/TB 偏移」:处理叠加层时间对齐的标准做法。
- 「bounded self-eval」:agent 系统必须给 self-loop 加硬上界。
- 「vendor 第三方 skill」:用 vendored skill 组合代替 import 依赖。
- 「物理分离产物目录」(
<videos_dir>/edit/):保证 skill 目录纯净。 - 「post-render timeline_view」:把 self-eval 视觉化和文件化。
关键设计决策
-
决策:音频转录是 Layer 1、视觉合成是 Layer 2
- 问题:30,000 帧 = 4500 万 token,LLM 直接看视频破产
- 方案:~12KB
takes_packed.md做主阅读视图,timeline_view在决策点按需生成 PNG - Trade-off:放弃「看完整视频」能力,换来 99.9% 的 token 节省 + 更精准的 word-boundary 剪辑
- 可迁移性:高(任何「LLM × 视频/音频/3D」项目)
-
决策:per-segment extract → lossless concat
- 问题:单次 filtergraph 在叠加 overlay 时会双编码每个 segment
- 方案:先
-c copy切出每个 segment 的 h264 块,再 concat;overlay 用 PTS 偏移对齐 - Trade-off:增加 I/O 步骤,换来 2× 以上的渲染速度
- 可迁移性:中(特定 ffmpeg 场景)
-
决策:12 hard rules(silent failure 类)+ 大量 worked examples(taste 类)分层
- 问题:把所有 ffmpeg 工艺都硬编码进 prompt,LLM 会过度约束;taste 又不能完全自由
- 方案:12 条「非做不可」的硬规则 + 「worked example from one proven video」的范例
- Trade-off:规则越多越正确,越少越灵活
- 可迁移性:高(任何 LLM-as-professional 的 prompt 设计)
-
决策:vendor
skills/manim-video/而非用 pip 装- 问题:Manim 视频生成需要的不只是代码,还有大量工艺(color palette、wait timing、rendering order)
- 方案:把整个 skill 目录 vendor 进来,跨 Skill 协作走「读子 SKILL.md」协议
- Trade-off:版本同步成本(要定期 rebase 上游),换来零配置可用
- 可迁移性:高(Claude Code/Codex Agent 生态通用)
-
决策:bounded self-eval(最多 3 轮)
- 问题:agent 系统的 self-loop 没有上界会无限循环
- 方案:3 轮还没通过就 raise 给用户,由人决定继续还是接受
- Trade-off:3 轮太少可能漏掉边缘 case,太多又会浪费 token/时间
- 可迁移性:高(任何 self-improving agent)
竞品格局与定位
竞品对比矩阵
| 维度 | video-use | Descript | OpusClip | Runway | whisper + ffmpeg DIY | crewAI/autogen + 视频插件 |
|---|---|---|---|---|---|---|
| 定位 | LLM 对话式剪辑 | 文本式视频编辑 SaaS | AI 短视频切片 | 生成式视频 | 命令行 DIY | 通用 agent 编排 |
| 输入 | 自然语言 | 文本(手动) | 视频 | 文本/参考视频 | 脚本 | 自然语言 + 插件 |
| 输出 | final.mp4 | 视频文件 | 切片短视频 | 新生成视频 | 视频 | 视频(依赖插件质量) |
| 开源 | 是(MIT) | 否 | 否 | 否 | 是 | 是 |
| 硬规则沉淀 | 12 条写在 SKILL.md | 无(闭源) | 无 | 无 | 无 | 无 |
| 视频硬规则(fade/PTS/safe zone) | ✅ 内建 | ⚠️ 需手工 | ❌ | ⚠️ | ❌ 需自己写 | ❌ 需自己写 |
| Token 成本 | 12KB + 数张 PNG | N/A(闭源) | N/A | N/A | N/A | 取决于插件 |
| 学习曲线 | 中(要会写 SKILL.md) | 低(GUI) | 极低 | 低 | 高(ffmpeg) | 中 |
| 适合 | 创作者 + 编程者 | 普通用户 | 短视频博主 | 创意探索 | DevOps | 通用自动化 |
差异化护城河
- 工艺 know-how 沉淀:1,030 行
SKILL.md+ 12 硬规则 = 别人需要半年试错才能攒出来的「视频编辑工艺」。这部分是真正的壁垒。 - 同公司矩阵协同:和 browser-use 主仓共享 agent 调度范式,Box 渠道提供 24/7 远程剪辑。
- token 经济学优势:12KB 文本 + PNG 路径,比任何「每帧 dump」方案便宜 1000×。
竞争风险
- Descript/OpenAI 等大厂复制:他们有现成 SaaS 渠道和素材,工艺层只要请一个 ffmpeg 专家就能补齐。
- ElevenLabs Scribe 锁定:当前转录完全依赖 ElevenLabs(社区已在 #18 询问替代方案),单点故障。
- bus factor = 1.5:CTO 50% 投入 + 6 个外部贡献者各 1-4 commit,一旦 CTO 抽身,演化可能停滞。
生态定位
video-use 在「LLM × 多媒体」生态中占据「对话式视频编辑 Agent」的细分位。这不是要替代 Descript/Runway——后者面向「不写代码的普通用户」;video-use 面向「愿意用 LLM 编辑器的创作者 + Agent 玩家」。它和 browser-use 主仓、workflow-use、manim-video 子 skill 一起,构成「LLM 操作系统」的多模态外延。
套利机会分析
- 信息差:单日涌入 100+ star 仍处叙事红利期,但已不算「被低估」(12.7K stars)。机会在于「子项目差异化叙事 + 与主仓 browser-use 协同」的二阶价值。
- 技术借鉴:
- 「Layer 1 文本 + Layer 2 按需视觉」抽象可迁移到「LLM × 音频」「LLM × 长 PDF」「LLM × 3D 点云」等任何高 token 模态。
- 「12 hard rules + worked examples」是 LLM-as-professional 的通用 prompt 范式。
- 「bounded self-eval」是 agent 系统的必备设计。
- 「vendor 第三方 skill」是 Claude Code/Codex 生态的轻量级组合方式。
- 生态位:填补「LLM × 视频」的开源层空白。商用层有 Descript/Runway,开源层只有零散脚本(whisper + ffmpeg),video-use 把胶水层封装好。
- 趋势判断:仍在增长。video 类 AI 应用 2025-2026 是热点(Sora、Veo、Runway Gen-3),「LLM 编辑现有素材」这条线反而被生成式抢了风头,但创作工作流是生成 + 编辑混合,video-use 切的是编辑段,不冲突。
风险与不足
- 过度依赖 ElevenLabs Scribe:转录质量与对齐精度完全押注单一供应商;社区已开始求替代(whisper.cpp 路径的开放性问题未解决)。
- 零单元测试:1,925 行 helper + 1,700 行文档 = 1:1,但没有任何 test 目录。Skill 形态下「测试」=「在 Claude Code 里跑一遍」,对 prompt 变化的回归保护弱。
- CI/CD 缺失:没有
.github/workflows/、没有 pre-commit、没有 lint 配置。 - commit 类型分布异常:Refactor 0% / Docs 0% / Test 0%,写完即发、零架构整理、零补测。业余 Side Project 节奏。
- 贡献者集中度:Top1 占 50%,bus factor ≈ 1.5,CTO 一旦抽身会立即停摆。
- 商业化边界模糊:Skill 本身开源、Box/Cloud 是商业层,open-core 还是 genuinely open 取决于未来定价。
行动建议
- 如果你要用它:用前先确认 ElevenLabs 依赖可接受;第一周跑「教程视频 + 口播」这类 5-15 分钟素材;Manim 子 skill 需要 LaTeX,搭建前预留 30 分钟。对比 Descript:普通用户选 Descript,能接受自然语言工作流的创作者选 video-use。
- 如果你要学它:
- 必读:
SKILL.md(1,030 行,真正的「产品」)、README.md中「Why not just give the LLM frames?」段(token 经济学讲得最透)。 - 必看代码:
helpers/render.py(per-segment 管线 + PTS 偏移 + 字幕 LAST 顺序)、helpers/timeline_view.py(filmstrip + waveform + word labels 合成)。 - 关键 commit:
#29 portrait 视频源保留方向、#64 QA stills + SKILL.md 规则维护——展示 prod-aware 工程文化。
- 必读:
- 如果你要 fork 它:
- 替换 ElevenLabs Scribe 为
faster-whisper/ 本地 Whisper.cpp(#18 issue 已表达需求) - 增加 unit test 覆盖 per-segment 管线(最容易出 silent failure 的部分)
- 把 12 硬规则拆出成 JSON schema 校验,从 prompt 层校验降到 helper 层
- 增加
--preview-resume:self-eval 失败时支持从断点继续,不浪费已渲片段
- 替换 ElevenLabs Scribe 为
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 已收录 |
| Zread.ai | 未单独验证(DeepWiki 已覆盖) |
| 关联论文 | 无(工程范式为主,未挂论文) |
| 在线 Demo | 无官方 playground(依赖 Claude Code / Codex 本地执行;通过 Browser Use Box 远程跑) |
| 视频演示 | https://www.tiktok.com/@browser_use/video/7639824093721758989(15 秒 Browser Use Box 演示) |
| Cloud 入口 | https://cloud.browser-use.com/v4(utm_campaign=video-use) |