Anthropic 放弃的 RAG 路,Milvus 母公司偏要走:代码语义检索 MCP claude-context(1.2 万 Star)
一句话总结:claude-context 是 Milvus 母公司 Zilliz 出品的代码语义检索 MCP——把代码库用 tree-sitter 切分、embedding 向量化存进 Milvus,以 hybrid(BM25+向量)检索 + merkle 增量索引,给 Claude Code/Cursor/Gemini CLI 等 14+ 编码 agent 提供「整库语义检索」能力。它押注的「语义检索优于 grep」恰是 Anthropic 在 Claude Code 里实测后放弃的路线——这场「语义 vs grep」之争,是 2026 年代码检索最有思辨价值的论战。
值得关注的理由
- 它站在一场行业论战的最前沿。claude-context 主张「大库语义检索省 token、能召回命名不同的相近代码」;而 Anthropic 的 Claude Code 默认用 grep/agentic 搜索、曾用向量 RAG 后主动弃用(Boris Cherny 公开说明),Amazon 论文更称「关键词+agentic 多步」可达 RAG 90% 效果而无需索引。两派都有硬论据——这是该选题最值得深挖的张力。
- 「向量库厂商嵌入 AI 编码工作流」的战略样本。Zilliz 是 Milvus(40K+ star 的开源向量库)母公司,claude-context 是其 dogfooding Milvus + 开源拉新 + Zilliz Cloud 变现 + 抢占 agentic RAG 心智的标准打法。
- merkle 增量索引正面回应「RAG 会过期」的命门。哈希快照 diff 只重索引变更文件 + 5 分钟后台 sync,把向量索引最大的弱点压到分钟级。
- 它自己其实在「趋同」:用的是 hybrid(BM25 稀疏 + dense 向量)非纯 RAG,evaluation 的增强方案是 grep + 语义并存——印证实践上两派在收敛为「互补」而非「替代」。
- 少见的「拿数据说话」:
evaluation/有可复现的 grep vs 语义对照评测(SWE-bench Verified + 真实 django/xarray 案例)。
项目展示
README 含架构图(embedding → Milvus → MCP 数据流)与效率对比图:
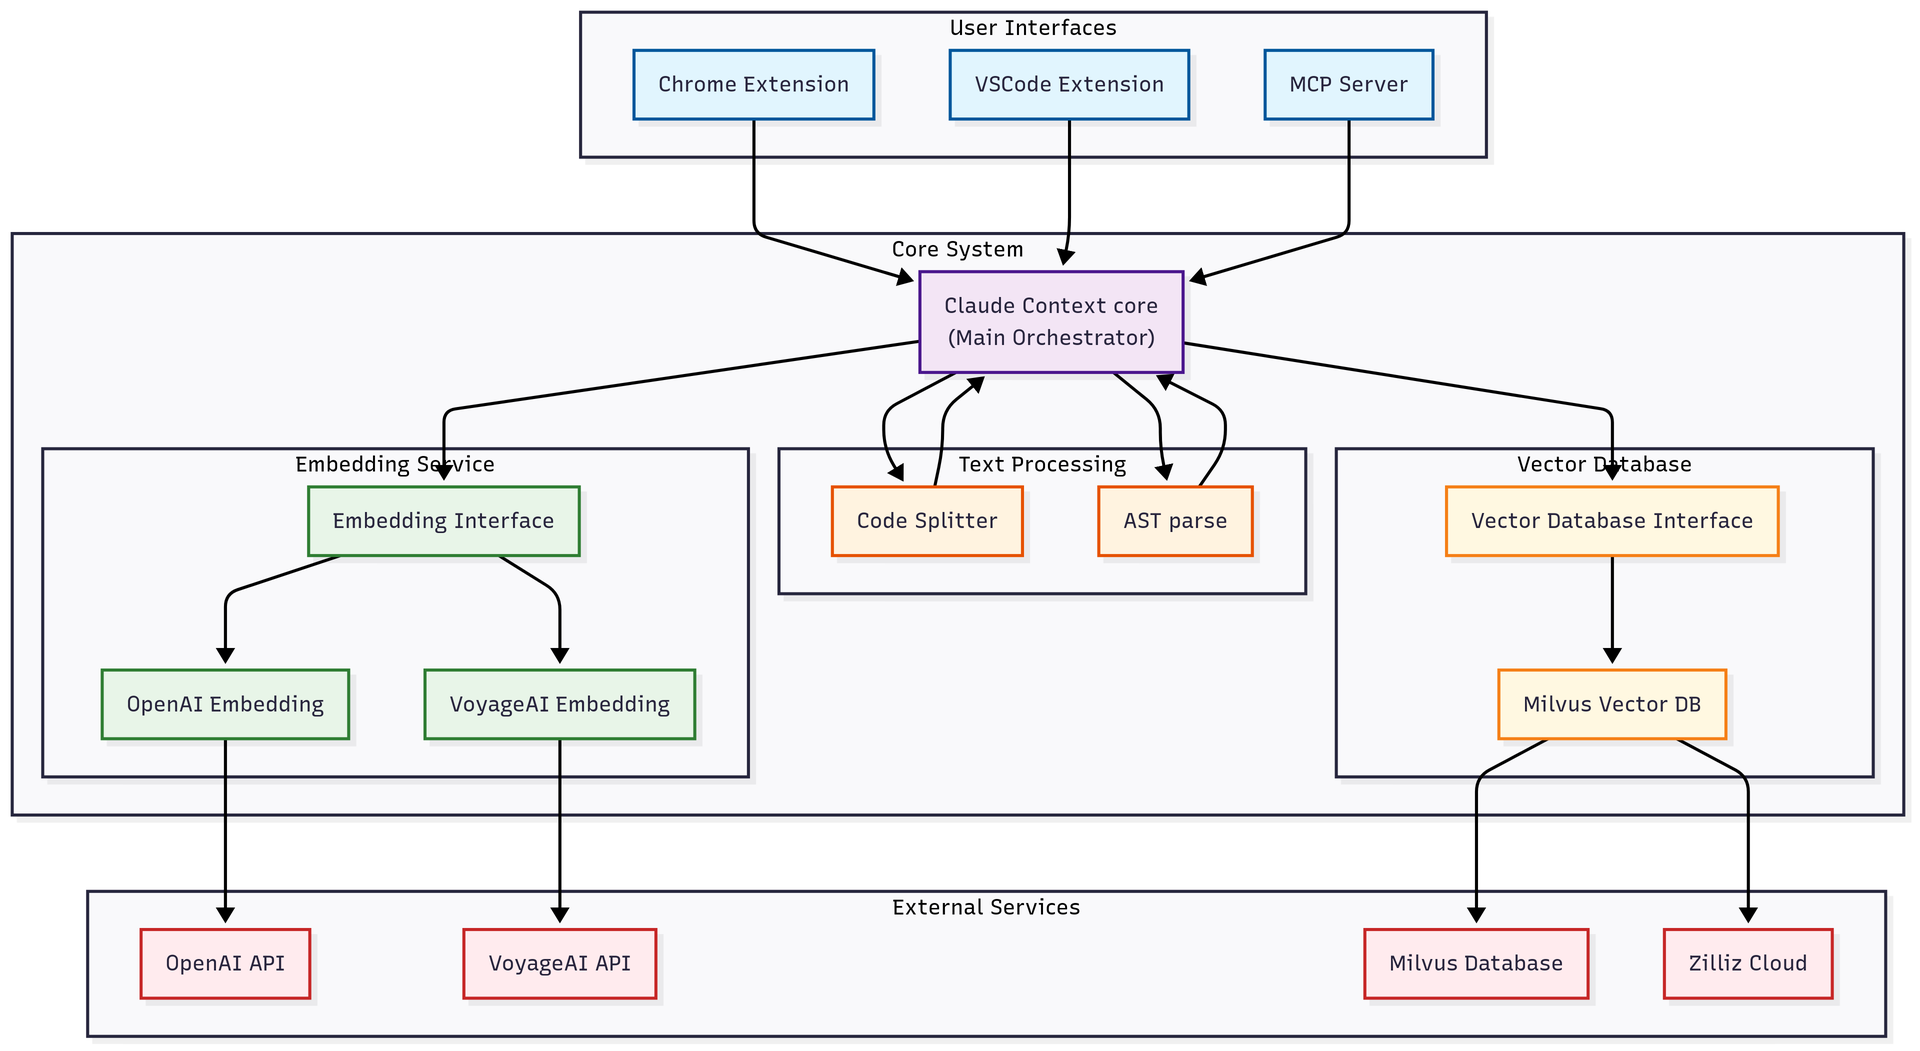
效率对比图(~40% token 减少,厂商自测口径)见仓库
assets/mcp_efficiency_analysis_chart.png;社交卡片兜底:https://opengraph.githubassets.com/1/zilliztech/claude-context
项目画像
| 维度 | 数据 |
|---|---|
| 全名 | zilliztech/claude-context |
| 定位 | 代码语义检索 MCP(让整个代码库成为编码 agent 的上下文) |
| Star / Fork | 11,787 ⭐ / 868 🍴(CSV 抓取 8,763,高速增长) |
| License | MIT |
| 代码规模 | 账面 2.5 万行;真实手写 ~1.6 万(剔除 pnpm-lock 9K),核心引擎 TS ~1.08 万;注释比 0.168 |
| 技术栈 | TypeScript(pnpm monorepo)+ Milvus 向量库 + Python(评测) |
| 建库时间 | 2025-06(约 1 年) |
| 开发节奏 | 213 commit;近 90 天 66;工作日 89%(职业项目) |
| 版本 | v0.1.14(28 tag,0.x 快速迭代) |
| 贡献者 | 33 人,Zilliz 团队 Top-3 占 73%(ChengZi 88 + Cheney Zhang 43 + ShawnZheng 25) |
| 出品方 | Zilliz(Milvus 开源向量库母公司,~$113M 融资,Zilliz Cloud 变现) |
| 核心机制 | tree-sitter 切分 + 多 embedding + Milvus hybrid 检索 + merkle 增量 |
作者视角
问题发现
Zilliz 团队观察到 agentic coding 的检索瓶颈:编码 agent 在超大代码库里靠 grep/glob 多轮翻找,既耗 token(每轮把大段目录读进上下文)又漏召回——grep 只能字面匹配,命名不同但语义相近的代码(如 authenticate vs verifyCredentials)会被漏掉。他们用可复现对照实验(evaluation/,SWE-bench Verified 30 例)量化:grep-only 平均 73K token/任务,加语义检索后降到 44K(-39.4%),检索质量 F1=0.40 持平。
解法哲学
四件套:① 语义检索(dense 向量召回语义相近代码)② hybrid(BM25 稀疏 + dense 混合,兼顾关键词精确与语义泛化,context.ts 默认 HYBRID_MODE=true)③ merkle 增量(只重索引变更文件,缓解「索引会过期」这一向量 RAG 命门)④ 多端 MCP(一套 core 引擎 + MCP server + VSCode/Chrome 扩展)。关键:他们的增强方案是 grep + 语义并存(evaluation 用 cc+grep 而非语义单干),即不取代 grep,而是叠加。
背景知识迁移
把 Milvus 成熟的向量检索能力(BM25 Function、SparseFloatVector、RRF 重排、HNSW dense 索引)迁移到「代码块」这个新载体:代码 chunk 当文档、AST 边界当切分单元、embedding provider 当编码器。milvus-vectordb.ts 的 createHybridCollection 几乎是 Milvus hybrid search 教科书式用法。
战略图景
开源 MIT 拉新 → README 第一段引导「Get a free vector database on Zilliz Cloud」→ Cloud 变现。同时在「agentic RAG」这条被 Anthropic 官方质疑的赛道卡位:用 evaluation 数据 + merkle 缓解新鲜度,正面回应「grep 够用、RAG 已弃」的论调。本质是 Milvus 的应用层卡位 + 获客漏斗。
核心价值提炼
创新点
1. merkle 快照增量索引缓解 RAG 新鲜度 — 新颖度 3/5 · 实用性 5/5 · 可迁移性 5/5
sync/merkle.ts + synchronizer.ts:每文件 sha256 构哈希快照,checkForChanges 重算后 compareStates 出 added/removed/modified diff,只对变更文件 reindexByChange(先删旧 chunk 再重索引);后台 SyncManager 默认 5 分钟一轮 + 全局锁。把「向量索引会过期」压到分钟级窗口。校正:这里的「merkle DAG」实为 root+一层子节点的扁平结构,更像「是否有任何变化」的快速门闸,随后仍 fallback 到全量文件级 diff,而非能定位变更子树的真·分层 diff。适用:频繁变更的活跃代码库。
2. 代码场景的 hybrid(BM25+dense)+ RRF 重排 — 新颖度 3/5 · 实用性 4/5 · 可迁移性 4/5
建库时一个 collection 同含 vector(dense)、sparse_vector(SparseFloatVector,Milvus BM25 Function 把 content 自动转 sparse)、content;检索两路(dense nprobe=10 + sparse drop_ratio_search=0.2)由 Milvus 端 RRF(k=100)融合。稀疏管精确关键词、稠密管语义。Trade-off:召回更全但建两套索引、双路开销,RRF k=100 写死不可调权。
3. AST/tree-sitter 代码切分 — 新颖度 3/5 · 实用性 4/5 · 可迁移性 4/5
splitter/ast-splitter.ts 按语法树节点(函数/类/方法/接口)整块切(9 语言各配 SPLITTABLE_NODE_TYPES,chunkSize=2500/overlap=300),超大节点字符级二次切,解析失败兜底 langchain 字符切。保住语义边界 vs 朴素定长切割裂函数。Trade-off:父子节点都 splittable 时会双重产出(class 整块 + 内部 method 各一块),靠检索侧按行重叠去重兜底。
4. 流式分批 + 校验后持久化的索引管道 — 新颖度 2/5 · 实用性 5/5 · 可迁移性 5/5
context.ts 的 indexCodebase:维护 chunkBuffer,攒满 EMBEDDING_BATCH_SIZE(100) 就批 embed → validateEmbeddings(整批成功才写入,不写半截/空向量)→ insertHybrid → 清缓冲;硬上限 45 万 chunk + AbortSignal 协作取消。任何「外部 API 编码 → 入库」大规模导入的通用骨架。
5. 可复现的 grep vs 语义对照评测框架 — 新颖度 3/5 · 实用性 4/5 · 可迁移性 4/5
evaluation/:SWE-bench Verified + LangGraph ReAct + grep/read/edit MCP server 三件套,量化 token/tool-call/F1;case_study/ 有 django_14170/pydata_xarray_6938 真实案例的 grep_* vs both_* 日志。同类工具里少见的「拿数据说话」。
可复用模式
- 流式分批 + 校验后持久化管道:攒批→批处理→校验通过才写库→清缓冲 + 硬上限 + AbortSignal — 任何「外部 API 编码 → 数据库」大规模导入。
- AST 语义切分 + 字符兜底 + 重叠:tree-sitter 按语法单元切、超大块二次切、降级 langchain — 代码/结构化文本 chunking。
- 哈希快照 diff 做增量:sha256 文件哈希 → 快照 → compare 出 added/removed/modified — 增量索引/构建/同步。
- 长任务状态快照 + 协作取消 + 重启恢复:状态机持久化本地、AbortController 取消、重启把中断态标 failed — MCP/CLI 长耗时异步工具。
- provider 抽象基类 + 工厂 + 运行时维度探测:统一接口、配置驱动 new、detectDimension 动态适配 — 多 embedding provider 系统。
关键设计决策
- MCP 4 工具 + 索引状态快照:只暴露
index_codebase/search_code/clear_index/get_indexing_status;SnapshotManager把状态持久化到~/.context/(v1→v2 迁移),状态机 indexed/indexing/indexfailed;进程重启把「索引中」标记为 failed;clear_index用 AbortController 协作取消在途索引后才 drop collection。长任务工具的健壮范本,但状态散落本地文件、分布式场景脆弱。 - embedding provider 抽象:基类
Embedding+ 4 provider(OpenAI/Voyage code-3/Gemini/Ollama)+ 运行时detectDimension。Trade-off:灵活,但换 provider/模型 = 维度变 = collection 不兼容必须重建索引(#81 类痛点)。 - Milvus gRPC/RESTful 双实现:同一
VectorDatabase接口两套传输(gRPC 891 + RESTful 878),覆盖更多部署环境。Trade-off:双倍维护,且向量库锁死 Milvus/Zilliz(无 pgvector/qdrant 抽象,「双实现」只是 Milvus 两种传输)。
竞品格局
| 竞品 | 定位 | 优势 | 劣势/差异 |
|---|---|---|---|
| claude-context(本项目) | 开源代码语义检索 MCP(hybrid + Milvus) | 厂商中立 MCP(14+ agent)、多 embedding、merkle 增量、MIT | 需建/托管 Milvus、绑 Zilliz、需 embedding API、索引可靠性、0.x |
| Claude Code 自带(grep/agentic) | Anthropic 官方,无索引按需 grep | 零设置/零索引/永远新鲜、能跟调用链推理、精确 | 大库多轮翻找耗 token、漏命名不同的相近代码 |
| Cursor 内置索引 | AI 原生 IDE 内置 embedding | 体验无缝、与 IDE 深整合 | 闭源、绑 Cursor、不可移植到其他 agent |
| Sourcegraph Cody | 企业级代码搜索 + AI | 跨 monorepo 全库检索、企业合规 | 个人版已下线、仅企业版、贵、需索引 |
| Augment Code | 企业级 Context Engine | 语义依赖图、超大库架构理解 | 闭源商用、面向企业 |
| Probe / grep-based MCP | 轻量 grep 系 MCP | 零索引、轻 | 无语义召回、大库扩展性弱 |
关键对照轴:① 语义/向量检索 vs grep/agentic;② 需建索引+向量库 vs 零索引开箱;③ 大库 token 效率 vs 小库 grep 够用;④ 厂商中立 MCP vs IDE 内置;⑤ Milvus 绑定 vs 通用。
综合结论——护城河:厂商中立 MCP(14+ agent 通吃)+ hybrid(BM25+dense) + merkle 增量 + 多 embedding/多 agent + 背靠 Milvus/Zilliz 全栈。竞争风险:① semantic vs grep 路线之争未定(见专节)② 索引可靠性(#145 索引成功但检索说未索引,33 评论)③ 向量库锁死 Milvus/Zilliz(无其他后端抽象)④ 官方 grep 持续进化可能碾平差距 ⑤ 换 embedding 模型即需全量重建(#81)⑥ Milvus 部署/连接摩擦(#215,故才有 RESTful 双实现兜底)⑦ 0.1.x 早期版本。生态定位:Milvus 在 agentic coding 时代的应用层卡位 + 获客漏斗,而非独立护城河产品。
semantic vs grep 之争(重点专节)
grep/agentic 派论据:零索引(不需建库、不会过期、永远新鲜);agent 能跟着 import/调用链多步推理定位;Amazon 论文(arXiv 2602.23368)称「关键词检索 + agentic 多步」可达 RAG ~90% 效果而无索引成本;Anthropic 自己曾用 embedding RAG 后弃用(Boris Cherny 公开说明 grep 持续更优)。
语义/向量 RAG 派论据:超大库 grep 多轮翻找耗 token;能召回命名不同但语义相近的代码(grep 字面匹配做不到);本项目 evaluation 自测 token -39.4%、tool-call -36.3% 且 F1 持平(厂商另称大库场景 +12.5% 准确率)。
适用边界(中立):小中型库 grep 完全够用且零索引/永远新鲜,上向量库是过度工程;超大/跨语言/陌生库语义检索价值显著(一次 search_code 顶多轮 grep)。代价是索引成本 + 新鲜度——merkle 增量 + 5 分钟后台 sync 正是来压这个代价的(缓解但未根除)。
趋同信号(关键观察):claude-context 本身用 hybrid(BM25 稀疏≈关键词/grep 思路 + dense 语义),且 evaluation 的增强臂是 grep + 语义并存而非语义单干。这说明实践上两派在收敛——不是「语义取代 grep」,而是「语义 + 关键词 + agentic 互补」。
客观看待自测 -40%:数字是真实跑出来的(SWE-bench Verified 30 例 × 3 次、LangGraph ReAct),但需打折:① 厂商自评、自利倾向;② 样本小(N=30)、用 GPT-4o-mini(较弱模型更易在 grep 路径上过度抓取,放大语义检索相对优势,换强模型差距可能收窄);③ F1 只是持平不是更好——省的是 token/调用次数,不是检索质量本身;④ case_study 里 django_14170「93% 省 token」是精选个例,远高于聚合 -39.4%,不应当作常态。结论:-39.4% 是诚实聚合口径,可信但有条件;93% 是 cherry-picked 展示位。
套利机会分析
- 对做代码 RAG/检索的开发者:tree-sitter AST 切分 + hybrid(BM25+dense)+RRF + merkle 增量是代码 RAG 的成熟工程参考;
@zilliz/claude-context-core可直接复用引擎自建检索应用。 - 对做数据导入管道的人:「流式分批 + 校验后持久化 + AbortSignal 协作取消」是任何「外部 API 编码→入库」的通用骨架;merkle 哈希快照 diff 增量可迁移到增量构建/同步。
- 对做 MCP 长任务工具的人:「状态快照 + 协作取消 + 重启恢复」是 MCP 长耗时异步工具的范本。
- 对评估「检索增强是否值得」的团队:
evaluation/的 grep vs 语义对照框架(SWE-bench + ReAct + 三种 MCP server)可直接借鉴。 - 对内容创作者:「Anthropic 放弃的 RAG 路 Milvus 偏要走」「semantic vs grep 之争」「向量库厂商的 agentic RAG 卡位战」三线俱全,正反双方一手资料丰富。
风险与不足
- semantic vs grep 路线未定(最大不确定性):押注的语义检索恰是 Anthropic 实测后放弃的路线;适用边界是答案——小中库 grep 够用且零索引,本项目价值在超大/跨语言库。
- 索引可靠性:#145「索引成功但检索说未索引」(33 评论)等——语义方案相对 grep 多出「会出错的索引环节」。
- 向量库锁死 Milvus/Zilliz:无 pgvector/qdrant 等后端抽象;embedding/agent 层中立,但向量库不中立(商业落点)。
- embedding 绑定成本:换 provider/模型即维度变、collection 不兼容、需全量重建索引(#81)。
- Milvus 部署摩擦:自建/托管向量库 + embedding 的部署复杂度(#215/#170),正是 grep 派强调的 setup 成本。
- 工程成熟度:0.1.x 版本;CI 只跑 build 不跑测试/lint(lint 被注释);merkle 实为扁平非真分层 diff;RRF k=100 写死。
- 厂商自测口径:-40% 省 token 是单方数据(N=30、GPT-4o-mini、F1 仅持平),93% 是精选个例。
行动建议
- 用它:
claude mcp add接入 Claude Code/Cursor 等;配 Zilliz Cloud(免费档)或自托管 Milvus + embedding(OpenAI/Voyage code-3/Ollama 本地)。先评估代码库规模——小中库 grep 可能已够,超大/跨语言库再上语义检索。 - 学它:精读
packages/core/src/context.ts(索引编排)+splitter/ast-splitter.ts(AST 切分)+sync/merkle.ts(增量)+vectordb/milvus-vectordb.ts(hybrid+RRF)+evaluation/(grep vs 语义评测方法论)。 - fork 它:MIT 可二次开发;
@zilliz/claude-context-core可单独取引擎;若要换向量库需自行抽象(当前锁 Milvus)。 - 客观看卖点:-40% 省 token 有条件可信、F1 仅持平;merkle 是快速门闸非真分层;semantic vs grep 看代码库规模定。
知识入口
| 入口 | 链接 | 用途 |
|---|---|---|
| GitHub 仓库 | https://github.com/zilliztech/claude-context | 源码 / Issue |
| 官方文档 | 仓库 docs/(getting-started / dive-deep / troubleshooting) | 用法 + 配置 |
| 评测框架 | 仓库 evaluation/(SWE-bench + grep vs 语义 case_study) | 论证价值的一手数据 |
| 语义派立场 | Milvus 博文「Why I’m against Claude Code’s grep-only retrieval」 | semantic 派论据 |
| grep 派立场 | Amazon Science arXiv 2602.23368 + Boris Cherny「Claude Code 弃用 RAG」 | grep 派论据 |
| 核心源码 | packages/core/src/context.ts / splitter/ / sync/merkle.ts / vectordb/ | 架构研读起点 |
| 生态底座 | Milvus(github.com/milvus-io/milvus)/ Zilliz Cloud | 向量库 |