⏳ 公众号待发布
GitHub推荐:5 个月 44K stars:A 股散户的「个人 AI 研究操作系统」daily_stock_analysis 怎么做到跨市场 × 跨 LLM × 跨推送
一句话总结
一个独立开发者 5 个月内写成的「端到端 A 股 AI 决策工作流」:跨 A/HK/US/ETF 四大市场 + 6 档数据源自动降级 + 15 份 YAML 策略驱动多 LLM 协作 + 多渠道推送 + 决策纪律硬约束(防追高),定位是散户/工程化玩家的「个人 AI 研究操作系统」。
值得关注的理由
- 罕见的细分交集:自部署免费 LLM 决策 + 跨市场 + 多渠道推送 + YAML 策略可热加载,四个维度同时在开源侧没有直接竞品
- 工程化颗粒度极高:熔断+字段补齐+多层 guardrail+partial dashboard+模块级缓存——这套模式可整体迁移到任何「LLM 拉取外部数据 + 决策 + 推送」的应用
- 作者已产品化(不是个人玩具):27 个 release、132 个 tag、Web 工作台 1,265 次变更、11 条 CI workflow、201 个测试文件、多语言(zh-CN/en/ja)完整文档
项目展示
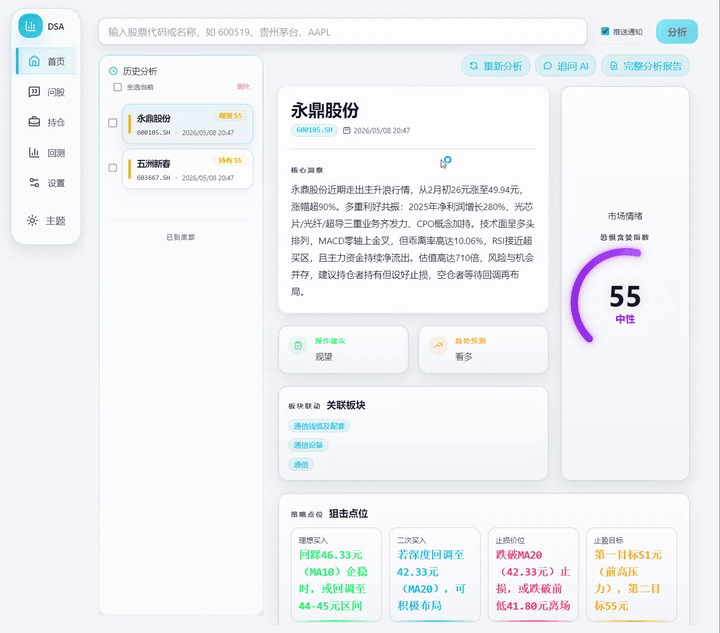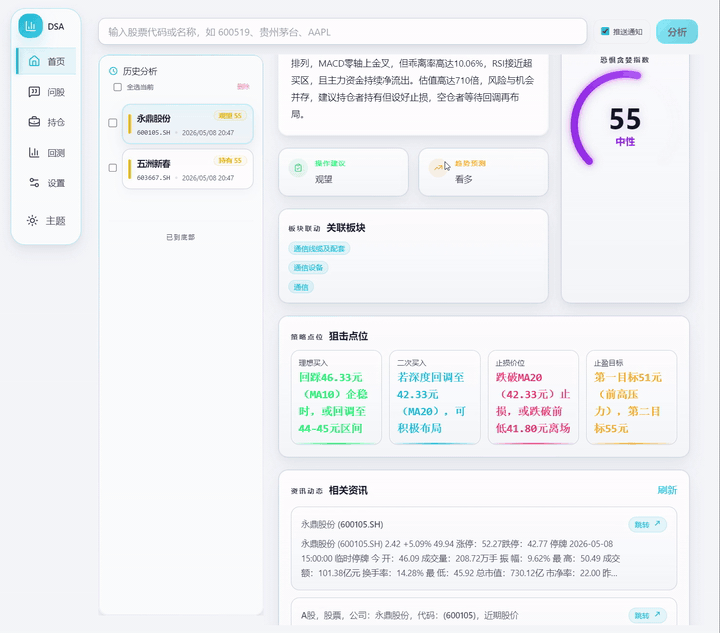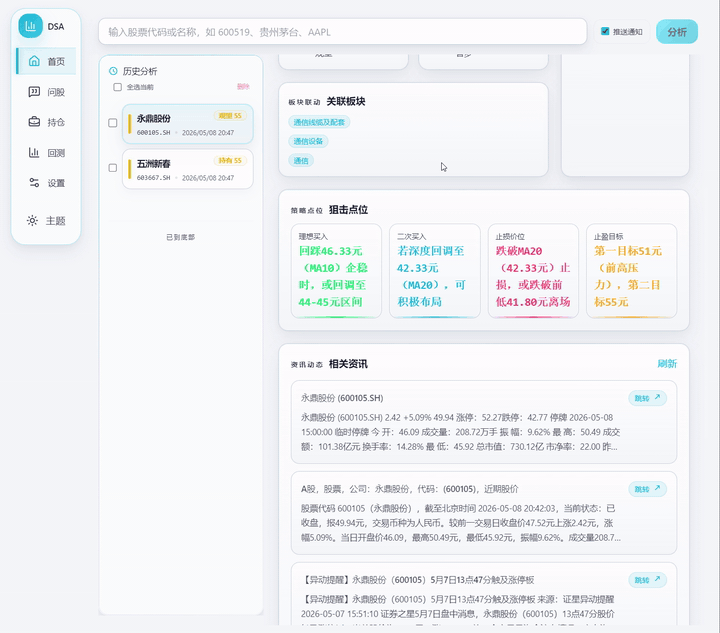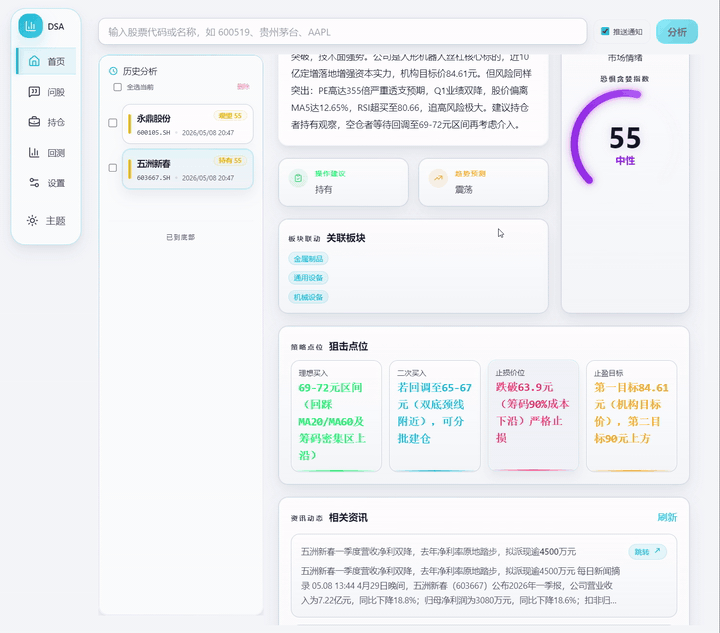
(DSA Web 工作台演示:自选股研究 + AI 报告 + 决策仪表盘一站式)
注:仓库 README 主要是 Anspire / SerpApi 赞助 banner 与小红书私域引流二维码,工具性展示仅此一张 GIF。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/zhulinsen/daily_stock_analysis |
| Star / Fork | 44,663 / 41,491(Fork/Star 92.9%,需警惕僵尸 fork/营销号 Star 通胀) |
| 代码行数 | 294,099 行(Python 60.7% / JSON 17.1% / TSX 13.4% / TS 6.3%) |
| 项目年龄 | 5.3 个月(首 commit 2026-01-10) |
| 开发阶段 | 密集开发(5 个月 798 commits,最近 30 天 140 commits) |
| 贡献模式 | 独立开发者主导(作者 48.3% + AutoCode Bot 14%),人类核心圈 6-8 人 |
| 热度定位 | 大众热门(准头部 A 股 AI 决策开源项目) |
| 质量评级 | 代码 良好 / 文档 优秀 / 测试 充分 / CI 完善 |
作者视角:为什么存在这个项目
创始人/作者背景
zhulinsen(mumu),7.8 年 GitHub 账号,bio 是「LLM | AIGC | Robotics」,946 followers,37 个公开 repo。他的工作不是单点项目,而是一条自研产品线:
- alphasift(192⭐)— 选股发现层(上游)
- alphaevo(96⭐)— 策略自进化(下游消费)
- MiniAgent(156⭐)— 底层 agent 框架
- daily_stock_analysis(44K⭐)— 日终决策仪表盘 + 多渠道推送(应用层)
这个仓库在产品线中位置很清晰:「选股 → 深入分析 → 回测进化」的中间一环,把上游发现的标的物化、可消费化、可推送化。
问题判断
作者看到的是一个商业和开源的四不管地带:
- 商业终端(iFinD/Wind/Choice)数据非 LLM 友好、价格数千到数万、闭源
- C 端 AI 投顾(雪球/问财/晓蜜)输出非结构化、不可二次消费、缺跨市场流水线
- 开源量化框架(TradingAgents/Qlib/Backtrader)研究严谨但缺 LLM 决策 + 推送
- 私域 AI 炒股课/Agent 是黑盒,跑路风险高
DSA 的位置:「工程化颗粒度极强但算法不创新」,占住「数据拉得到 + 决策看得懂 + 推得到手」的三边空白。
解法哲学
三条取舍很硬的路线,写在代码里也写在文档里:
- Unix 拼装 > 大而全:6 档数据源降级链 + 多 LLM 适配 + 多渠道推送,每一层都允许单独替换
- 诚实失败 > 美化曲线:决策 guardrail 四层(market_phase / daily_context / structure / risk_override)后置在 LLM 输出上,宁愿说”不适合操作”也不给出可执行建议
- 明确不做:不实盘、不重写回测(用姊妹 alphaevo 替代)、不商业化核心代码
战略意图
- Open-core 主体 + 赞助:Anspire / SerpApi / AIHubMix 三个外部服务在 README 顶部高调占位
- 私域流量:小红书 + 微信群作为用户增长
- 部署咨询:文档里给企业部署指南(部署文档 1698 行),把个人项目做成 B 端入口
- 路线图串「日终→盘中实时化」:四条 XL issue(#1200 渠道网关、#1202 实时告警、#1386 盘中盘前 2.0、#1180 LLM 配置中心)从日终决策向盘中实时演进
核心价值提炼
创新之处(按新颖度 × 实用性排序)
- YAML 策略 → Prompt + Tool + 多 Agent 路由(★ 高迁移):15 份 YAML 既声明 prompt 注入片段,又声明 tool 调用白名单,由
SkillRouter选 3 个 specialist agent 并发执行 - 多层决策 Guardrail(★ 高迁移):四层后置校验在 LLM 输出上做”诚实失败”,比单纯 prompt 加约束更鲁棒
- 跨市场 × 跨 LLM × 跨推送统一 Pipeline(★ 高复用):同一套 pipeline 跑 A/HK/US/ETF + Gemini/Claude/DeepSeek/OpenAI/Qwen/Ollama + 12 个 bot 平台
- 熔断 + 字段补齐 + 7 字段兜底(★ 高复用):单数据源失败不阻塞全流程,缺失字段有占位补齐
- ToolRegistry + SkillManager 模块级缓存(★ 高复用):一次性构建 + deepcopy 复用,避免每次 agent 调用重新实例化
- 多市场日历 + partial bar 补齐(★ 中高复用):实时 quote 覆盖/追加今日 K 线,
is_estimated=True标识,下游识别 partial - 本地资讯池 + 符号多形式 lookup(★ 中复用):6+ 种形式(代码/简称/拼音/全称)归一化匹配,本地持久化 intelligence 拼进 prompt
- 报告完整性校验(
agent_weak模式):当主 LLM 失败时降级到弱模型做完整性校验,比静默失败更可观测
可复用的模式与技巧
| 模式 | 在本项目的位置 | 适用场景 |
|---|---|---|
| Strategy + Manager + CircuitBreaker + Field Supplement | data_provider/base.py 3.5K 行 | 任何「多外部 API + 自动降级」场景 |
| YAML → Prompt + Tool 注入 | strategies/*.yaml + src/agent/skill_router.py | 任何「业务策略需要可视化编辑 + LLM 注入」 |
| 多层 Guardrail | src/agent/orchestrator.py::_apply_risk_override | 任何「LLM 输出必须经过业务规则硬约束」 |
| partial dashboard + 占位补全 | src/services/report_* | 任何「数据可能缺失但 UI 不能崩」 |
| 多市场交易日历 + partial bar | src/core/calendar.py + data_provider/akshare/tdx | 任何「多市场 + 盘中实时」 |
| 多渠道通知路由 + 降噪 | bot/dispatcher.py + dedup/cooldown/quiet hours | 任何「一事件多渠道 + 不想轰炸用户」 |
| ToolRegistry + SkillManager 模块级缓存 | src/agent/factory.py | 任何「agent 工具调用频繁需复用实例」 |
关键设计决策
| 决策 | 做什么 | 牺牲什么 | 评价 |
|---|---|---|---|
双轨分析(analyzer 单 LLM vs agent_orchestrator 4 模式) | 简单场景快路径 + 复杂场景多 agent | 两套 prompt + 两套归一化 | 必要 evil,但应整合 prompt schema |
| 决策 Guardrail | 防 LLM 给出违反交易纪律的建议 | 与 LLM 灵活性矛盾 | 核心护城河,是产品定位的边界 |
| Pipeline 单类巨构 | pipeline.py 3.5K 行单类承担全链路 | 难单测隔离 | 当前是负债,未来要拆 |
| 多市场单 Pipeline | 同一份代码适配 4 个市场 | 客户端维护成本(A/HK/US 时区+规则差异) | 值得,跨市场是核心卖点 |
| 通知路由三类型(report/alert/system_error) | 降噪不打扰 | 配置面广(~30 env) | 值得,噪音是推送系统最大杀手 |
竞品格局与定位
竞品对比矩阵
| 维度 | DSA(本项目) | iFinD/Wind/Choice | 雪球/问财/晓蜜 | TradingAgents/Qlib/Backtrader | 私域 AI 课/Agent |
|---|---|---|---|---|---|
| 价格 | 免费(自部署 LLM 成本) | 数千–数万/年 | 免费 + 增值 | 免费 | 数百–数千元/年 |
| 跨市场 | A/HK/US/ETF | A/HK/US/基金 | A 为主 | A/HK/US 学术为主 | A 为主 |
| LLM 决策 | 多模型可换 | 无 | 内置单一模型 | 框架支持需自己接 | 黑盒 |
| 结构化输出 | JSON 报告 + 检查清单 | 无 | 非结构化文本 | 因子/回测 | 黑盒 |
| YAML 策略可编辑 | ✅ 15 份热加载 | ❌ | ❌ | 配置文件非策略 | ❌ |
| 推送渠道 | 12 个 bot 平台 | App 推送 | App 推送 | 无 | 微信群 |
| 数据准确性 | 多源降级 + 兜底 | ★★★★★ | ★★★★ | ★★★★★(学术) | ★★ |
| 学术严谨性 | ★★ | ★★★★ | ★★ | ★★★★★ | ★ |
| 可二开性 | ★★★★★ | ❌ 闭源 | ❌ | ★★★★ | ❌ |
| 移动端 | 桌面/Web | 完整 | 完整 | 无 | 微信群 |
差异化护城河
- 五维联动:多源 + 多 LLM + 多渠道 + 多 Agent + 多市场在一个 YAML 文件里可配置,竞品拆成五件事
- 诚实 Guardrail:竞品要么没 LLM(商业终端)要么黑盒(私域课),DSA 把「为什么不敢给建议」写进代码
- 完整生态位:上承 alphasift 选股 + 下接 alphaevo 回测 + 自身负责「日终决策仪表盘 + 多渠道推送」,作者一条产品线通吃
竞争风险
- 最大替代者不是同型项目,而是「LLM 框架 + 金融提示词 + 推送 bot」的快速 fork——任何一个有 Web 工作台的 AI agent 框架接上金融 prompt 就能复刻 80%
- 商业终端(iFinD/Wind)不会下探到散户自部署市场,但机构版若推出 LLM 友好数据接口,机构端会流失
- 私域 AI 课如果把「多市场 + 多 LLM」做进产品化(不只是文档营销),会切走一部分”不想写代码”的散户
生态定位
A 股散户 + 工程化玩家的「个人 AI 研究操作系统」——上承选股发现(alphasift),下接回测进化(alphaevo),自身承载「日终决策仪表盘 + 多渠道推送」。填补了**「免费 + 跨市场 + LLM 决策 + 可二开」四象限交集**的空白。
套利机会分析
- 信息差:5.3 个月龄 44K stars 但单 maintainer 占比 50.6%,招人 issue (#232) 已 stale——项目治理风险 vs 流量价值存在套利窗口期(半年内不解决,Star 增速会断档)
- 技术借鉴:6 档多源降级链 + 多层 guardrail + ToolRegistry 模块级缓存这三个模式直接可迁移到任何「LLM 拉数据 + 决策 + 推送」的应用层项目(不限于金融)
- 生态位:填补「A 股散户 + 自部署 + LLM 决策」三交集,工程化玩家红利期约 6-12 个月
- 趋势判断:A 股散户对 LLM 决策的需求在 2026 年刚进入从尝鲜到依赖的拐点,AGI 概念 + 个人理财双轮驱动,DSA 在 5 个月内做到 44K star 印证需求真实
- 后发优势判断:单 maintainer 是最大瓶颈,谁能 fork 出「多 maintainer + 文档英文版 + SaaS 化」就有后发优势
风险与不足
- 单点维护风险(高):作者本人 + AutoCode Bot 占 ~60% commits,Issue #232(核心维护者招募)已 stale——这是项目最大的非技术风险
- 架构中心化(中):
main.py56KB(56,014 字节)+pipeline.py3.5K 行单类承担全链路,测试覆盖率再高也难解耦 - 数据源契约脆弱(中):Issue #867 显示加一个 fetcher 改 4-5 处,6 档降级链是双刃剑
- YAML 表达力有限(低):无循环/条件,复杂策略仍需改 Python
- 双轨 prompt/归一化分裂(中):
analyzer与agent_orchestrator两套 prompt schema,bug 修复要改两遍 - 本地资讯池语义模糊(中):
intelligence拼进 prompt 时未区分「强信号 vs 候选证据」,旧数据可能误导 LLM - 海外强依赖 YFinance(中):海外数据源仅 YFinance 一档,无降级
- Sponsor 显式(低):Anspire/SerpApi/AIHubMix 在 README 顶部高调占位,社区治理偏中国式私域(小红书 + 微信群)
- Fork/Star 异常比 92.9%(高警示):fork 数量接近 star,说明大量僵尸 fork/营销号操作,Star 通胀需警惕
- 回测轻量(低):深度回测需切姊妹 alphaevo
行动建议
如果你要用它
- 个人散户/工程化玩家:✅ 推荐作为日常自选股研究助手,前提是你能接受 LLM token 成本和每周 1-2 次数据源适配更新
- 机构研究员:⚠️ 数据质量/SLA 不达标,仅作个人效率工具,不进生产
- 量化策略研发:✅ 用 DSA 跑日终筛选 + 推送通知 + 跨市场覆盖,把回测和因子研究留给 alphaevo 或 Qlib
如果你要学它
按这个顺序读:
- README.md + docs/full-guide.md(1698 行,部署/配置/二次开发一站式)
main.py(56KB,CLI/API/WebUI 三模式入口,看完对整体架构有图)src/core/pipeline.py(3.5K 行,全链路核心)src/agent/orchestrator.py(4 模式多 agent 编排 + 4 层 guardrail)strategies/*.yaml(15 份策略,看 prompt+tool 注入范式)data_provider/base.py(6 档降级链 + 熔断 + 字段补齐的工程化范本)
如果你要 fork 它
最有价值改进方向:
- 拆 pipeline.py 为「数据 → 分析 → 决策 → 推送」四个微服务,单点风险出问题时能热重启
- 统一 analyzer 与 agent_orchestrator 的 prompt schema,消灭双轨分裂
- 加回测独立模块,让 DSA 自身能闭环(DSA → 回测 → 优化策略 → DSA),把 alphaevo 收进来
- 英文 i18n 完善,目前 99% 文档是中文,海外用户门槛高
- 多 maintainer 招募 + 治理规则(CONTRIBUTING.md + RFC 流程),把 #232 stale 的招人 issue 重启
- 数据源适配层抽象成插件协议,Issue #867 那 4-5 处改动应能收敛到 1 处
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/ZhuLinsen/daily_stock_analysis |
| Zread.ai | 未收录(DeepWiki 已覆盖) |
| 关联论文 | 无(姊妹项目 AlphaEvo 引用 FunSearch/OPRO/Voyager) |
| 在线 Demo | 无 SaaS Demo(仅本地 WebUI 127.0.0.1:8000) |
| 视频教程 | BV11FEb66EXG / BV11FEb66Eyr |
| 姊妹项目 | AlphaSift / AlphaEvo / MiniAgent |
相关报告
MaxKB
⭐ 20.6k Python AI AgentLLM 框架开发者工具
GitHub 推荐:8.5K stars 严重低估:checkout 撑起 95% GitHub workflow 的真相
⭐ 8.5k TypeScript 开发者工具协议与规范安全 已发布
Google 工程总监的 23 份 SKILL:3.7 个月把 49.7K Star 拉爆的"工程纪律即 prompt"
⭐ 49.7k Shell AI AgentAI 编程开发者工具 已发布
SpotiFLAC
⭐ 6.6k Go 开发者工具音视频
GitHub 推荐:54K stars 的孤勇者:Motrix 用 31 个月沉默换一次 v2 turbo 重写
⭐ 54.0k TS AI Agent开发者工具协议与规范 已发布
GitHub推荐:Google 4 个月孵化的 Agent 基质:3K stars 拿下 10x 密度提升的运行时赌注
⭐ 3.0k Go AI AgentLLM 框架开发者工具 已发布