Tracy Profiler 深度分析报告
GitHub: https://github.com/wolfpld/tracy
一句话总结
C/C++ 领域最强大的开源实时帧级性能分析器,以纳秒级插桩开销(~2.25ns/zone)和全栈覆盖(CPU+GPU+内存+锁)著称,近期率先集成 LLM 辅助性能分析。
值得关注的理由
- 技术深度标杆:31.5 万行 C++ 由一人主导 8.5 年,从 x86
rdtsc汇编到 LLM Tool Use 的全栈工程,是学习极致性能优化的活教材 - 细分赛道王者:15.5K Stars,在 C/C++ 实时帧级 profiler 中无对等开源竞品,被 Google (IREE)、NVIDIA (Isaac Sim)、React Native 等大厂/项目集成
- LLM 集成先驱:已知最早将 LLM 直接嵌入 profiler GUI 的工具,展示了开发工具 + AI 的前沿实践
项目展示
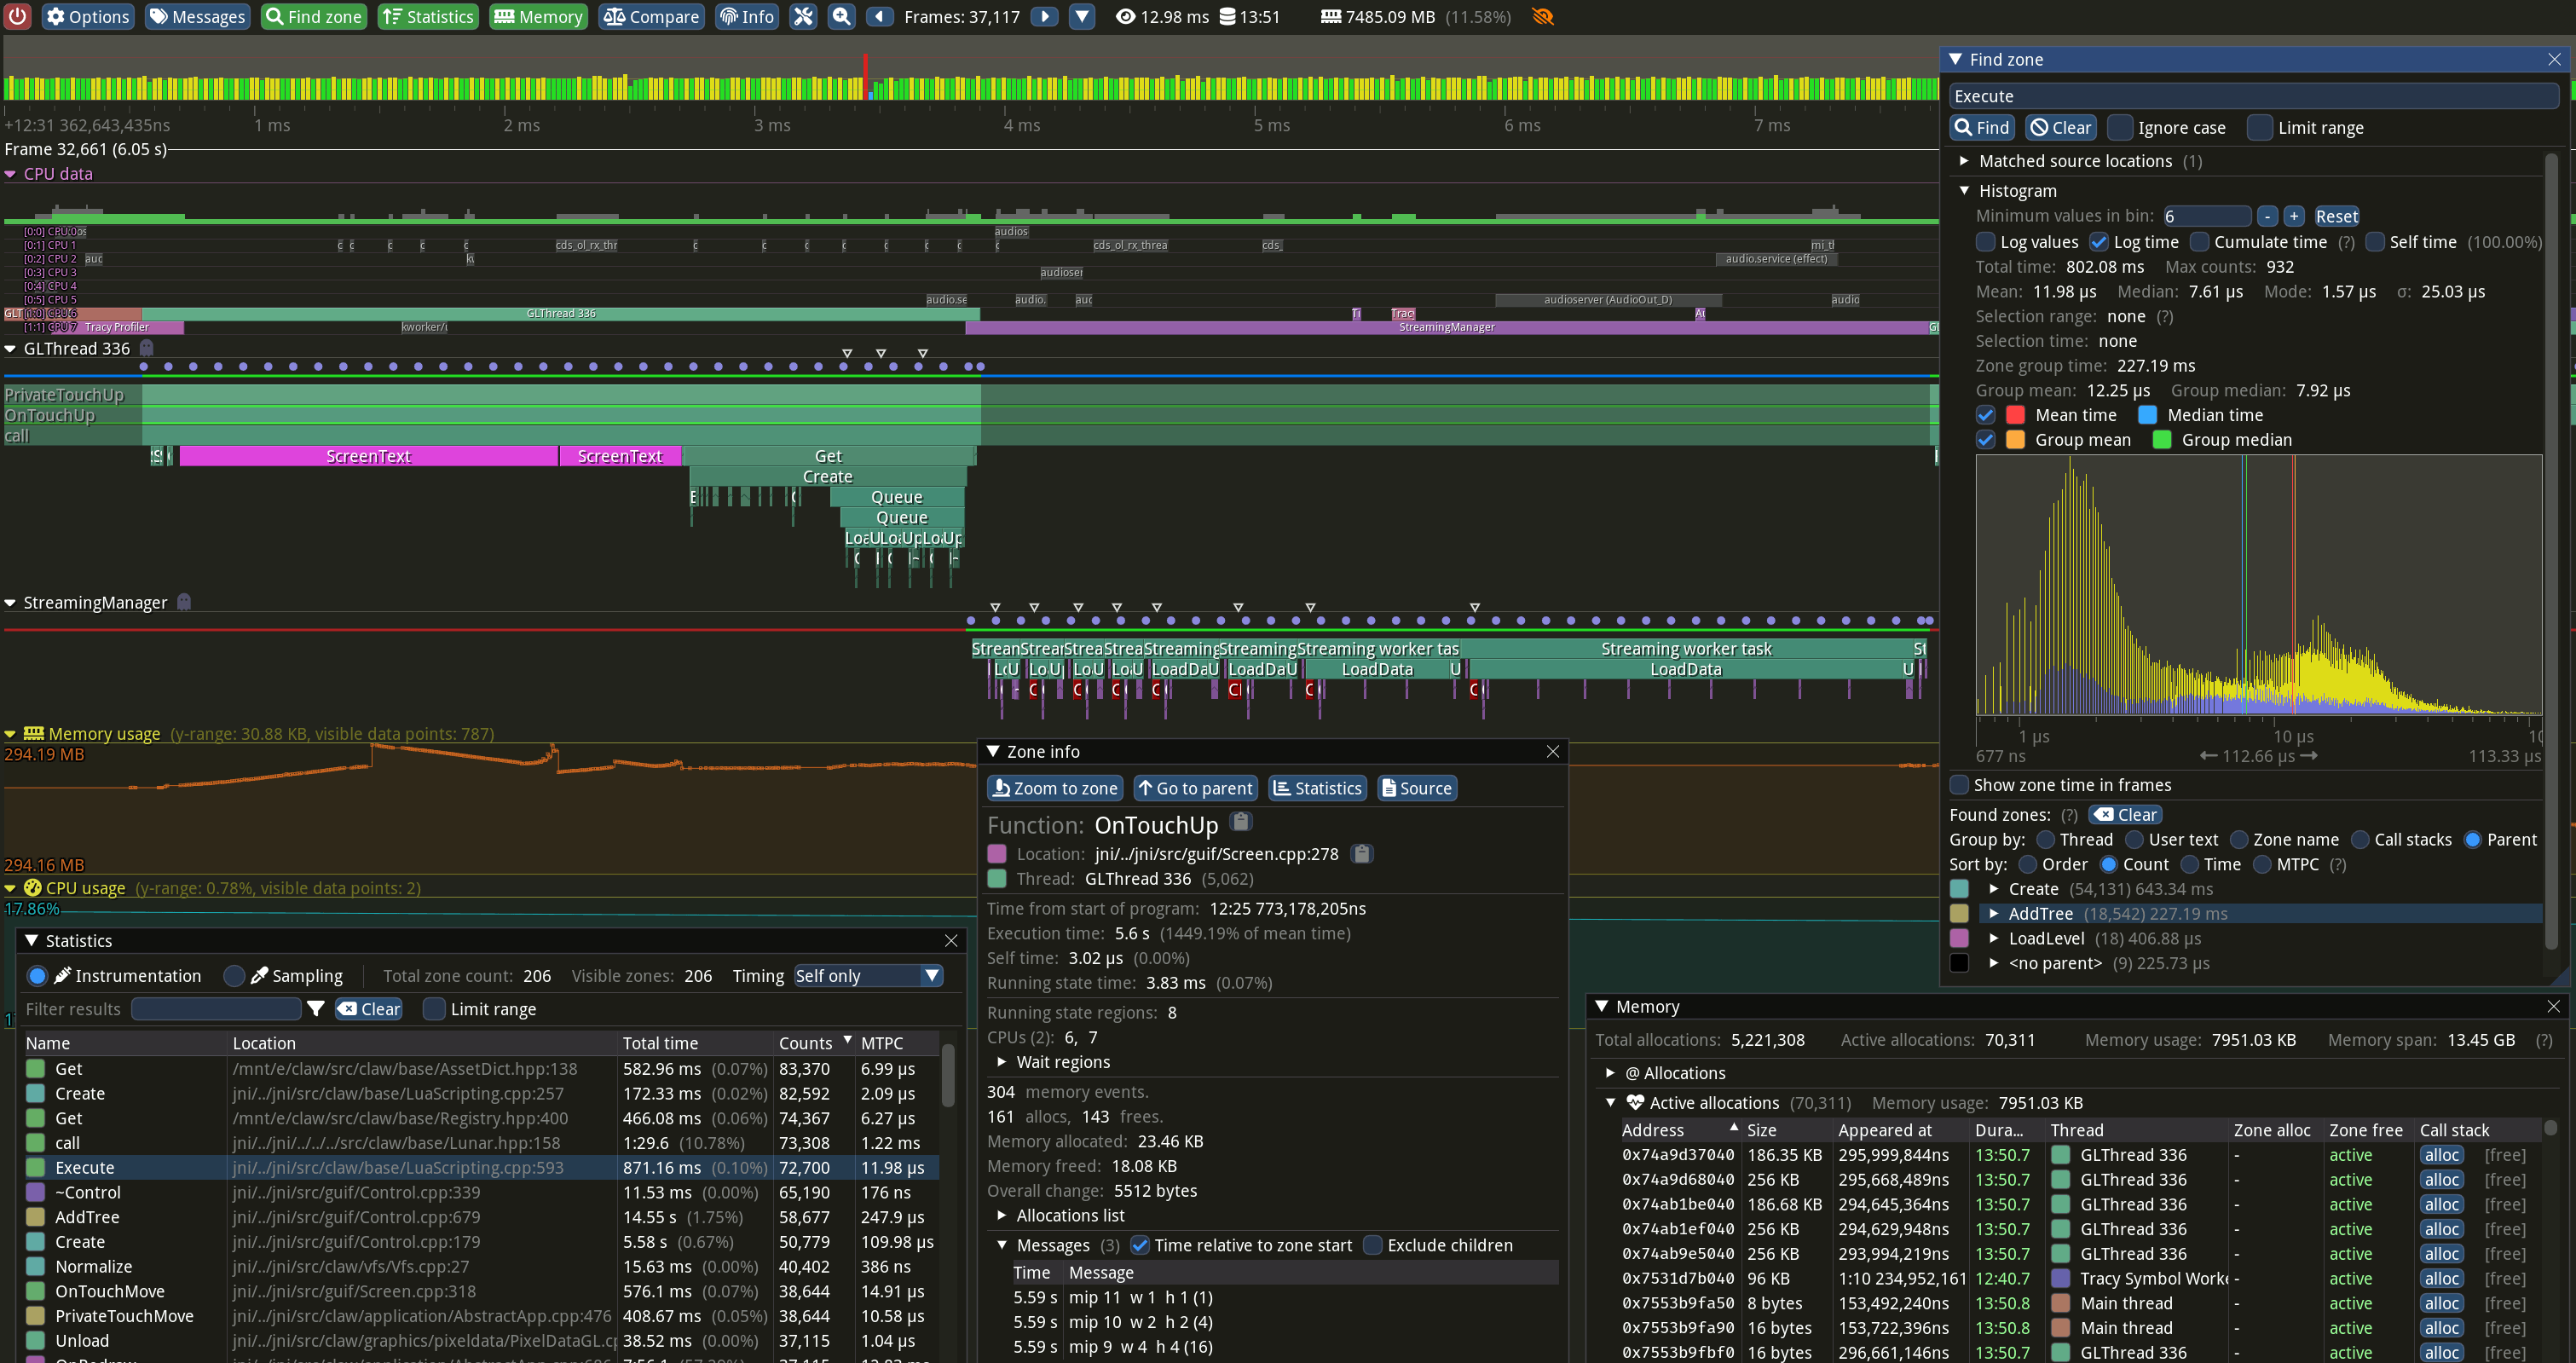
Tracy 的时间线视图,展示 CPU zone、GPU timeline、帧标记等多维性能数据的实时可视化。

详细分析模式,包括 zone 统计、调用栈、内存分配追踪等功能。
在线 WebAssembly Demo | CppCon 2023 演讲视频
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/wolfpld/tracy |
| Star / Fork | 15,497 / 1,033 |
| 代码行数 | 315,714 (C++ 83.0%, C Header 7.2%, C++ Header 5.4%, TeX 1.3%) |
| 项目年龄 | 102 个月(首次提交 2017-09,GitHub 创建 2020-03) |
| 开发阶段 | 成熟活跃期(v0.13.1,近 30 天 69 次提交) |
| 贡献模式 | 单人绝对主导(Bartosz Taudul 占 88.5%,共 9,757 次提交) |
| 热度定位 | 大众热门(15.5K Stars) |
| 质量评级 | 代码[优秀] 文档[优秀] 测试[不足] |
作者视角:为什么存在这个项目
创始人/作者背景
Bartosz Taudul(@wolfpld),15 年 GitHub 账龄的资深 C++ 性能工程师,专注于游戏开发领域的底层优化。其他项目(etcpak 纹理压缩器、vv 图片查看器)均为高性能 C++ 工具,揭示一致的问题发现模式:在生产环境中发现工具不存在或不够好,然后自己造一个极致性能的替代品。CppCon 2023 受邀演讲,活跃于 Mastodon gamedev.place 社区。
问题判断
传统 profiler 存在根本性缺陷:(1) 采样型(gprof/perf)无法追踪特定代码路径的精确耗时;(2) 动态插桩(Valgrind)开销 10-100 倍,无法在游戏帧率下使用;(3) 商业工具(Superluminal、VTune)平台受限且昂贵;(4) 没有开源方案能同时覆盖 CPU zone、GPU timeline、内存分配、锁竞争、上下文切换五个维度。游戏开发需要一个能在生产环境常开、开销极低的全栈 profiler。
解法哲学
「零妥协的极致工程」:
- 做:开销最小化至硬件极限(
rdtsc直读、编译期元数据、lock-free 队列叠加优化);全栈一体化覆盖 CPU/GPU/内存/锁/帧图像;实时远程 client-server 架构;零依赖客户端(仅需 C++11) - 不做:不做「只解决一个子问题」的工具;不接受任何可避免的运行时开销;不为兼容性牺牲性能(客户端 C++11,GUI 自由使用 C++20)
战略意图
Tracy 正从 「性能 profiler」 演进为 「AI 辅助的性能分析平台」:
- v0.12 (2025-05): 火焰图、Metal/CUDA GPU 支持
- v0.13 (2025-11): LLM 集成 — 可向本地 LLM 询问调用栈含义、汇编优化建议
- vNext (2026): 扩展 LLM 工具集(Wikipedia、web search、source code 查看)
Taudul 意识到:性能数据的采集已基本解决,瓶颈在于理解和分析。纯个人激情项目,无商业化意图,BSD 3-Clause 许可商业友好。
核心价值提炼
创新之处
-
纳秒级插桩开销的工程极限(新颖度 5/5 | 实用性 5/5 | 可迁移性 4/5) ~2.25ns/zone 不是单一技巧而是多层优化叠加:硬件计时器直读 +
static constexpr源码位置 +tracy_force_inline+ lock-free enqueue +MemWrite直接写入。这种「每一层都追求零开销」的叠加方法论本身就是可学习的。 -
LLM 辅助性能分析(新颖度 5/5 | 实用性 4/5 | 可迁移性 4/5) 已知最早将 LLM 嵌入 profiler GUI 的实现。12+ 个 Tool Use 定义、隐私保护(区分私有代码/公开库)、双模型架构(推理模型 + 快速模型)、向量检索手册。代表了开发工具 + AI 集成的前沿实践。
-
全 GPU API 统一追踪(新颖度 4/5 | 实用性 5/5 | 可迁移性 3/5) OpenGL/Vulkan/D3D11/D3D12/Metal/OpenCL/CUDA/ROCm 统一 API。Metal 后端的双缓冲 timestamp 池、CUDA 的增量线性回归 CPU-GPU 时间校准尤其精巧。
-
编译期禁用的零成本抽象(新颖度 3/5 | 实用性 5/5 | 可迁移性 5/5)
TRACY_ENABLE未定义时所有宏展开为空,TracyLockable退化为原始 mutex,运行时开销严格为零。精心设计的双层宏确保两种模式都能编译通过。 -
Patchable Nopsleds(新颖度 4/5 | 实用性 3/5 | 可迁移性 2/5) 在
rdtsc前插入 5 字节 NOP 使 rr 等记录-回放调试器能安全 patch。底层系统编程中罕见的跨工具协作设计。
可复用的模式与技巧
- 「双队列」遥测模式:高频无序事件用 lock-free MPMC queue,低频有序事件用 serial queue + spinlock — 适用于任何高吞吐 telemetry/logging 系统
- 「编译期元数据 + 运行时指针」模式:
static constexpr结构体 + 运行时仅写指针(8 字节)— 适用于日志、APM、trace 系统 - LZ4 流式压缩网络传输:256KB 帧 + 4 字节长度前缀 — 实时数据传输的通用模式
- rpmalloc 隔离分配:嵌入式库使用独立的线程本地分配器 — 任何嵌入到第三方应用的 SDK
- Slab + Short Pointer 内存优化:slab 分配器 + 6 字节压缩指针 — 海量小对象存储场景
- LLM Tool Use + 隐私保护集成模式:system prompt 明确隐私边界、区分本地/网络工具 — 未来开发工具集成 AI 的参考架构
关键设计决策
- Lock-Free 双队列数据通道:并发 zone 事件走
moodycamel::ConcurrentQueue无锁入队,锁/GPU 事件走SPSCQueue保序。复杂度换来接近零锁竞争的吞吐量。 - 硬件计时器直接读取:x86
rdtsc、ARM64CNTVCT_EL0、macOS ARM64 内联汇编。需处理 TSC 不稳定、跨核漂移、频率校准等复杂性。 - 客户端 C++11 / GUI C++20:「接口层向下兼容,实现层用最新标准」的库开发最佳实践。
竞品格局与定位
竞品对比矩阵
| 维度 | Tracy | KDAB/hotspot | google/orbit | easy_profiler | Superluminal |
|---|---|---|---|---|---|
| Stars | 15,497 | 5,016 | 4,319 | 2,346 | 商业 |
| 方法 | 插桩+采样混合 | 纯采样(perf) | 采样+插桩 | 纯插桩 | 纯采样 |
| 平台 | 跨平台 | 仅 Linux | Linux+Win | 跨平台 | 仅 Windows |
| GPU 追踪 | 全 API (8 种) | 无 | 部分 | 无 | 无 |
| 实时性 | 实时远程 | 离线 | 实时 | 离线 | 实时 |
| LLM 集成 | 已内建 | 无 | 无 | 无 | 无 |
| 内存/锁分析 | 均有 | 无 | 仅内存 | 无 | 无 |
| 开销 | ~2.25ns/zone | 0(采样) | 低 | 中 | 0(采样) |
差异化护城河
- 全栈覆盖:唯一同时覆盖 CPU zone + 采样 + 8 种 GPU API + 内存 + 锁 + 上下文切换 + 帧图像的开源工具
- 8,633 次 commit 的深度积累:单人 8.5 年的持续投入使竞争者几乎无法复制
- 多语言绑定生态:Rust、Zig、C#、Odin、OCaml 等绑定扩大了用户基础
竞争风险
- 采样型工具的零侵入优势:对于不想修改源码的用户,hotspot/Superluminal 无需插桩
- Google Perfetto 的平台优势:如果 Perfetto 向游戏场景扩展,其 Google 背书可能吸引企业用户
- Bus Factor = 1:单人维护的最大风险是维护者退出
生态定位
在 C/C++ 性能分析工具生态中占据 「高性能游戏/实时应用 profiler」 的核心位置,是该细分赛道的事实标准。通过多语言绑定向 Rust/Zig 等新兴系统语言生态扩展。
套利机会分析
- 信息差: 无明显信息差 — 项目已被充分发现(多次登上 Hacker News 首页),15.5K Stars 反映真实价值
- 技术借鉴: 极高。(1) lock-free 双队列遥测模式可用于任何高吞吐数据采集系统;(2)
static constexpr+ 指针写入的零开销元数据采集模式适用于日志/APM;(3) LLM Tool Use + 隐私保护的集成模式是开发工具嵌入 AI 的参考架构;(4) 6 字节short_ptr压缩指针适用于海量小对象场景 - 生态位: C/C++ 实时帧级 profiler 的绝对标杆,填补了「零开销 + 全栈 + 实时远程」的空白
- 趋势判断: 稳步增长(~9 star/天),LLM 集成是明确的增长催化剂。AI 辅助开发工具是大趋势,Tracy 抢占了先机
风险与不足
- Bus Factor = 1:88.5% 代码由一人贡献,维护者退出将导致项目停滞
- 测试覆盖不足:仅一个
test.cpp综合测试文件(~400 行),无单元测试框架 - 构建系统复杂:Issue #707(47 条评论)反映 CMake 配置是社区最大痛点
- 侵入性:需修改源码插桩,采样模式只能部分缓解
- 非 MSVC 编译器支持:Windows 上 GCC/Clang 编译仍有 Issue #1056 待解决
- 代码注释率低:20.9:1 代码注释比,但有 LaTeX 手册补充
行动建议
- 如果你要用它: 如果你做游戏或高性能 C/C++ 应用且需要精确到 zone 级别的实时分析,Tracy 是唯一选择。如果只需采样级概览且不想改代码,考虑 hotspot (Linux) 或 Superluminal (Windows)
- 如果你要学它: 重点关注 (1)
public/client/TracyProfiler.cpp— 客户端核心,lock-free 队列和硬件计时器实现;(2)public/common/TracyQueue.hpp— 事件队列协议定义;(3)server/TracyWorker.cpp— 8,792 行的服务端数据处理引擎;(4)profiler/src/profiler/TracyLlm.cpp— LLM 集成架构 - 如果你要 fork 它: (1) 改进构建系统(CMake 现代化);(2) 增加自动化测试覆盖;(3) 增加 Web UI 版本(当前 GUI 仅桌面端)
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/wolfpld/tracy |
| Zread.ai | https://zread.ai/wolfpld/tracy |
| 关联论文 | 无 |
| 在线 Demo | https://tracy.nereid.pl/ (WebAssembly 交互式 Demo) |