GitHub 推荐:code-review-graph:21k Stars 用一张图让 AI 只读 1% 代码,单人 4 个月干出来的本地代码知识图谱
一句话总结
把仓库预先解析成一张持久化的本地图,让 Claude/Cursor/Codex 只读 blast radius 相关的最小上下文——大 monorepo 评审 token 消耗平均下降 38 倍,最高 528 倍。
值得关注的理由
- 赛道头部 + 真实基准:4.7 个月冲到 21k stars,月均 152 commits,14 个 AI 客户端统一接入;用
cl100k_base真实 tokenizer 校准而非营销话术。 - 「AI 评审专用」定位精准:在「RAG / LSP / grep / 全量打包」四象限里,填补了「跨语言结构化 + 持久 + 评审专用 + token 可观测」这个空白——GitNexus(浏览器 WASM)、Serena(LSP 编辑)、jcodemunch(纯 AST 检索)都只占一格。
- 工程化细节稀缺:disposable subprocess 探活加载 Tree-sitter grammar、跨平台 process/thread executor 自动切换、
context_savings主动 attach 到 MCP 响应、confidence tier 三档外显——这些是「不只是 README 漂亮,是真把坑踩完」的信号。
项目展示
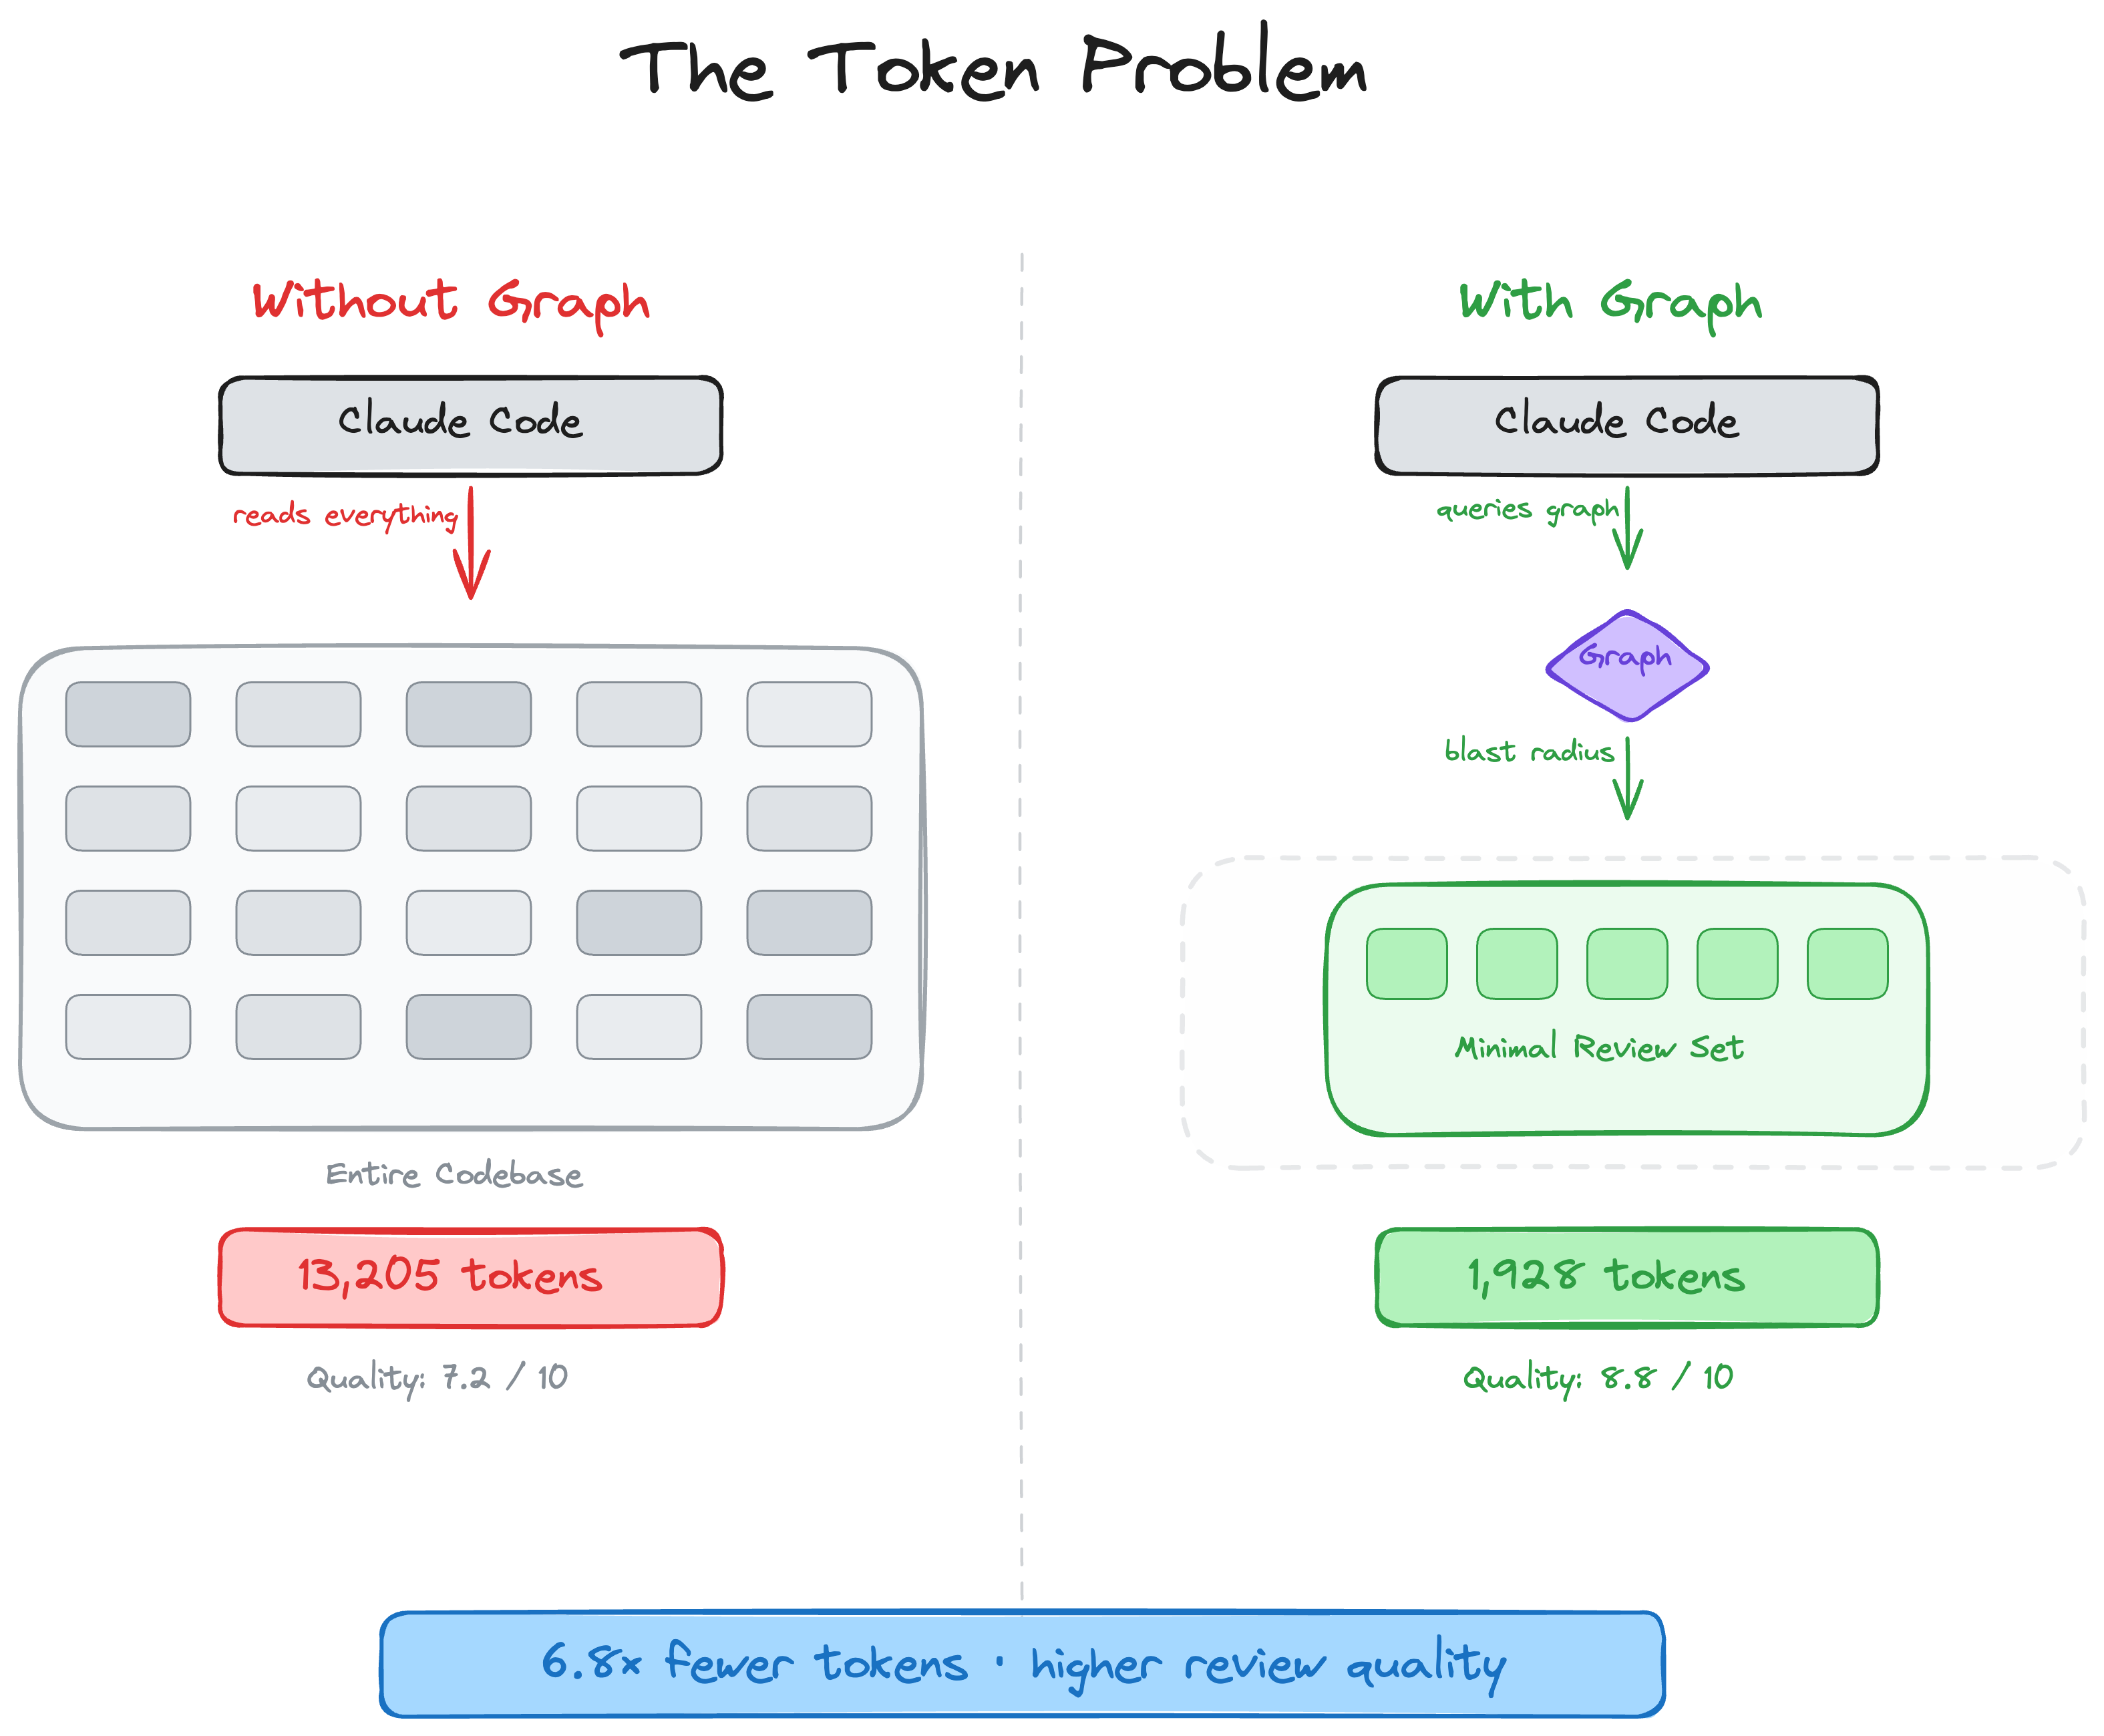 核心卖点视觉化:6 个真实仓库的 token 削减比例(38×–528×)
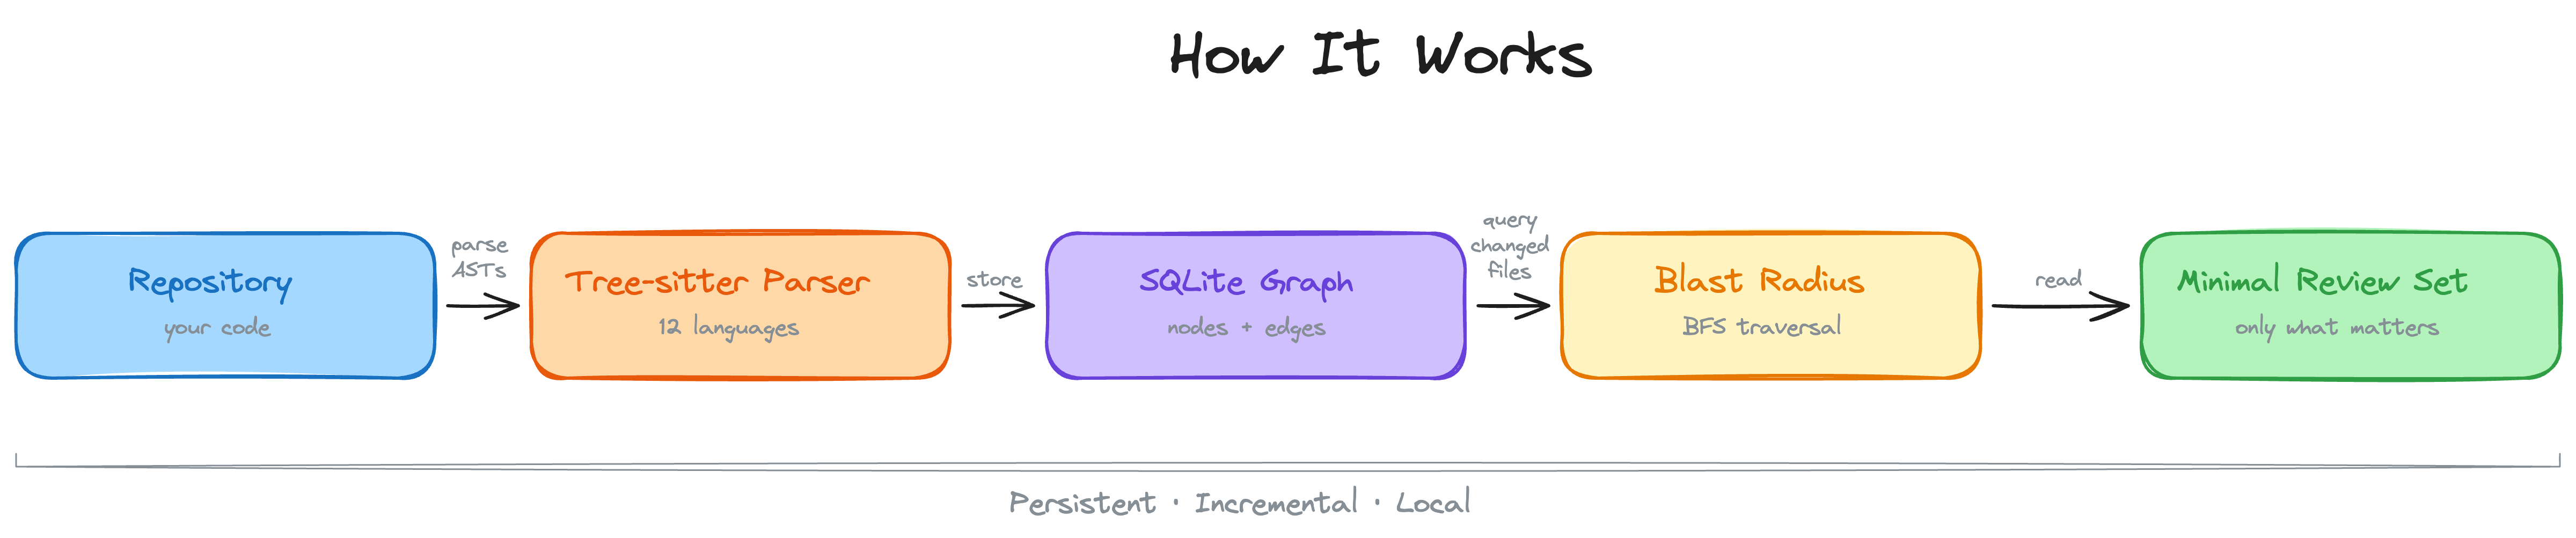 五阶段流水线:仓库 → Tree-sitter → SQLite → Blast Radius → 最小评审集
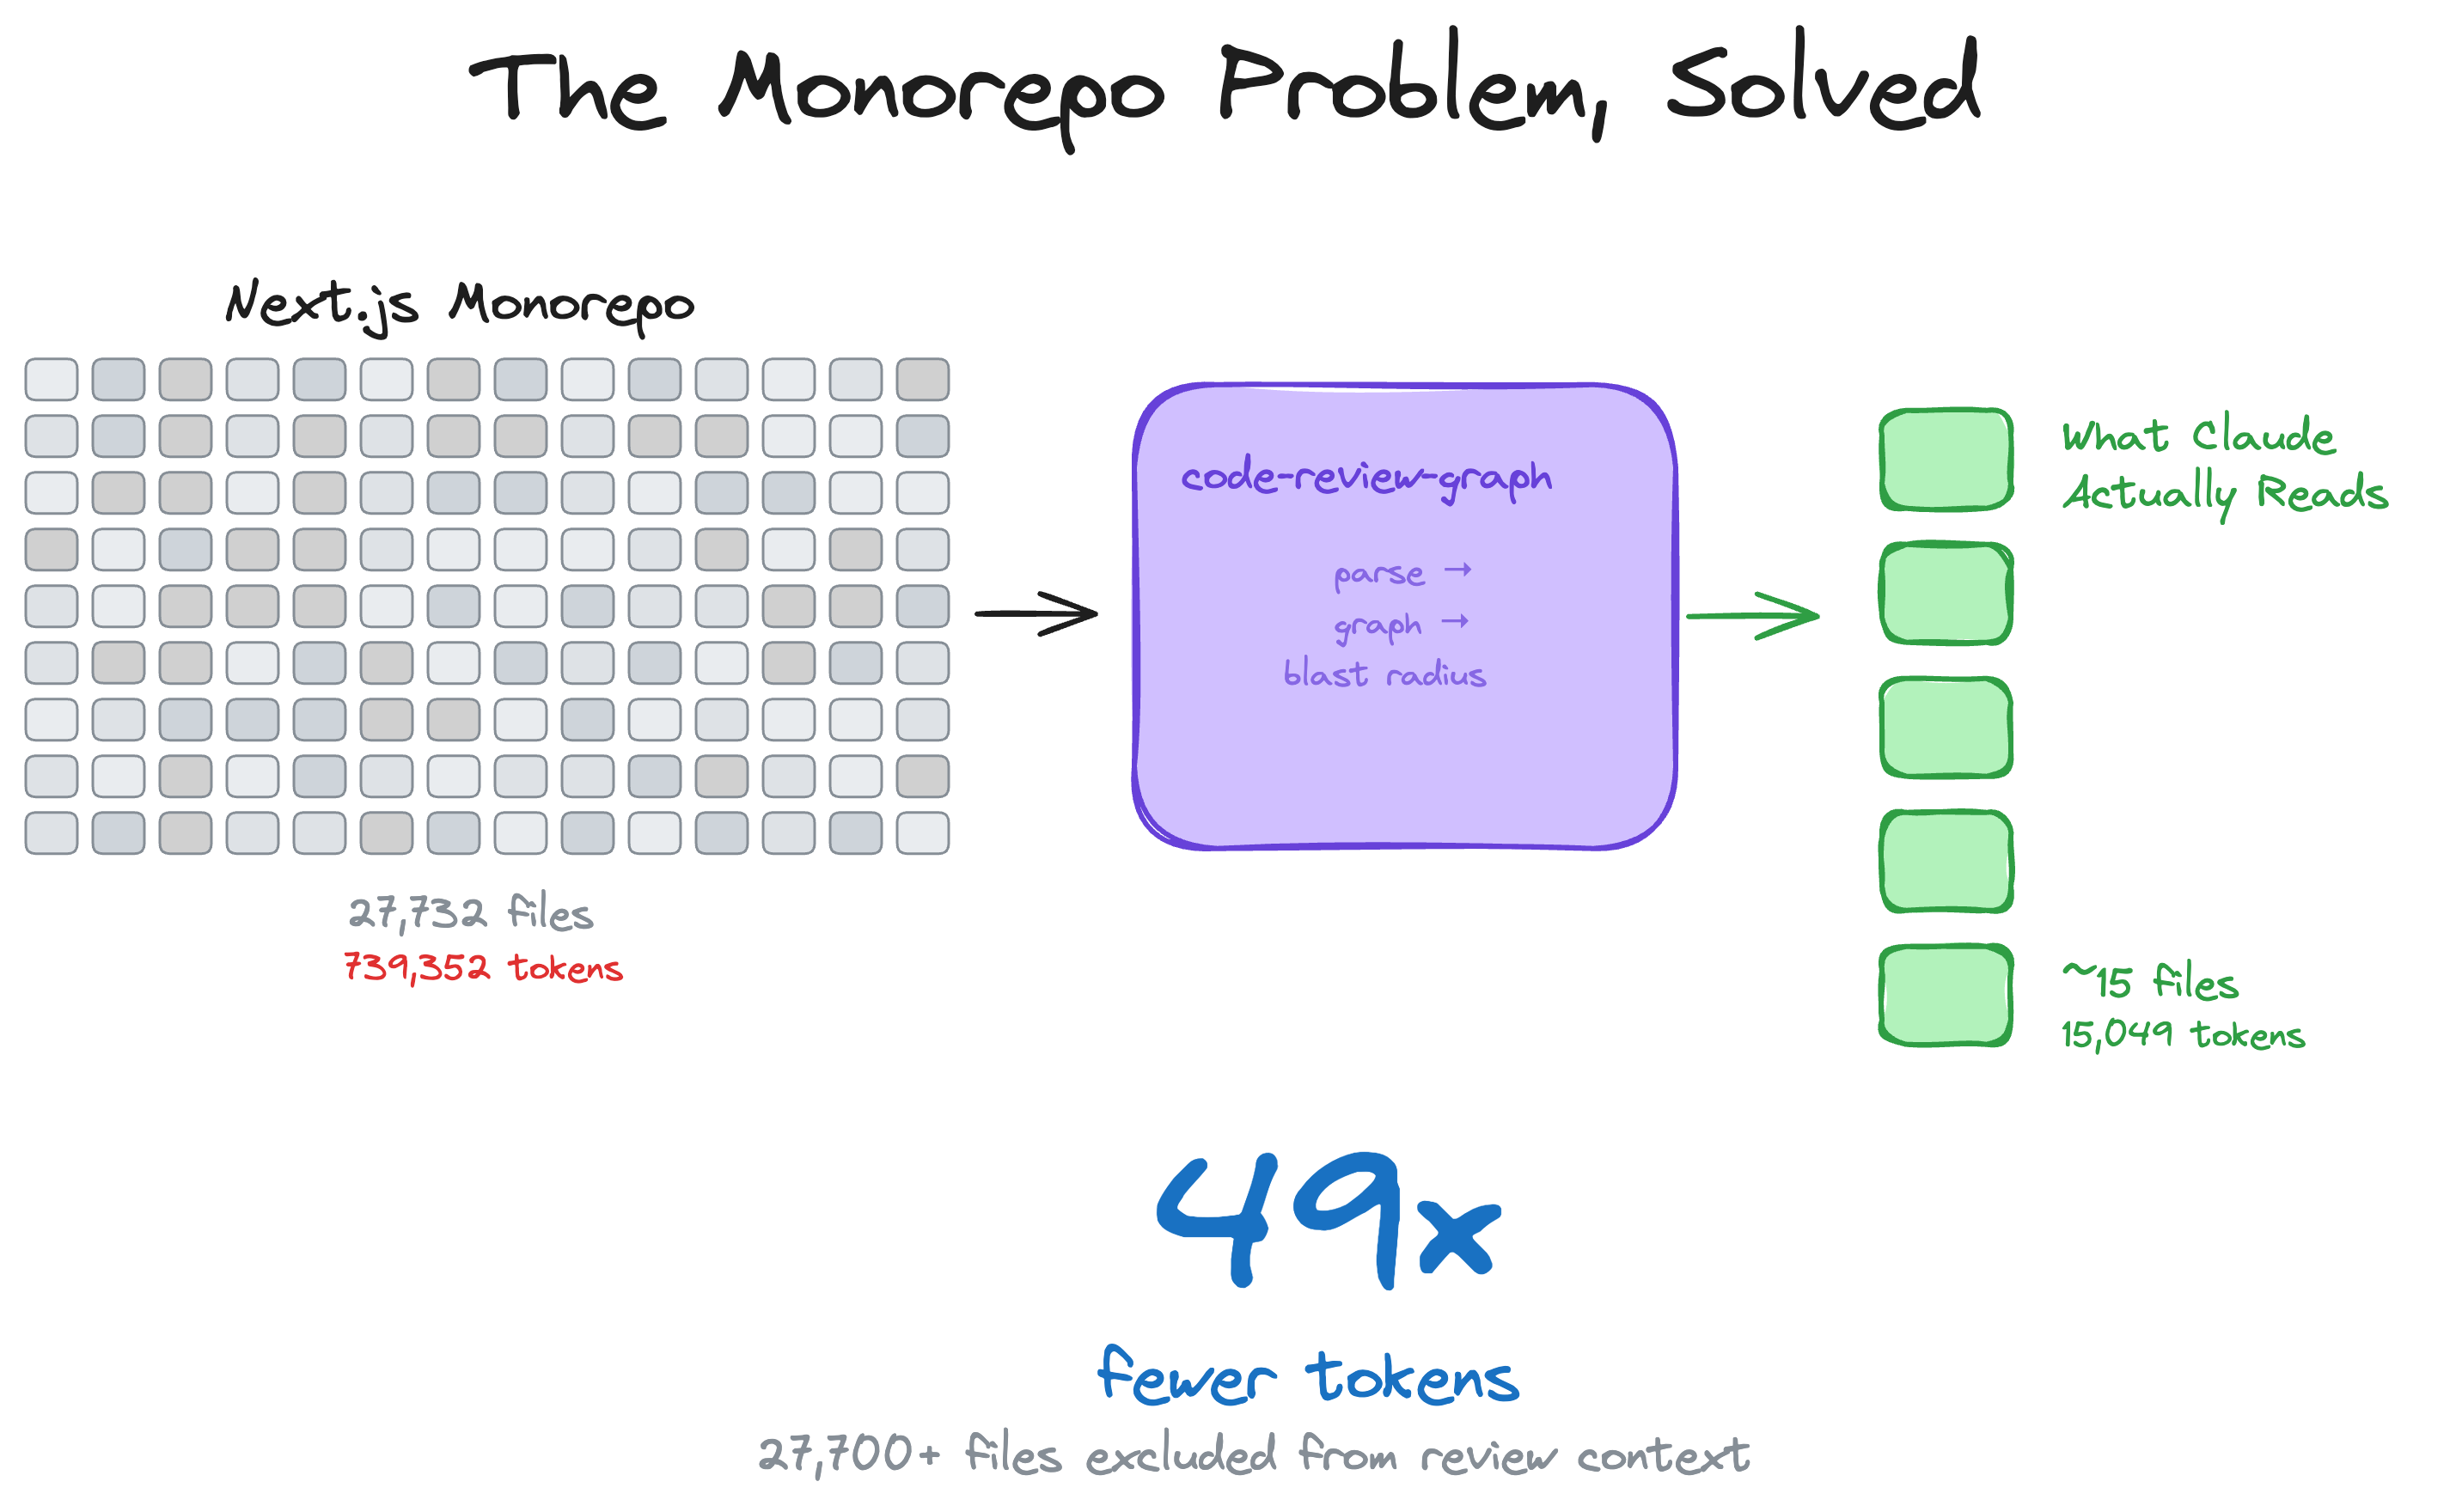 漏斗图直观展示:20.8 万 token 源码压到 2,495 token 的图响应(93× 缩减)
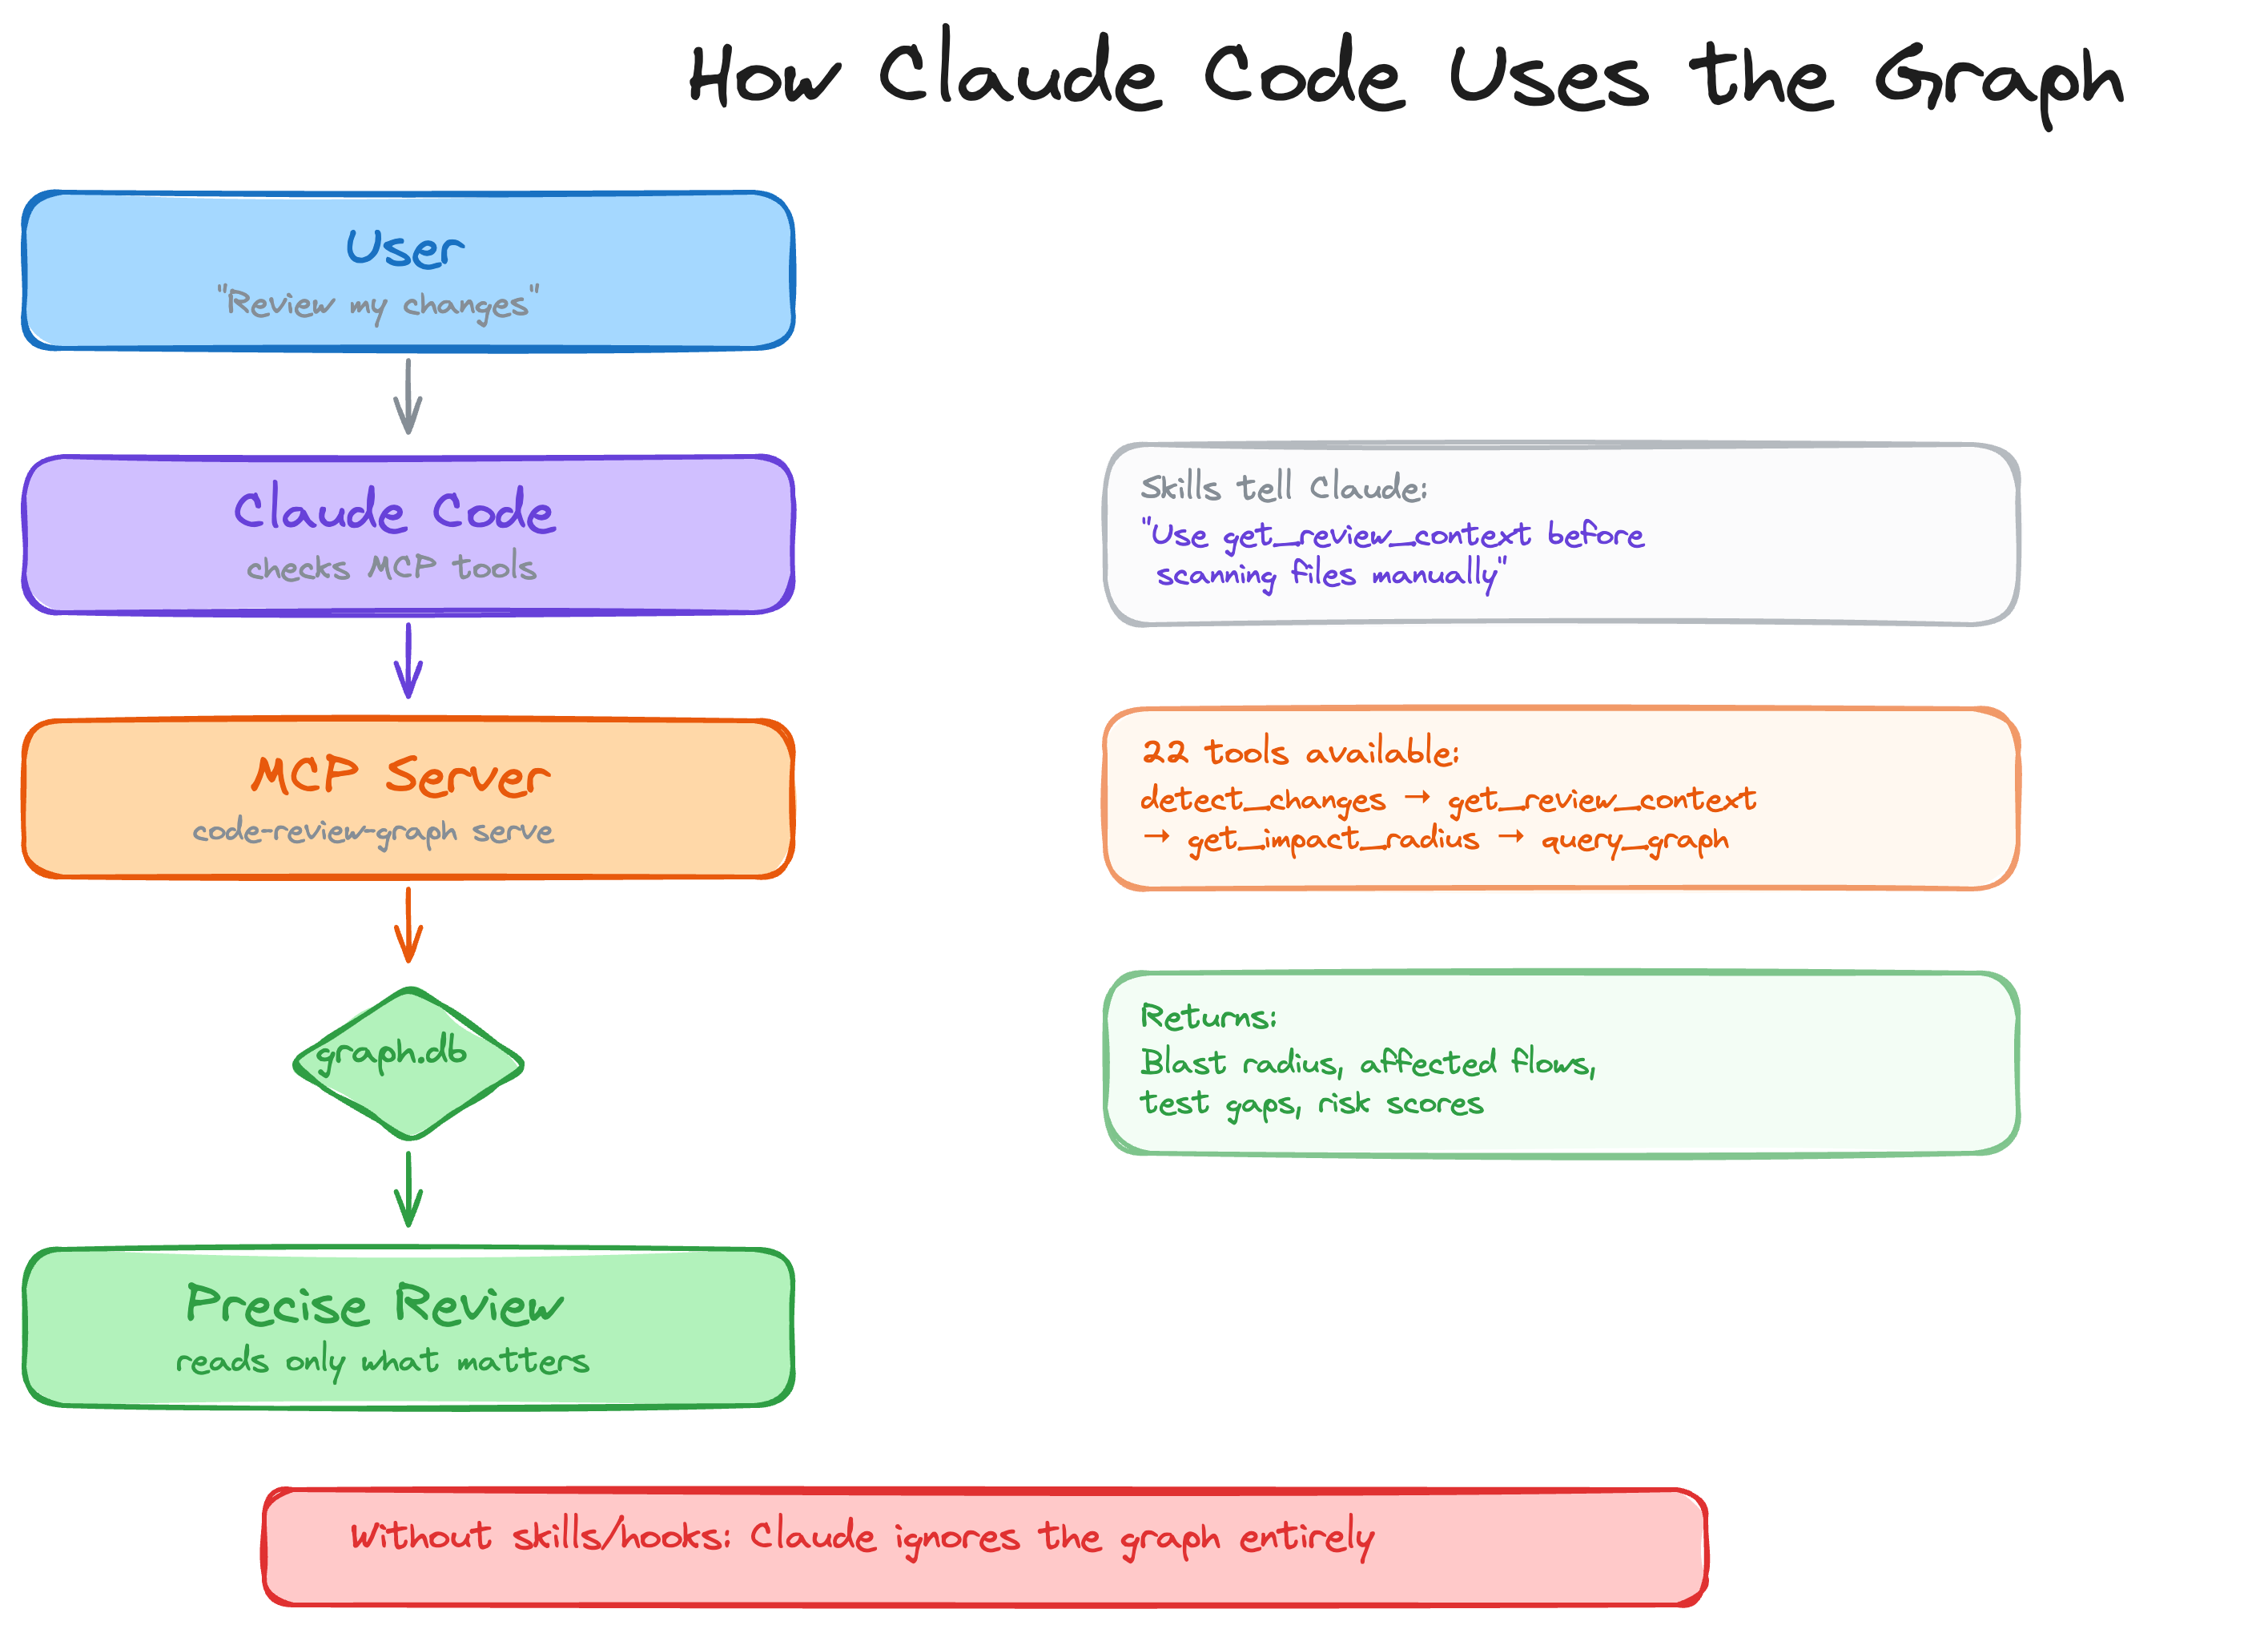 MCP 集成流:用户提问 → AI 查 MCP 工具 → 图返回 blast radius + 风险评分 → AI 只读必要内容
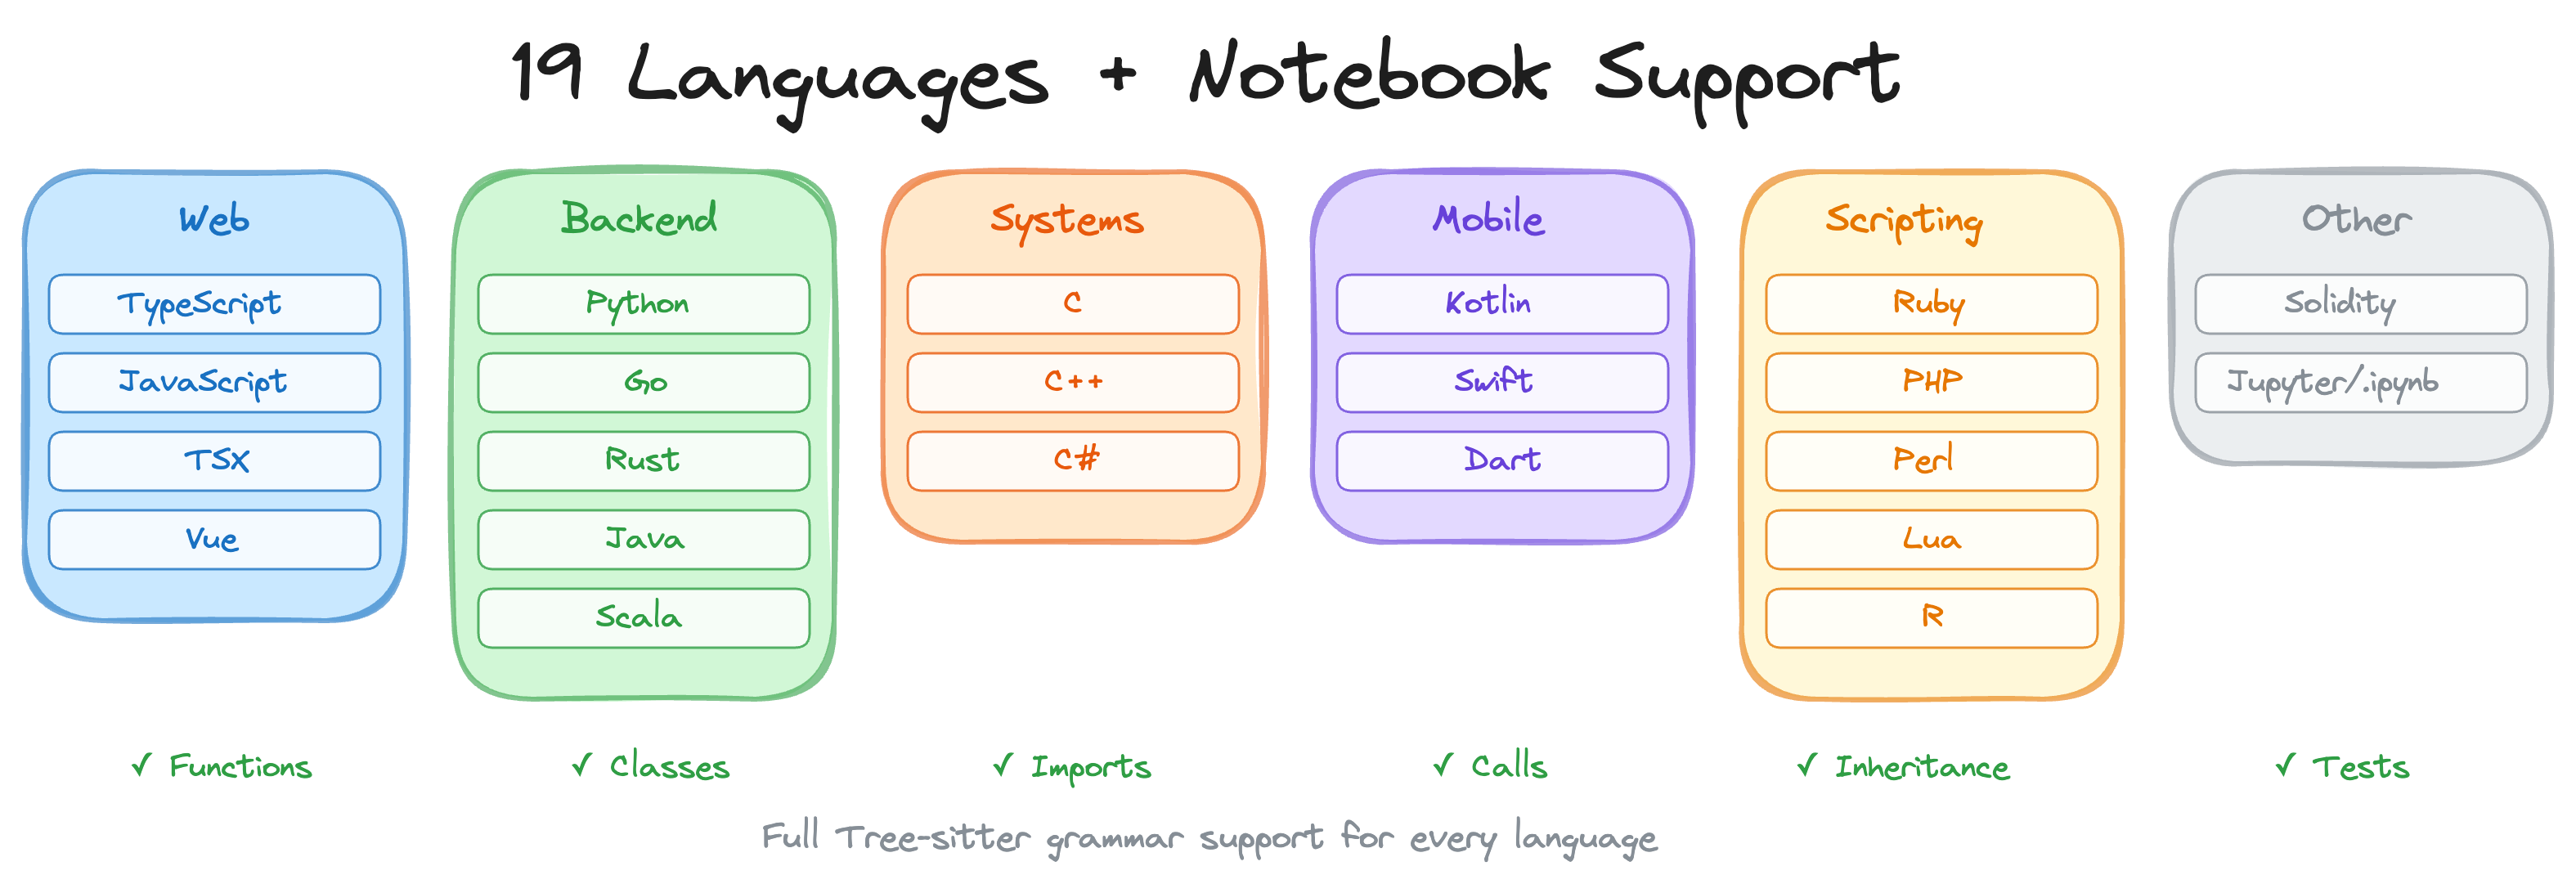 语言覆盖矩阵:Web / Backend / Systems / Mobile / Scripting / Config + Jupyter + Databricks notebook
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/tirth8205/code-review-graph |
| Star / Fork | 21,092 / 2,173 |
| 代码行数 | 74,918 行(Python 85.3%、TypeScript 5.8%、JSON 6.1%、YAML 0.6%) |
| 项目年龄 | 4.7 个月(首提交 2026-02-26) |
| 开发阶段 | 密集开发(近 30 天 145 commits) |
| 贡献模式 | 创始人主导(Top 占比 60.5%)+ 社区广泛参与(102 人) |
| 热度定位 | 大众热门(MCP + 代码知识图谱赛道头部) |
| 质量评级 | 代码[优秀] 文档[优秀] 测试[充分] CI/CD[完善] |
作者视角:为什么存在这个项目
创始人/作者背景
Tirth Kanani / tirth8205,Birmingham University 学术背景,London 位置,6 年 GitHub 账号、515 粉丝、30 个公开仓库。其他仓库多为研究/小工具(Jailbreak-Eval、CV2Latex、SafetyVision 等),唯独这一个做出了大众热门量级。Top 贡献者自己占 60.5%,第二位仅 20 commits——典型「独立开发 + 学术背景 + 社区少量参与」结构。
问题判断
作者在大 monorepo 上用 Claude/Codex 跑评审时,反复观察到一个 token 浪费反模式——agent 用一连串 grep + read 才能凑齐「谁调谁、谁测谁」。这是个非常具体的工程痛点(不是论文问题),所以做出来的东西显著偏工程实用而非论文优雅。2024–2026 正好是 MCP 协议 + Claude Code/Cursor 等本地 agent 客户端的爆发期,把「知识图谱」从学术/离线工具变成可被每个 IDE 实时调用的基础设施。Issue #314「graph 过度压缩让模型理解质量下降」是这一类工具被采纳后才暴露的真实张力,说明作者正在和真实用户一起迭代。
解法哲学
「本地优先 + 增量 + 可观测」三原则——README 直接写出来;CLI 有 status / detect-changes --brief / --verify 让用户随时验证 graph 真的在工作。不强求完美,正确性分层——每条边带 confidence 浮点 + 三档 confidence_tier(EXTRACTED / INFERRED / AMBIGUOUS),把「准确 vs 启发式」明确外显给 agent。故意把覆盖广度做满(~35 种语言 + SFC + Jupyter + Ansible + Terraform + VB.NET + SystemVerilog + Databricks 笔记本)——明显走「先覆盖、再深化」路线,把 LSP/RAG 的语言墙/语义墙尽量削平。
明确不做什么(FAQ 「When should I not use it」)——小仓库、单文件微改、一次性问答;并主动劝退用户,避免被滥用后留下「鸡肋工具」口碑。「小仓库吃亏」反而是诚实标签:token_efficiency 在 express 等小改下报 ratio < 1,作者在 README limitations 明确写出这是「结构性元数据开销 vs 一文件 diff」,不藏。
战略意图
核心产品定位(CLI + MCP server)+ 触点(VS Code 扩展 + GitHub Action + daemon + 14 客户端)+ 可选变现梯子(GitHub App + Team sync + 企业 multi-tenant),是典型的「先工具后平台」开源路线。目前没看到 SaaS 定价页,但 roadmap 留口子:Team sync (shared graph via git-tracked DB)、GitHub App / bot mode beyond the shipped GitHub Action (org-wide install, check runs)——典型的「把 agent 集成成本变成护城河」。
核心价值提炼
创新之处
按新颖度×实用性排序:
-
「blast radius」作为一等公民的图原语(新颖度 4/5 / 实用性 5/5 / 可迁移性 4/5)——不只是「call graph」,而是「改这一个文件会触发哪些文件被读」的端到端语义:变更文件 → BFS 出 callers + dependents + tests + flows + 风险评分 → 一次性返回 agent 所需的最小上下文集。
-
可观测的 token 节省闭环(新颖度 4/5 / 实用性 5/5 / 可迁移性 5/5)——不只声称省 token,而是把估算主动 attach 到 MCP 响应里、CLI 渲染成 boxed panel、可选用 tiktoken 校准;用户每次跑 review 都能直接看到「省了 ~94% tokens」。
-
「disposable subprocess 探活」加载 native grammar + 跨平台 process/thread 自动切换(新颖度 4/5 / 实用性 5/5 / 可迁移性 4/5)——不在主进程直接 import native parser,而是用
python -I -c "get_parser(g)"单独进程探活;MCP stdio / Windows 非 TTY 自动切 ThreadPoolExecutor 避免继承 transport fd。 -
「lifecycle-safe uninstall」(新颖度 4/5 / 实用性 5/5 / 可迁移性 5/5)——uninstall 不是「rm -rf」,而是基于 install 时写入的「owned」标记只删自己文件,保留无关 MCP server/hooks/skills/JSONC comments;共享配置文件走 atomic temp+rename 替换。
-
「confidence tier + float」显式外显的图边(新颖度 3/5 / 实用性 4/5 / 可迁移性 5/5)——每条边携带
confidence: float+confidence_tier: EXTRACTED|INFERRED|AMBIGUOUS,让消费方按证据强度排序、去噪、UI 灰显。 -
「框架感知 + 同文件/同包证据门控」的语义边解析器(新颖度 4/5 / 实用性 4/5 / 可迁移性 3/5)——不止语法边,还产出语义边:Spring
INJECTS/HANDLES/PUBLISHES、Terraform module 引用、ReScript 跨模块、Laravel Route→controller、Eloquent 关系、Jedi Python star-import 展开。 -
「custom language via TOML with built-ins always win」(新颖度 3/5 / 实用性 5/5 / 可迁移性 5/5)——用户在
.code-review-graph/languages.toml写 4 行就能让 CRG 支持新语言的函数/类/导入/调用抽取;任何内置语言不可被覆盖;broken config 只 warning 不 break。
可复用的模式与技巧
-
「语义 ID + 本地 rowid」分离模式:用
qualified_name字符串作为稳定外键,AUTOINCREMENT id仅作本地行号;跨次 build diff = 字符串集合差集。适用场景:任何需要跨次构建可比对的图/索引系统。 -
「disposable subprocess 探活 + 全局缓存」加载 C-extension:
python -I -c "load(g)"单独进程加载,失败进程级缓存跳过;避免单坏 grammar 拖垮主进程。适用场景:依赖多 native module 的 Python 包、Polyglot notebook、any-grammar 的多语言工具。 -
「process/thread executor 跨平台自动切换」:把
subprocess fd inheritance、win32 TTY、MCP stdio transport这几个环境信号合并成一个 enum,让运行期自动选。适用场景:长跑 Python 服务、需要并行解析的 CLI、跨平台 IDE 集成。 -
「estimated + verify 模式」披露 token 节省:默认 4 chars/token 估算 +
estimated: true标签 + 可选 tiktoken 校准 + 把 savings 主动 attach 到 MCP 响应。适用场景:任何 AI 增强的开发者工具。 -
「confidence tier 显式三档」:
EXTRACTED / INFERRED / AMBIGUOUS+ float。适用场景:所有「启发式代码补全/分析」工具的兜底表达。 -
「lifecycle-safe uninstall + atomic temp+rename」:基于「owned 标记」只删自己文件 + atomic 替换 + dry-run。适用场景:CLI、IDE 扩展、npm/pip 全局包、任何修改共享配置的工具。
关键设计决策
-
决策:所有节点用「Qualified Name」作为稳定主键,边用「source_qualified + target_qualified」
- 问题:图数据库在多次重新 build 时怎么保持 ID 稳定?
- 方案:不依赖自增
id做跨版本外键,全部用「路径 + 类名 + 方法名」的字符串拼接做qualified_name,数据库id仅作为本地行号;删除/重命名时用「qualified_name 集合差集」直接定位。 - Trade-off:放弃 join 性能(qualified_name 字符串长、索引占用大)换取稳定的语义 ID 与无侵入式 schema migration。
- 可迁移性:高。
-
决策:5 类边类型 + 3 档 confidence tier 显式外显
- 问题:AST 级启发式无法做到 LSP 的类型精确,但产出又必须有用,怎么办?
- 方案:把每条边都贴
(confidence: float, confidence_tier: EXTRACTED|INFERRED|AMBIGUOUS),让消费方自己决定信任阈值;显式建模「类型不精确」而不是偷偷返回错结果。 - Trade-off:UI/查询代码要处理三档(多了一些分支),换来的是「下游可以基于置信度做 evidence 权重 / UI 灰显」。
- 可迁移性:高。
-
决策:Tree-sitter 解析按需延迟加载 + 「disposable subprocess」探活 + 全局缓存
- 问题:35 个 Tree-sitter grammar 共用一个 Python 进程,单个 grammar 在某些平台/版本组合下加载会 segfault / 阻塞。
- 方案:用一个独立 interpreter 进程
python -I -c "get_parser(grammar)"探活,超时 5 秒默认;只有 probe 成功才在主进程 import。 - Trade-off:每次新增 grammar 多一次 subprocess 开销(毫秒级),换来「单个坏 grammar 不会拖垮整个 build」。
- 可迁移性:高。
-
决策:parse worker 在 MCP stdio 下自动切 ThreadPoolExecutor,ProcessPoolExecutor 默认
- 问题:ProcessPoolExecutor 在 Windows FastMCP stdio 模式下会继承 transport 的 file descriptor,导致 server 关不掉、进程僵死。
- 方案:加一个
_MCP_STDIO_ACTIVE全局开关 + sys.platform + env overrideCRG_PARSE_EXECUTOR={process,thread},让运行期动态选。 - Trade-off:牺牲约 < 30% 全构建速度(thread 版),换来跨平台一致的「server 能正常关停 + 没有 zombie」行为。
- 可迁移性:中。
-
决策:GraphStore + SQLite WAL 模式 + 单独的 embeddings.db
- 问题:大图既要快查询又要能流式更新;embedding 又会快速膨胀;用户没运维也不想装 Postgres。
- 方案:核心图全部塞一个本地 SQLite 文件
.code-review-graph/graph.db,开 WAL 让 build 期间也能查询;embeddings 单独 DB 便于「不重 build 只重 embed」。 - Trade-off:放弃了分布式/多进程写入,换来「单文件 gitignore + 跨平台 + 零依赖 + 用户自托管」。
- 可迁移性:高。
竞品格局与定位
竞品对比矩阵
| 维度 | code-review-graph | GitNexus (~34.7k⭐) | Serena (26.5k⭐) | jcodemunch-mcp (~2k⭐) |
|---|---|---|---|---|
| 部署模型 | 本地 Python + SQLite | 浏览器内 WASM + 零服务器 | LSP daemon 多语言 | 极简 MCP server |
| 核心抽象 | blast radius + risk score | Leiden 聚类 + 浏览器可视化 | 符号级 LSP 编辑 | Tree-sitter AST 检索 |
| 边类型 | 10+(CALLS/IMPORTS/INHERITS/TESTED_BY/INJECTS/…) | 主要 CALLS + 社区 | LSP 标准 references/definitions | CALLS + DEFINITIONS |
| 增量更新 | < 2s(工程化) | 无公开数据 | session-bound | 无 |
| 客户端覆盖 | 14 个 MCP 客户端 + GitHub Action + VS Code | 浏览器内 | 14+ MCP 客户端 | MCP 客户端 |
| Token 节省基准 | 真实 cl100k_base 校准 + --verify | 浏览器内聚类,无可验证节省 | 无 | 无 |
| 跨语言 | ~35 种 + notebook + DSL | 多语言但 WASM 限制 | LSP 全覆盖(需各语言 toolchain) | Tree-sitter 全覆盖 |
| 主要场景 | CI/编辑器内自动 PR 评审 | 浏览器里玩图谱 | Agent 编码工具箱 | 找符号的 grep 替代 |
差异化护城河
- 技术护城河(中):核心是「跨语言持久结构图 + 可验证 token 节省 + 框架感知 resolver」,技术上没有不可替代的护城河,但工程实现细节(disposable probe、executor 自动切换、confidence tier、context_savings)加在一起形成复制成本。
- 生态护城河(中低):14 个客户端 + GitHub Action + VS Code 扩展 + daemon + custom language TOML 构成的「集成矩阵」是真正的护城河——竞品要做齐这些需要等价的工程投入。
- 信任护城河(中):诚实标注 limitations(recall 1.0 是 circular upper bound、JS/Go flow detection 33% recall、小仓库吃亏)+ 校准数据 + 公开评测 CSV,是当前 AI 工具稀缺的可信度姿态。
竞争风险
- 最可能被 Serena 替代:用户从「评审 → 编辑」拓展需求时,Serena 一站式占优;CRG 在编辑器集成层必须扩能力。
- 最可能被 GitNexus 替代:用户拒绝装 Python、追求零服务器时,GitNexus 是更「现代」的部署模型。
- 最可能被 Anthropic/Cursor 自带能力替代:如果 Claude Code / Cursor 直接内置「AI-友好代码索引」功能(Anthropic 已经声明 Claude Code 不带 code index 是设计选择,但未来可能变),CRG 的核心价值主张会被侵蚀。
生态定位
**「AI 评审专用、跨语言、本地优先、token 节省可量化」**的开发者工具。在「RAG / LSP / grep / 全量打包」四象限里填补了「跨语言结构化 + 持久 + 评审专用 + token 可观测」这个空白。
套利机会分析
- 信息差:不是被低估的项目,已是被算法信息流反复曝光的「AI 编码 MCP」赛道头部;但 MCP 这个品类本身仍处于早期红利期,CRG 用「先发 + 真实基准数据」卡住了「Claude 的本地记忆层」心智位。
- 技术借鉴:上述 6 个可复用模式(语义 ID 分离、disposable probe、executor 自动切换、estimated+verify、confidence tier、lifecycle-safe uninstall)可直接迁移到自己的项目。
- 生态位:填补了「跨语言 + 持久 + 评审专用 + token 可观测」四象限交叉空白,这是 Serena/LSP/GitNexus/grep 都没同时满足的组合。
- 趋势判断:MCP + Claude Code + Cursor 的爆发期刚开始,CRG 在 4.7 个月内冲到 21k stars + 102 贡献者说明踩对了时间窗口;7 月起 commit 再度放量(135 个),新一轮版本推进正在进行。
风险与不足
- 高速演化 = 接口不稳定:近 90 天 339 commits,30 个 tag / 28 个 release,平均 5 天一发;使用者应锁定版本并关注变更日志,不宜把当前接口默认视为长期稳定契约。
- 修复提交占 35.5%:显著高于功能提交的 20.0%,说明项目已经越过纯 MVP 堆功能阶段,正在承受真实用户、多语言和跨平台场景带来的缺陷反馈;当前成熟度偏「快速硬化」而非「高度稳定」。
- Windows 兼容性是最大跨平台痛点:Issue #136 报告 embed_graph_tool 在 Windows + sentence-transformers + Gemini provider 下挂死;早期 #46 也有类似报告,Windows 用户基本靠自己解决。
- 大 monorepo 首次构建慢:Issue #189 揭示 graph build 在大型 monorepo 上首次构建仍存在耗时问题;增量快≠首次构建快,是用户落地的主要摩擦点。
- 核心知识高度集中于创始人:Top 贡献者 Tirth 占 60.5%,第二位仅 20 commits;关键架构知识可能高度集中于创始人,「Bus Factor」风险显著。
- 118 个运行时依赖偏多:增加安装兼容、供应链安全和版本冲突的维护成本。
- Issue #314 揭示核心权衡:graph 过度压缩上下文时,模型对代码的理解质量会下降,作者承认这是「为了 token 付出的代价」——这是任何做 RAG/知识图谱项目的核心权衡,也是后续评测体系必须攻克的点。
行动建议
-
如果你要用它:
- 大 monorepo 团队——首选,token 节省在 ~10k–100w tokens 仓库上最显著(38×–528×)。
- AI coding 平台工程团队——如果你用 Claude Code / Cursor / Codex 等做 PR 评审,CRG 是「Claude 的本地记忆层」的最佳现成方案。
- 小仓库 / 单文件微改 / 一次性问答——主动劝退,CRG 在 FAQ 明确说不适合;用 repomix 一次性打包或 jcodemunch 找符号即可。
-
如果你要学它:
- 重点关注:
code_review_graph/parser.py(564k 字节,35 种语言的 Tree-sitter 解析 + disposable probe)、code_review_graph/incremental.py(_select_executor_kind 跨平台 executor 自动切换)、code_review_graph/graph.py(SQLite WAL + 邻接结构 + dataclass 模型)、code_review_graph/skills.py(14 个 AI 平台的 MCP 配置 + hooks + skills + CLAUDE.md 注入)。 - 设计哲学参考:Local-first / Observable / Incremental 三原则;五阶段流水线(Inputs → Processing → Intelligence → Outputs → Improvement Loop)。
- 测试体系参考:
tests/test_multilang.py(147k 字节跨语言 fixture)+tests/test_skills.py(92k 字节 14 平台覆盖)+tests/test_windows_compat.py(跨平台专项)。
- 重点关注:
-
如果你要 fork 它:
- 改进方向:① 解决 Issue #136 Windows + embeddings 兼容性;② 优化 Issue #189 大 monorepo 首次构建耗时;③ 引入 LSP fallback 提升符号精度(降低 INFERRED/AMBIGUOUS 边比例);④ 增加更多框架 resolver(NestJS、Django、Rails);⑤ 提升 JS/Go flow detection recall(当前 33%)。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/tirth8205/code-review-graph |
| Zread.ai | 未收录 |
| 关联论文 | 无 |
| 在线 Demo | 无独立 Playground;DeepWiki 提供的概览可作为入门替代 |