BTS 母公司投的设备端 TTS:99M 小模型说 31 种语言,能跑树莓派
一句话总结
Supertonic 是 Supertone Inc(韩国 AI 音频公司,BTS 母公司 HYBE 以约 $32M 收购 56.1% 控股)的「闪电般快、设备端、准确的 TTS」——把整条流水线压进一个 99M 参数开放权重模型,纯设备端 ONNX 运行(无云/无 API/无 GPU、能跑树莓派和电子书阅读器),支持 31 种语言、44.1kHz 录音级直出、10 个内联表情标签,快到「一秒把整个网页读成语音」。仓库本质是「模型 + 11 平台原生推理参考」(同一份 ONNX 在 Python/Rust/Go/Swift/Java/C++/C#/WebGPU/Flutter 各移植 ~700 行)。代码 MIT、模型权重 OpenRAIL-M(开放权重非纯开源),克隆能力走付费 Voice Builder——开放权重做获客漏斗。11.3K star。
值得关注的理由
- 一个反直觉的「小模型吃多语言」技术底座值得抄:Supertonic 不用 g2p / 音素表 / per-language normalizer——
UnicodeProcessor直接把每个字符ord(char)取 uint16、过一张unicode_indexer.json映射成 token id(py/web/rust 三处完全一致),语言信息只是把文本包成<en>...</en>标签 token,lang="na"只是表里又一个标签。把「文本→发音」的全部知识压进 99M 权重、host 端零语言学逻辑——这是 99M 撑起 31 语言的关键手法,可迁移到任何想低成本吃多语种的序列模型。表情标签(<laugh>/<breath>/<sigh>)同机制:host 零解析,原样走码点通道交给模型识别。 - flow-matching 的「host 控循环 + ONNX 单步」切分:4 段独立 ONNX 管线(Duration Predictor → Text Encoder → Vector Estimator flow-matching 去噪 → Vocoder 44.1kHz),其中
current_step/total_step作为输入喂进 ONNX,去噪迭代在 host 的for循环里,调total_step(5-12,默认 8)即可运行时换质量/速度。拆成 4 个会话而非端到端单图——换来每段可独立量化、flow-matching 只重跑最贵的 vector_estimator、各平台移植时管线边界清晰。这套「外层 host 调度迭代、内层模型只算单步并接收 step 索引」是扩散/flow 类设备端推理的通用范式。 - hub-and-spoke 单模型 11 平台原生移植:一份 ONNX + 一份 voice style JSON,11 平台各 ~700 行镜像 binding,跨平台复杂度被 ONNX Runtime 吃掉——这是一个小团队(核心 1-2 人)能维护 11 个平台的工程前提。值得借鉴,但也要警惕镜像漂移:Rust 版
chunk_text已比 Python 版多一层「超长句按逗号/空格/单词级二次切分」的健壮回退。
项目展示
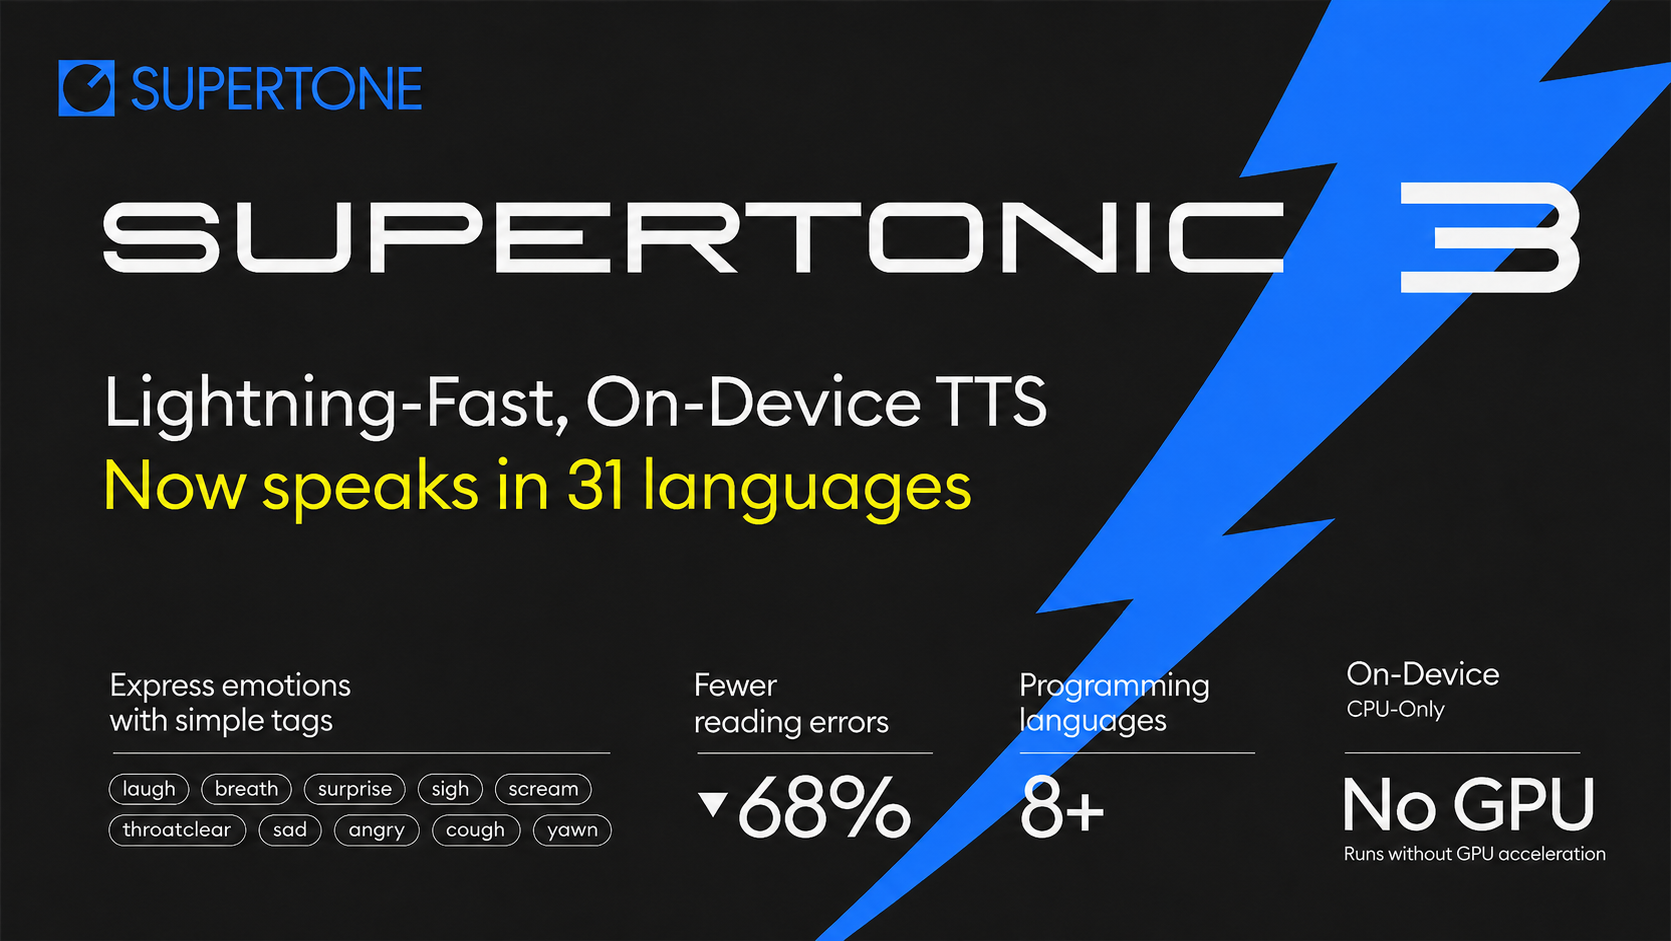
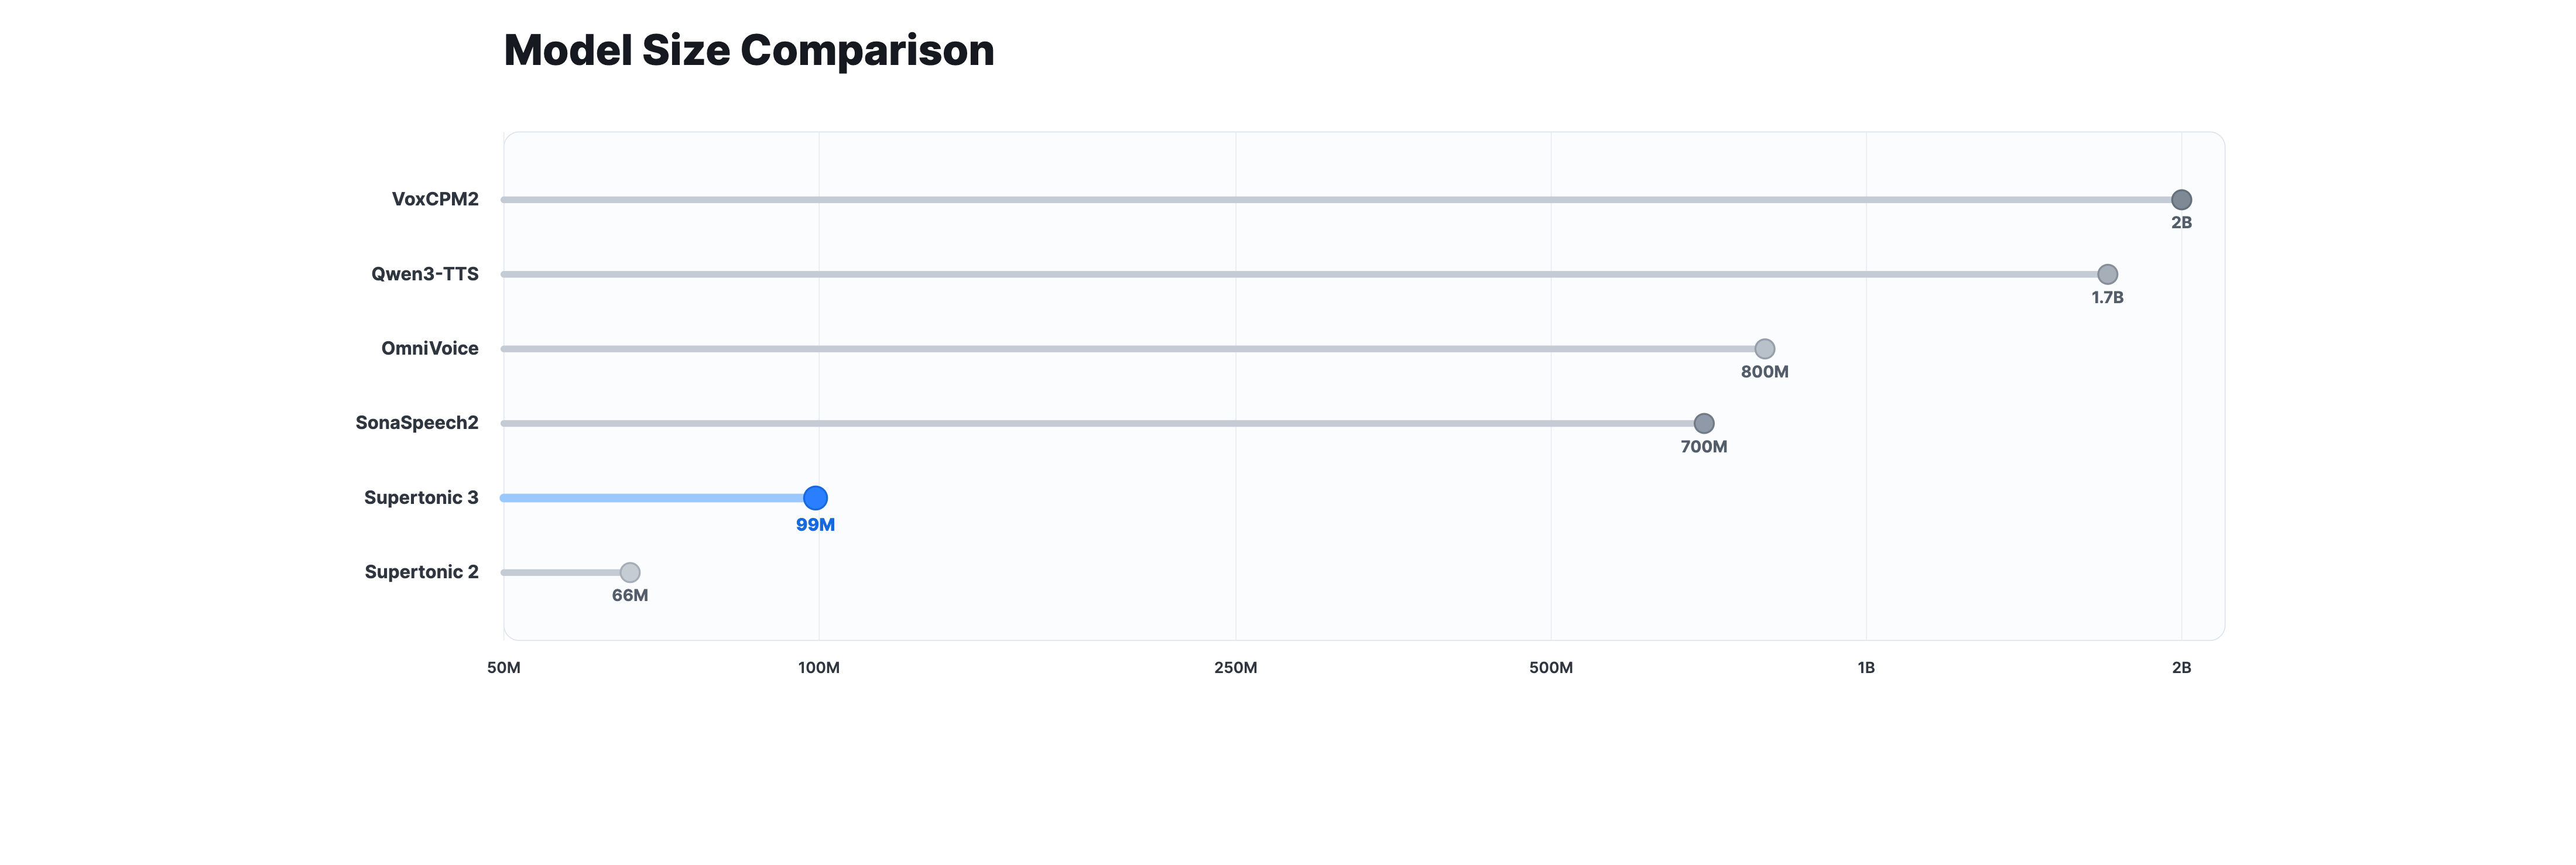
99M 参数比 OmniVoice 小 8×、比 Chatterbox Multilingual(500M) 小 5×;纯 CPU(16 线程)RTF 0.200,速度追平 800M 模型在 RTX 3090 上的表现。在线 WebGPU demo:HuggingFace Space
Supertone/supertonic-3。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/supertone-inc/supertonic |
| Star / Fork | 11,352 / 1,180(建库 7 个月破万,爆发型;fork/star ~10% 偏高,大量人「拿去自己平台跑」) |
| 代码行数 | 9,895 行(66 文件)——12 语言近乎等分(JS 14.5%/C++ 12.5%/Swift 11.8%/Go/Dart/Java/C#/Rust/Python…),是「同一管线 11 平台各移植一份」的指纹;注释比 0.193 |
| 项目年龄 | 6.6 个月(2025-11-18 起,最后提交 2026-05-22) |
| 开发阶段 | 稳定维护 · 发布型(仅 45 commit,双脉冲:2025-11 发 v2、2026-05 刷 v3;版本间静默) |
| 贡献模式 | 公司小团队(9 贡献者,ANLGBOY 58.5% + haeon/fbdp1202 + dependabot;周末 20% 工作日为主) |
| 热度定位 | 大众热门 · 爆发型(踩中「小快设备端 TTS」赛道 + HYBE 背书破圈) |
| 版本 | v3.0.0(仅 2 tag,v2→v3 大版本跳跃,SemVer) |
| License | 代码 MIT · 模型权重 OpenRAIL-M(开放权重非纯开源) |
| 质量评级 | 文档「优」· 代码「良」· 错误处理「中」· 测试「弱(仅 test_all.sh 冒烟)」· CI「无(无 .github)」 |
作者视角:为什么存在这个项目
创始人/作者背景
Supertone Inc——韩国 AI 音频公司,2020 年由语音/ML 专家 李教九(Lee Kyogu) 创立,早期以「奇点级歌声合成(SVS)」出名:2021 年在韩国综艺《AI vs Human》中用 AI 复活已故歌手金光石的声音。HYBE(BTS 背后的 K-pop 巨头) 2021 先投 $3.6M,2022 以约 $32M 收购 56.1% 控股权——这不是个人开源项目,而是上市娱乐集团的战略 AI 子公司。商业落地证据:HYBE 用其技术让歌手 Midnatt 单曲一键产出英/韩/西/日/中/越 6 语种演唱版。组织仓库矩阵印证「开源引流 + 商业产品」:supertonic(11.3K★,本仓)一枝独秀,其余全是配套商业链(supertonic-py 生产 SDK / supertone-cli/mcp 托管 API 客户端 / onnxruntime-build 自建推理底座 / play-desktop)。
问题判断
云端 TTS 的三宗罪——隐私(文本上传第三方)、成本(按字符计费)、延迟(网络往返)。Supertonic 把整条流水线压进 99M ONNX 模型纯设备端运行(README 演示 Onyx Boox 电子书飞行模式 RTF 0.3×)。现有开放 TTS 要么大(0.7B-2B 类本质 GPU 路线),要么语种少(Kokoro 82M 但 8 语言)——Supertonic 卡位 = 小模型(99M) + 宽语种(31) + 录音级 44.1kHz + 11 平台原生,单点都不极致但组合罕见。
解法哲学(小模型 + ONNX 跨平台 + flow-matching)
① 小模型优先——99M 是刻意选择(小下载/快冷启/低内存/CPU 实时),example_onnx.py 默认 --use-gpu 直接 raise NotImplementedError,参考实现就是 CPU-only;② ONNX Runtime 吃掉跨平台复杂度——模型导出 4 个 .onnx,11 平台各写 ~700 行镜像 binding;③ flow-matching 去噪(与 F5-TTS 同路线但小而快)——vector_estimator.onnx 是核心,total_step 是运行时质量/速度旋钮。能力来自歌声合成/AI 复活已故歌手的音频生成肌肉(比 TTS 难得多,自带 44.1kHz 录音级 + 韵律/表情控制),降维到 TTS 是技术外溢。
战略意图
清晰的获客漏斗:代码 MIT、模型权重 OpenRAIL-M → 免费固定音色本地推理做触达 → 克隆能力不在开源范围(Voice Builder $50 生成版本化 voice JSON)→ Supertone Play 托管 → Supertone API。开源仓库本身是「可移植性证明 + 营销资产」,真正的钱在克隆与托管。这解释了 #5(风格定制最高呼声)与 #138($50 定价困惑)——开放模型与付费克隆之间的体验断层是商业设计而非疏漏。
核心价值提炼
创新之处
- 原始 Unicode 码点 tokenizer 撑起 31 语言 + lang=na 零适配器(新颖度 4/5,实用性 5/5,可迁移性 5/5):用
ord(char)→indexer JSON 取代 per-language g2p/音素前端,语言仅作<lang>标签 token。适用任何想低成本吃多语种的序列生成模型。 - host 控循环 + ONNX 单步的 flow-matching 切分(新颖度 3/5,实用性 5/5,可迁移性 4/5):
current_step/total_step作为模型输入,去噪迭代在 host 的 for 循环,调total_step(5-12) 运行时换质量/速度。适用扩散/flow-matching 类设备端推理。 - hub-and-spoke 单模型 11 平台原生移植,ONNX 抹平差异(新颖度 3/5,实用性 4/5,可迁移性 4/5):一份模型 + 11 份 ~700 行镜像 binding。适用要「一次训练处处原生」的边缘 AI。
- 控制信号全部 in-band token(语言标签 + 表情标签同机制)(新颖度 3/5,实用性 4/5):host 零解析,
<laugh>/<en>走同一码点通道,跨平台天然一致。 - 音色解耦为可携带 JSON(双 style 向量 style_ttl + style_dp)(新颖度 3/5,实用性 4/5):音色即数据文件,付费克隆产物与开源模型同接口插拔、换音色零重载模型。
- 4 段独立 ONNX 而非端到端单图 + 44.1kHz 直出无外部 upsampler(新颖度 3/5,实用性 4/5):每段可独立量化、中间张量可见、vocoder 直出录音级。
可复用的模式与技巧
- 码点级 tokenizer + 语言/控制标签 token:以 Unicode 码点为最小单位、语言/控制信号当 in-band 特殊 token——多语种、省掉 per-language 前端的小模型。
- 外层 host 循环 / 内层单步 ONNX:迭代式推理(flow/diffusion)的调度留 host、模型只算单步并接收 step 索引——需运行时调步数的设备端生成。
- 多阶段管线拆成独立 ONNX 会话:按语义边界切图,各段独立量化/调用。
- 条件向量外置为 JSON 数据文件:风格/音色与权重解耦、可携带可替换。
- hub-and-spoke 镜像移植 + 冒烟脚本:单中枢规格 + 多平台逐行镜像 +
test_all.sh横向比对(但要警惕镜像漂移)。 - 缩写感知句子分块 + 静音拼接长文护栏:小生成模型应对长输入(
Mr./e.g.不误切、CJK 密度高故 max_len ko/ja=120)。
关键设计决策
最值得记录的是 「把语言学前端全部塞进模型权重、host 端极薄」的激进取舍——这是理解 Supertonic 工程经济性的钥匙,也最容易被误读。表面上 README 大书特书复杂文本归一化($5.2M、电话号码、30kph)能赢过 ElevenLabs/OpenAI,但 _preprocess_text 里根本没有数字/货币/日期归一化逻辑——只有 NFKD、去 emoji、标点修整,且顶着 # TODO: Need advanced normalizer 注释(这条注释在 py/rust/web/nodejs 四处镜像存在)。归一化、g2p、韵律全训进了模型权重(Duration Predictor + Text Encoder 直接消费原始码点)。这个取舍的 Trade-off 很关键:无需维护 31 套外部 normalizer(巨大工程省力)、跨平台天然一致(host 没有语言学逻辑可漂移),但代价是归一化不可控、不可调、随长尾语种退化——这正是 #124 德语货币失效、越南语 WER 4.49、芬兰语 5.40(vs 头部语言 <2)的根因。99M 容量摊到 31 语言,头部语言(英/韩/日)好、尾部退化,是「先覆盖广度、头部打磨」的产品节奏的必然代价。
技术支撑(修正常见误读「无论文」):README 引用 4 篇 arXiv 论文——主架构 SupertonicTTS(2503.23108,speech autoencoder + flow-matching)、LARoPE(2509.11084,Length-Aware RoPE 解决文本-语音对齐)、Self-Purifying Flow Matching(2509.19091)、RobustSpeechFlow(2605.22083)。有学术支撑,只是无逐语种 WER 完整公开、无单一整系统技术报告。
竞品格局与定位
| 项目 | 参数/Stars | 定位 | 与 Supertonic 关系 |
|---|---|---|---|
| Kokoro | 82M / 7.4K | 引爆「小快 TTS」潮的标杆 | 最直接对标:Kokoro 许可更干净(纯 Apache 含权重)但 8 语言、无表情标签、无 11 平台原生、无 HYBE 背书;Supertonic 用「31 语言+44.1kHz+11 平台+表情」换「权重 OpenRAIL-M、克隆付费墙」。要纯开源选 Kokoro |
| F5-TTS | 中型 / 14.7K | flow-matching 零样本克隆 | 同 flow-matching 谱系但偏 GPU、模型大、强在 zero-shot 克隆;Supertonic 把同路线做「小+CPU 实时+ONNX 多平台」,克隆刻意阉割进付费。F5 研究/克隆向,Supertonic 部署/产品向 |
| Chatterbox / XTTS | 500M / 25K · 45.5K | 克隆 SoTA / 老牌全能 | 克隆质量高但模型大 5-8×(XTTS 已停更);Supertonic 固定音色场景 WER 已贴近 VoxCPM2,克隆推给 Voice Builder。差异是「小而广的固定音色 vs 大而强的克隆」 |
| Piper / KittenTTS | ~20-30M / ~15-25M | 嵌入式轻量 | 更小但语种少(Kitten 仅英语)、音质天花板低、无多语言一致路线 |
差异化护城河
小模型(99M) + 31 语言 + 44.1kHz 直出 + 11 平台原生 + 表情标签 + HYBE 背书与商业闭环,这个组合目前无对手全占。技术底座的护城河是「码点 tokenizer + 模型内建归一化 + flow-matching」让 host 极薄、移植极易。
竞争风险
- 长尾语种质量代价:#124 德语、越南语 WER 4.49、芬兰语 5.40——99M 容量摊到 31 语言,头部好尾部退化。
- 小型 flow-matching 长句漏读/跳读:#83,小生成模型固有失败模式(v3 已降低但未根除)。
- 权重 OpenRAIL-M 非纯开源 + 克隆付费墙:#5/#138 体验断层,Kokoro 的纯 Apache 是直接威胁。
- 跨平台镜像漂移:Rust chunker 已比 Python 多一层健壮性,无数值一致性校验机制;无 CI(无 .github),跨平台正确性靠人工跑 test_all.sh。
生态定位
第一方「单模型 + 多平台推理参考 + 开放权重获客漏斗」,与 voicebox 类「聚合多引擎的桌面 app」是不同物种——Supertonic 是被别人集成的底座(README「Built with Supertonic」已列 Transformers.js / MNN 移植 / Chrome 扩展 / Aftertone 等下游)。
套利机会分析
- 信息差:三条叙事线张力俱全——① HYBE/BTS 的 AI 棋局(娱乐巨头如何用开源模型铺商业产品);② 设备端 TTS 小型化/边缘化趋势(和 Kokoro 82M/Kitten 15M 放一起讲赛道);③ 99M 做 31 语言的质量代价(客观平衡)。中文圈对「码点 tokenizer 替代 g2p」「flow-matching host 控循环」「开放权重引流付费克隆」「归一化内建模型而非 host」的拆解稀缺。
- 技术借鉴:码点 tokenizer + 语言标签 token、host 控循环/ONNX 单步、多阶段独立 ONNX、条件向量外置 JSON、hub-and-spoke 镜像移植——可迁移到任何多语种小模型/设备端生成/跨平台 AI SDK。
- 生态位:填补「小模型 + 宽语种 + 11 平台原生 + 设备端」空白;与 Kokoro 错位(语种/平台广度 vs 纯开源)、与克隆向(F5/Chatterbox)错位(固定音色部署 vs 克隆)。
- 趋势判断:踩在「设备端/边缘 AI + 小模型 + 隐私优先」趋势上;长期看「长尾语种质量提升 + 漏读根除 + 克隆是否开放 + 是否补技术报告/CI」决定其口碑与采用深度。
风险与不足
- 长尾语种质量退化:头部强、尾部(德语/越南语/芬兰语)WER 明显偏高,是 99M 摊 31 语言的必然。
- 小型 flow-matching 漏读/跳读:长句失败模式未根除(#83)。
- 权重非纯开源 + 克隆付费墙:代码 MIT 但权重 OpenRAIL-M、克隆走 Voice Builder $50,与纯开源 Kokoro 有战略分野。
- 无 CI、测试弱:无 .github、仅交互式 test_all.sh 冒烟,无单测/无 golden-audio 回归/无跨平台数值一致性校验;镜像维护已现漂移。
- 归一化不可控:内建模型而非 host normalizer,不可调、随长尾语种退化(README 货币样例只展示英文)。
- 轻仓库重模型:核心价值在 HF LFS 权重,本仓只是可移植性证明——真正能力的演进不在这个仓库。
行动建议
- 如果你要用它:适合浏览器扩展/电子书/本地 agent/Electron/边缘设备开发者——任何要离线、隐私、低延迟、可嵌入任意运行时的语音合成。
pip install supertonic+supertonic serve(OpenAI 兼容端点)最快上手。注意:头部语言(英/韩/日)质量好、长尾语言(德/越/芬)退化需实测;要克隆/zero-shot 得用付费 Voice Builder;要纯开源权重选 Kokoro。 - 如果你要学它:直奔
py/helper.py(4 段 ONNX 管线 + 码点 tokenizer + flow-matching for 循环,规范参考)+py/example_onnx.py(入口)+ 对照rust/src/helper.rs或web/helper.js(跨平台镜像 + chunker 漂移)+ 4 篇 arXiv 论文(SupertonicTTS/LARoPE 是对齐核心创新)。体量小(9.9K 行),适合通读学「小模型多语言 + ONNX 跨平台」范式。 - 如果你要 fork / 借鉴它:码点 tokenizer + 语言/控制标签 token、host 控循环/ONNX 单步、条件向量外置 JSON、hub-and-spoke 镜像移植是可直接迁移的设计。代码 MIT 友好;但模型权重 OpenRAIL-M(负责任使用条款约束)、克隆能力不在开源范围——商用前看清 license 边界。
知识入口
| 资源 | 链接 |
|---|---|
| HuggingFace 模型 | https://huggingface.co/Supertone/supertonic-3(权重 + license + v2→v3 差异 + benchmark) |
| 在线 WebGPU Demo | HF Space Supertone/supertonic-3(浏览器内直接试听) |
| 音频样例 demo 页 | https://supertonic3.github.io/(RTF/体积对照 + 各语种样例) |
| DeepWiki | https://deepwiki.com/supertone-inc/supertonic(4 段 ONNX 流水线 + hub-and-spoke 架构,架构速读首选) |
| 论文 | arXiv 2503.23108 SupertonicTTS / 2509.11084 LARoPE / 2509.19091 Self-Purifying Flow Matching / 2605.22083 RobustSpeechFlow |
| 生产 SDK | pip install supertonic(supertonic-py,含 supertonic serve OpenAI 兼容端点) |