2.5 个月 10.9k stars:单人 98% 主导的 turbovec 怎么把 Google 论文做成 FAISS 的 ARM 杀手
一句话总结
把 Google Research 2025 的 TurboQuant 量化算法工程化为一个「纯本地、in-process、SIMD 加速」的 Rust + Python 向量索引库,d=1536 时把 100K 向量从 76 MB 压到 7.36 MB(10.3×),单线程 ARM 上比 FAISS IndexPQFastScan 快 10-19%,且对 LangChain / LlamaIndex / Haystack / Agno 提供 drop-in 替换。
值得关注的理由
- 算法新鲜 + 工程极致:上游 TurboQuant 论文(arXiv:2504.19874,ICLR 2026)才出来不到一年,作者把 per-vector length-renormalization 这一数学技巧写进 Rust SIMD kernel,召回率比 FAISS IndexPQ(LUT256, nbits=8) 还高 0.8-1.7pp。
- 极小窗口完成破万星:2.5 个月、29 个 tag、单人主导 98% commit、月均 60 commit,刷新了「小而尖 RAG 基础设施」的天花板。
- 稀缺生态位:在「极致压缩 + 纯本地 + in-process 库」这个象限,没有强对手。FAISS 大而全、Qdrant 是服务、cuvs 要 GPU、hnswlib 不压缩——turbovec 填补了「不连云、不上服务器、压缩 8-80 倍」的真实缺口。
- 诚实 baseline + 可机器化复现:
benchmarks/results/*.json全部公开,且kernel_xtest强制跨架构返回等价 top-K 集合——这是为数不多你能在自己机器上跑一遍验证 README 数字的 ANN 库。
项目展示
README 媒体
 — 类型: hero
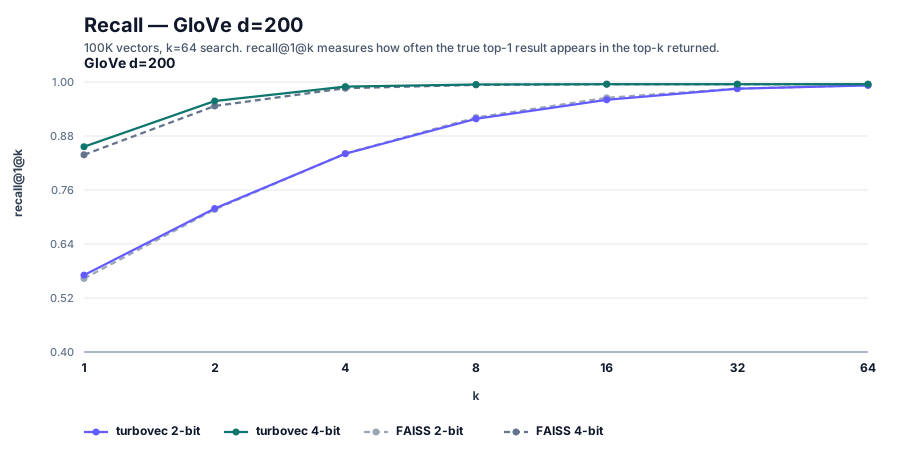 — 类型: 基准测试图表(召回率)
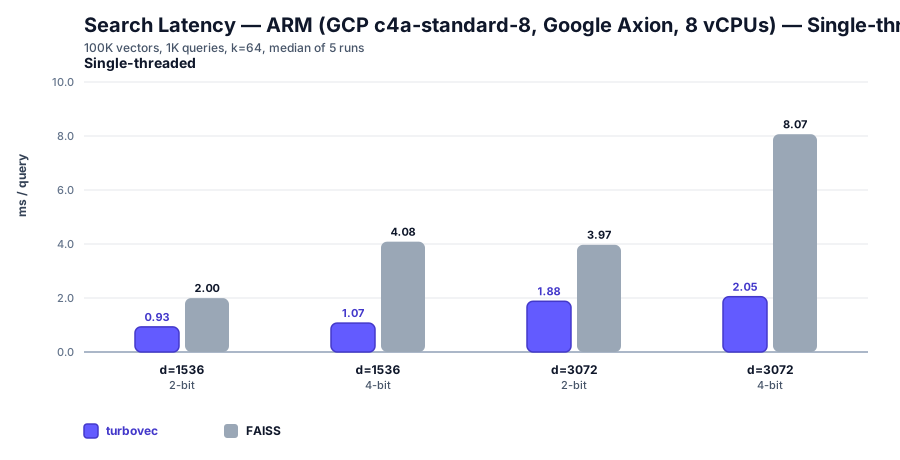 — 类型: ARM 单线程性能
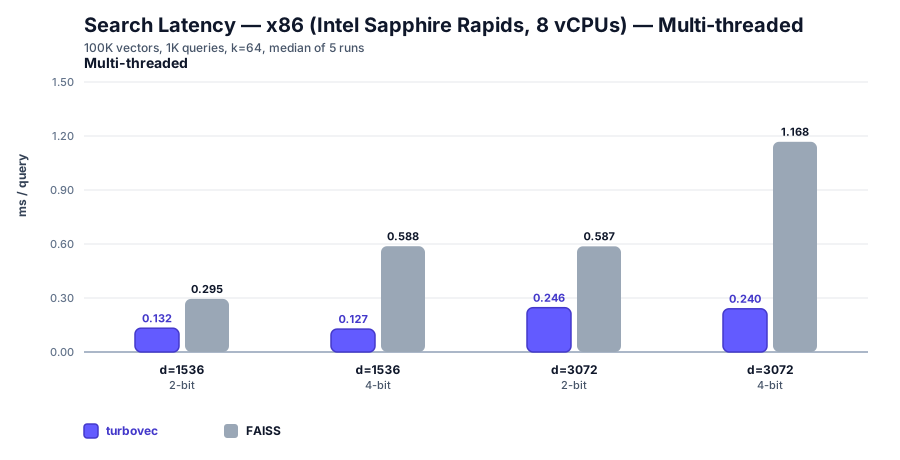 — 类型: x86 多线程性能
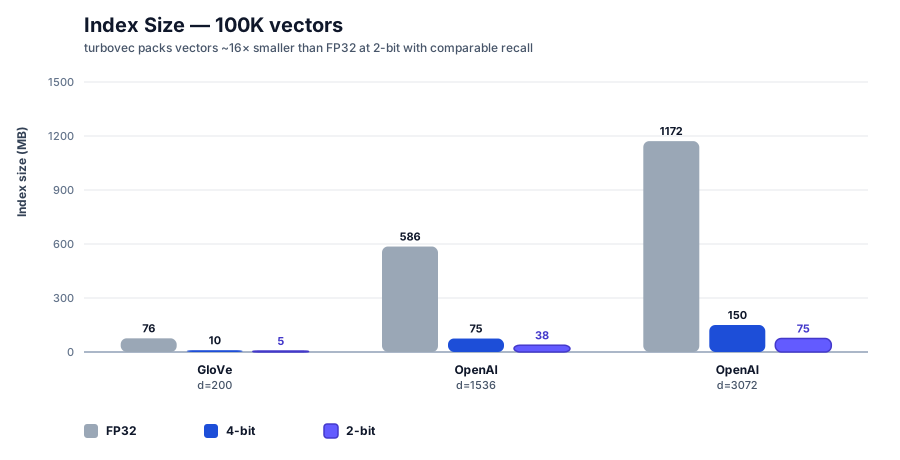 — 类型: 压缩比展示
官网指向 PyPI 页面(https://pypi.org/project/turbovec/),无独立官网;其余 4 张同类型图表(d=1536/d=3072 recall、arm_mt、x86_st)已被合并到这 5 张代表样本中。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/ryancodrai/turbovec |
| Star / Fork | 10,927 / 939(Star/Fork = 11.6,健康) |
| Watcher | 45(偏低,说明多数是路过型 star) |
| 代码行数 | 14,839(Python 50.4% / Rust 42.9% / SVG 3.8% / JSON 2.2% / TOML 0.7%) |
| 文件数量 | 115(Rust 29 + Python 41 + 其它) |
| 代码/注释比 | 4.9:1(注释占 20.3%,成熟库水准) |
| 项目年龄 | 2.5 个月(首次提交 2026-03-26) |
| 总 commit | 152(近 30 天 42,月度 38 → 71 → 35 → 8) |
| 开发阶段 | 密集开发(pre-1.0 冲刺期) |
| 开发模式 | 职业项目(周末 15.1%、深夜 18.4%,均落职业区间) |
| 贡献模式 | 单人主导(4 名贡献者,主作者 98.2%) |
| 热度定位 | 大众热门(2.5 个月破万星) |
| 依赖 | 10 个 runtime(来源: Cargo.toml) |
| License | MIT |
| 最新版本 | v0.9.0(Rust crate) / v0.8.0(Python 包),共 29 个 tag,semver 双轨发布 |
| 质量评级 | 代码[优秀] 文档[优秀] 测试[充分](含 kernel_xtest 跨架构一致性测试) |
作者视角:为什么存在这个项目
创始人/作者背景
Ryan Codrai(@ryancodrai)是 2015-02 入驻的老 GitHub 用户,11 年账号、5 个公开仓库、283 粉丝。公开仓库矩阵揭示其方向是「ML/IR 独立研究者」:gemma-emotional-probes(模型情感可解释性)、sourced / intuitive-ml / llm-essentials(数据/ML/教学方向)、turbovec(向量索引)。bio/company/blog 全空,没有大公司背书,但账号历史 11 年稳定活跃——这是一个长期深耕 ML 工程的独立技术型作者,不是新冒出来的「追热点的纯流量玩家」。
问题判断
作者看到了一个真实的「隐私敏感 RAG 团队」痛点:
- 2024-2025 年 RAG 工程栈严重依赖 Qdrant / Weaviate / Pinecone 这类托管向量数据库,意味着客户数据出 VPC。
- 走「纯本地 + in-process」路线的 FAISS 又有三个问题:① Python wrapper 较厚、API 不友好 ② ARM SIMD 优化深度不够 ③ 内存占用大(默认 FP32)。
- TurboQuant 算法(arXiv:2504.19874,Google Research,ICLR 2026)刚好提供了一个「2-bit 量化且无偏内积估计」的数学新基础——这正是当下 RAG 端侧化、私有化、轻量化浪潮需要的理论原语。
时机判断:论文刚发,第一波工程实现窗口期。先动手的人可以定义「什么是好的 TurboQuant 实现」。
解法哲学
作者明确选择了「不做什么」,这往往比 feature 列表更有价值:
- 不做训练阶段(add 即索引,无 retrain)——与 HNSW 的「建图即训练」路线切割
- 不做云服务(pure local,无 managed)——与 Qdrant/Meilisearch 路线切割
- 不做大而全(只做量化索引,过滤、持久化交给框架集成)——与 FAISS 的「大而全」路线切割
- 不做 GPU 加速(专注 CPU SIMD:NEON/AVX-512BW/AVX2)——与 cuvs 路线切割
对应地,作者明确要做的:
- Drop-in 兼容四大 RAG 框架(LangChain/LlamaIndex/Haystack/Agno)——把工程精力押在「用户迁移成本最低」上
- 诚实 baseline 对比(不是
IndexFlatL2这种纸靶子,而是IndexPQ(LUT256, nbits=8)这种 production-grade 对手)——把可信度押在「数字经得起复现」上 - 跨架构字节级一致性(
kernel_xtest)——把「多平台」从口号变成可机器化验证
战略意图
这是一个职业型独立开发者的「准商业化」OSS:
- License 选 MIT 而非 AGPL——为后续 SaaS / 企业版留口子
- 「AI 写的 PR 不接受 cold submission」明确写在 CONTRIBUTING.md——拒绝 LLM-on-LLM 协作、把质量闸握在自己手里
- Node.js binding(Issue #85)已被作者提上日程——多语言绑定铺开是商业化的前奏:先做 Rust + Python 占住科研/ML 圈,再做 Node 占住 Web/JS 圈,最后看企业版
- 没有公开融资信号,目前仍处于「项目吸量 + 个人品牌建设」阶段
外部深度视角:未找到针对 turbovec 项目本体的独立第三方深度分析文章。TurboQuant 算法论文(arXiv:2504.19874,Amir Zandieh et al., Google Research, 2025-04-28)是该项目作为”上游理论”引用的——该论文本身是”独立深度视角”的最佳替代。
核心价值提炼
创新之处
按新颖度 × 实用性排序:
-
Length-renormalized scoring 在编码时算、搜索时零成本乘(新颖 4/5,实用 5/5,可迁移 4/5)
- 数学原理:标量量化器有系统下偏,作者用
1.0 / <u, x̂>做 per-vector 补偿,把补偿系数在encode.rs末尾算好,存到scales: Vec<f32>,搜索时 SIMD 一次乘到 32 lane - 价值:搜索路径「零运行时开销做无偏内积估计」——这是把论文数学变成工程现实的关键一刀
- 数学原理:标量量化器有系统下偏,作者用
-
6 步编码 pipeline 三 pass 融合(quantize → scale → pack 零中间分配)(新颖 3/5,实用 5/5,可迁移 5/5)
- 价值:aarch64 上 8 lane 一次比较 + 加权 bit-pack,避免中间
Vec<u8>分配 - 借鉴意义:所有「多阶段 SIMD 计算 + 内存写入」场景都能套这个模板
- 价值:aarch64 上 8 lane 一次比较 + 加权 bit-pack,避免中间
-
三层 filter short-circuit(pair → block → slot)(新颖 4/5,实用 5/5,可迁移 4/5)
- pair-level(AVX-512 专用):一次查 64 向量对应 u64 word
- block-level(所有 SIMD):查 32 向量对应 word 的低/高 32-bit,全 0 则
continue - slot-level(per-lane):AVX2 路径上用
_mm256_movemask_ps+trailing_zeros跳过非命中 lane,连block_out内存回写都省 - 价值:selective 检索 6.4× ARM / 12.7× x86 加速
-
Periodic flush (
FLUSH_EVERY=256) + 统一 max_lut=127(新颖 3/5,实用 4/5,可迁移 4/5)- 这是 v0.6.0 修复 x86 召回率落后 ARM 5.5pp 的核心改动
- 借鉴意义:所有「u8 累加器 + SIMD LUT」场景都该有 flush 策略
-
OnceLock+&self搜索实现多线程并发零锁(新颖 3/5,实用 5/5,可迁移 5/5)search签名是&self(不是&mut self),配合OnceLock::get_or_init实现多线程并发搜索无锁- 借鉴意义:所有「懒构造大对象 + 频繁只读访问」场景都能套
-
三路径 SIMD kernel(NEON / AVX-512BW / AVX2 fallback)共用同一组 per-flush fmadd 数学结构(新颖 3/5,实用 4/5,可迁移 4/5)
- 价值:跨架构 score 集合一致(
kernel_xtest可证)——NEON 和 AVX2 的 FMA 顺序不同导致 1.25% 邻近 rank tied-swap,但集合等价就够了
- 价值:跨架构 score 集合一致(
可复用的模式与技巧
-
「算法 → 工业实现」的可借鉴骨架:理论论文(TurboQuant arXiv:2504.19874)→ Rust crate 的完整路径(lib.rs/api/error/io/format versioning 都有)。当你要落地一篇算法论文时,按这个骨架照抄:核心代码 + 公开 API + 错误枚举 + IO/格式版本 + 一致性测试 + benchmark 套件。
-
#[non_exhaustive]错误枚举:保证未来加 variant 不破坏下游,所有公开 Rust enum 都该这么做。 -
v2→v3 加载兼容 + 显式 identity 填充:版本迁移时不要让「加载老文件 + 写入新数据」产生隐式 calibration 漂移——
from_parts集中 assert 三者关系(packed_codes.len / scales.len / TQ+ shift.len)。 -
跨架构一致性测试工具(
kernel_xtest+dump_state):为「不同 SIMD 路径应该返回等价结果」提供可机器化验证——所有做 SIMD 的人都该有这套。 -
Filter short-circuit 多层短路:在 selective 检索下 6-12× 加速——任何带 filter 的搜索/扫描场景都能借鉴。
-
框架集成的 side-car + handle-mapping 校验:JSON 侧车与二进制 index 必须在 load 时就一致校验,不要等到 query 时 KeyError。所有「二进制主体 + 文本侧车」的双文件设计都该这么做。
-
CONTRIBUTING.md 公开反对 cold AI PR:明确设计上下文在 review 中不可替代,是有意识的治理决策——值得所有中小型 OSS 项目抄。
-
Encode 路径上计算 + scale + pack 三 pass 融合:aarch64 上避免中间
Vec<u8>分配——所有「多阶段 SIMD 计算 + 内存写入」场景都该套这个模板。
关键设计决策
-
决策: 用 TurboQuant 2-bit 量化 + per-vector length-renormalization
- 问题: 2-bit 标量量化器系统下偏会破坏内积估计,导致召回率崩溃
- 方案: 编码时算
||v|| / <u, x̂_orig>存到 scales,搜索时一次 SIMD 乘做无偏修正 - Trade-off: 多存一份 f32 scales(每向量 +4 字节,相对 4-bit 是 +25%,相对 2-bit 是 +100%);换来 0.8-1.7pp 召回率提升
- 可迁移性: 高(任何标量量化器都能套这个补偿公式)
-
决策: NEON/AVX-512BW/AVX2 三套 kernel + 标量 fallback
- 问题: 单一 SIMD 路径无法覆盖 Apple Silicon / 现代 x86 / 老 x86 / 边缘设备
- 方案:
cfg(target_arch)+is_x86_feature_detected!编译期 + 运行期特性探测 - Trade-off: 维护 3-4 套 kernel 的代码负担;换来「任何现代 CPU 都能跑出接近理论峰值的性能」
- 可迁移性: 中(需要重新写 kernel,但组织结构可借鉴)
-
决策:
.tv(核心索引)+.tvim(id 映射)双文件格式- 问题: 单文件 IO 在大索引 + 频繁 id 重映射场景下不灵活
- 方案: 核心量化数据 + id 映射分离,可独立加载
- Trade-off: 多一个文件 + 一致性校验负担;换来「重建 id 映射不必重新量化」
- 可迁移性: 高(所有「二进制主体 + 灵活 id 映射」场景可借鉴)
-
决策: 搜索签名是
&self+OnceLock懒构造- 问题: 频繁并发搜索场景下「read/write 锁」开销不可接受
- 方案:
OnceLock::get_or_init+ 替换而非修改底层数据 - Trade-off:
add路径必须重建整个 blocked 缓存(首次搜索慢);换来「任意数量线程并发搜索零锁」 - 可迁移性: 高(任何「懒构造大对象 + 频繁只读 + 偶尔重建」场景)
-
决策: 量化 calibration 锁定 5/95% 分位数映射到
Beta((d-1)/2, (d-1)/2)- 问题: 标量量化器边界点选择决定召回率,需要数学先验
- 方案: min 1000 样本阈值 + 首 add 拟合、后续 add 冻结复用
- Trade-off: 增量 add 不能在线更新 calibration(需重建索引);换来「数学先验保证,召回率稳定」
- 可迁移性: 中(数学部分通用,工程集成需适配)
-
决策: 与 production-grade FAISS
IndexPQ(LUT256, nbits=8)而非IndexFlatL2做 baseline- 问题: 纸靶子对比是营销话术,但生产环境没人用纸靶子
- 方案: 选 FAISS production 默认配置做对比,且结果 JSON 公开
- Trade-off: 在 4-bit @ d=1536 上偶尔输给 FAISS 0.3-3%(CHANGELOG 诚实标注);换来「数字经得起复现,营销话术退场」
- 可迁移性: 高(所有做性能宣传的项目都该这么做)
竞品格局与定位
竞品对比矩阵
| 维度 | turbovec | faiss (Meta) | qdrant (Rust) | cuvs (NVIDIA) | hnswlib |
|---|---|---|---|---|---|
| Stars | 10.9k | 40.3k | 32k | 781 | ~4k |
| 形态 | in-process 库 | in-process 库 | 向量数据库服务 | GPU 库 | in-process 库 |
| 内存压缩 | 8-80×(量化) | 4-32×(PQ/BQ) | 中等(payload filter 重) | 无(GPU 显存) | 1×(无压缩) |
| ARM SIMD | NEON 内核 | 标量 + 一些 SSE | 通用 | 不适用 | 无 |
| x86 SIMD | AVX-512BW + AVX2 | AVX2 | AVX-512 | 不适用 | 标量 |
| GPU 加速 | 否 | 是(CAGRA) | 否 | 是(核心) | 否 |
| Filter 短路 | 3 层(pair/block/slot) | 1 层(block) | payload-based | 弱 | 无 |
| 持久化 | .tv/.tvim | 手动 | 内置 | 无 | 手动 |
| 框架集成 | 4 框架 drop-in | langchain 弱 | 强 | 弱 | 弱 |
| 训练阶段 | 无(add 即索引) | HNSW 需建图 | HNSW 需建图 | HNSW 需建图 | HNSW 需建图 |
| 上手成本 | 低(10 行 demo) | 中(C++ 编译链) | 中(需部署服务) | 高(CUDA 依赖) | 低 |
| License | MIT | MIT | Apache-2.0 | Apache-2.0 | Apache-2.0 |
差异化护城河
- 技术护城河:ARM NEON SIMD 内核 + 2-bit 量化 + length-renormalization。FAISS 在 ARM 上的 SIMD 优化深度确实不如 turbovec,10-19% 速度优势是经过 benchmark 验证的。
- 生态护城河:4 大 RAG 框架的 drop-in 兼容 + side-car 一致性校验,是真实「逐字段对照参考实现」做的(CHANGELOG 0.7.0 一次修了 4 个框架的 fidelity bug),不是表面 API 模仿。
- 信任护城河:诚实 baseline 对比 +
kernel_xtest跨架构字节级一致性测试 + 公开 benchmark JSON。这是为数不多你能在自己机器上跑一遍验证 README 数字的 ANN 库。
竞争风险
- 最大风险:FAISS 跟进 ARM SIMD 优化 + TurboQuant 算法集成(FAISS 团队有 Google 关系,可能拿到 TurboQuant 论文作者支持)。但 ARM SIMD 内核的工程深度是 FAISS 团队少有投入的领域,短期 1-2 年内不太可能追上。
- 次大风险:Qdrant / Weaviate 增加「纯本地 + 量化」模式(这俩本来就有产品 + 社区,但「in-process 库」与「DB 服务」的产品形态根本不同,迁移需要重写)。
- 小风险:hnswlib 增加量化(hnswlib 节奏慢,且 1× 内存 vs 8× 压缩的诱惑不大)。
- 不可抗风险:Google 官方出 TurboQuant 官方实现(与本项目非零和,作者已声明是借鉴论文而非原作)。
生态定位
在整个 AI 基础设施生态中,turbovec 扮演「RAG 落地的最后一公里」角色:
- 训练/Embedding 模型:Sentence-Transformers / OpenAI Embeddings
- 向量索引:turbovec(pure local)← 这是它
- 向量数据库服务:Qdrant / Weaviate(云端 / VPC)
- RAG 框架:LangChain / LlamaIndex / Haystack / Agno
它填补的空白是「端侧 RAG」(手机、嵌入式、air-gapped 设备、隐私敏感部署)的关键基础设施——FAISS 太大、Qdrant 需服务、cuvs 要 GPU,turbovec 是「端上唯一可用的量化向量索引」。
综合:turbovec 在「极致内存压缩 + 纯本地 + in-process 库 + CPU SIMD 加速」这个象限是相对蓝海;与 FAISS/Qdrant 形成清晰分工(库 vs 服务),与 cuvs 错位(CPU vs GPU),与 hnswlib 错位(量化 vs 图)。
套利机会分析
- 信息差: 低关注度但高质量的反面——是「高曝光的潜力股」。10.9k stars 在 2.5 个月内达成,已经被广泛发现。但**「ARM 端向量索引」这个细分需求**仍处于早期,多数人还不知道,端侧 RAG 创业者会从这篇分析里找到。
- 技术借鉴: 6 步编码 pipeline + length-renormalization + 三层 filter short-circuit +
OnceLock懒构造 + 跨架构一致性测试——这五项是 ANN 之外的通用工程模式,任何做 SIMD 加速 / 多线程库 / 量化工程的项目都能借鉴。 - 生态位: 填补了「端侧 RAG」的基础设施空白——手机/嵌入式/隐私敏感部署唯一可用的量化向量索引。在隐私计算、边缘 AI、air-gapped 部署三个赛道是必须知道的库。
- 趋势判断: ① 端侧 AI / 边缘 AI 趋势明确(Apple Intelligence、Qualcomm AI Hub、嵌入式 LLM 都在涨)→ 端侧 RAG 是下一个 ② 隐私敏感 RAG(医疗、法律、金融、企业内部)需求明确 → 纯本地量化是刚需 ③ TurboQuant 论文刚发,第一波工程实现窗口期仍在(半年内不会有第二个有同等深度的实现)→ 比 FAISS 有 2-3 年的后发优势。
风险与不足
- 作者背景无法交叉验证:bio/company/blog 全空,没法从外部证实其 ML/IR 领域背书。11 年账号 + 5 个相关仓库是间接证据,但如果你要做企业采购决策,还需要更深的尽职调查。
- 单人主导 98%:4 名贡献者各仅 1 commit,项目命运与作者精力强绑定。如果作者 burnout 或转向,这个项目可能进入「低维护」状态——已经在
core_files中看到README.md高频修改(71 次)的「单点风险」信号。 - Issue #37 揭示的精度 trade-off:4-bit 低维下 LUT 近似 vs 精确计算有 1.4pp 召回率差距。这意味着在低维(d ≤ 256)场景,turbovec 不一定是最佳选择——
pynndescent可能在 d=200 GloVe 上更稳。 - pre-1.0 阶段 0.9.0:版本号 + 「Development Status: 3 - Alpha」明确说明 API 不稳定。生产环境用需要锁定版本 + 监控升级 breaking change。
- CUDA 路径缺失:在大规模 ANN(>10M 向量)场景,cuvs 的 GPU 加速可能比 turbovec 的 CPU SIMD 快 10×+。turbovec 不适合 GPU server 场景。
- 生态尚浅:4 个框架集成是「基础够用」,但距离 FAISS 的「全框架全语言」生态还有 2-3 个数量级的差距。
- CHANGELOG 0.7.0 v2→v3 加载 + add 静默错误的故事说明:在跨版本边界仍有未发现的边界条件。长期生产使用需要持续盯 CHANGELOG。
行动建议
-
如果你要用它:
- 适合场景:端侧 RAG(手机/嵌入式)、隐私敏感 RAG(医疗/法律/金融)、air-gapped 部署、单租户小规模(<10M 向量)、需要 ARM 上的极致性能
- 不适合场景:GPU server 大规模 ANN、d ≤ 256 的低维场景、需要 HNSW 极致召回率的场景
- 对比说明:选 turbovec 而不是 FAISS 的理由 = ARM 性能、纯本地、drop-in 兼容、低内存;选 FAISS 而不是 turbovec 的理由 = 生态成熟、多语言绑定、GPU 加速、社区大
-
如果你要学它:
- 必读文件:
turbovec/src/search.rs(1857 行,三套 SIMD kernel + 标量 fallback,真正的核心代码热点)turbovec/src/encode.rs(6 步编码 pipeline,length-renormalization 在这)turbovec/src/rotation.rs(确定性正交矩阵:ChaCha8RNG + faer QR + sign-correction,种子 = 42 保证可复现)turbovec/src/codebook.rs(Lloyd-Max 标量量化器,Beta 分布)turbovec-python/src/lib.rs(PyO3 绑定最佳实践)turbovec/examples/kernel_xtest.rs(跨架构一致性测试范例)docs/api.md(200+ 行完整 Python API 参考)
- 重点关注模块:
- SIMD kernel 的 nibble-LUT 累加模式(FAISS FastScan 风格)
- 6 步编码 pipeline 的 pass 融合技巧
- 跨架构一致性测试的设计哲学(不追求 scores bit-exact,追求集合等价)
- 必读文件:
-
如果你要 fork 它:
- 可改进的方向:
- 加 CUDA backend(cuvs 是反面教材,turbovec 可以走「CPU 极致 + GPU 加速」双路径)
- 加 HNSW 索引作为可选后端(对低维 + 高召回率需求)
- 加 GPU quantization(NVIDIA 的 cuML/CUTLASS 有现成算子)
- 加增量 calibration 更新(现在 add 冻结 calibration,对数据漂移场景不友好)
- 加 binary index format 升级到 v4(v3 已经 4 个月没变,CHANGELOG 没说原因)
- 加增量压缩(不同向量不同 bit 数)(对数据分布不均的语料有 2-3× 空间)
- 加 wasm 编译目标(如果能解决 64-bit usize 假设,
compile_error!那个限制)
- 可改进的方向:
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 未收录(页面只显示 Loading 状态) |
| Zread.ai | 未收录(HTTP 403) |
| 关联论文 | TurboQuant: A fast data oblivious quantizer for high dimensional vectors (arXiv:2504.19874) — Google Research, Amir Zandieh et al., 2025-04-28, ICLR 2026 |
| 在线 Demo | 无(项目为本地库,PyPI 主页 https://pypi.org/project/turbovec/ 是文档入口) |
| 官方文档 | docs/api.md(仓库内)+ docs/integrations/{langchain,llama_index,haystack,agno}.md |
| 可机器化复现 | benchmarks/results/*.json(公开 JSON,可自行跑 benchmarks/suite/*.py 验证) |