GitHub推荐:12.8K星的LingBot-Map:三层记忆如何重建万帧世界
一句话总结
LingBot-Map 是一套面向长视频的单目流式 3D 重建基础模型:它用「尺度锚点 + 近期稠密窗口 + 长期轨迹摘要」三级记忆和 paged KV cache,把静态多视图 Transformer 改造成可逐帧输出相机轨迹、深度与点云的系统,但现阶段仍是介于 3D 基础模型与完整 SLAM 之间的几何前端,不能替代回环与全局图优化。
值得关注的理由
- 90 天左右冲到 12.8K stars,且不只是论文壳仓:截至 2026-07-18,项目有 12,848 stars、1,337 forks;仓库同时开放模型代码、benchmark、交互式点云查看器和超长序列渲染链,工程深度明显超过只放推理脚本的论文配套项目。
- 真正的技术价值是「几何语义驱动的缓存系统」:它没有粗暴保留全部历史帧,而是把初始尺度帧、近期稠密 patch、全历史特殊 token 分配到不同生命周期的缓存;再用临时写入—提交/回滚协议,让非关键帧照常输出却不进入长期状态。
- 处在 3D 基础模型走向机器人实时感知的关键交叉点:VGGT、DUSt3R 证明了统一几何模型的潜力,传统 SLAM 则证明了回环与全局一致性的必要性。LingBot-Map 正在两者之间探索一条流式路线,其优势和短板都足够鲜明,适合学习,也适合做混合系统。
项目展示
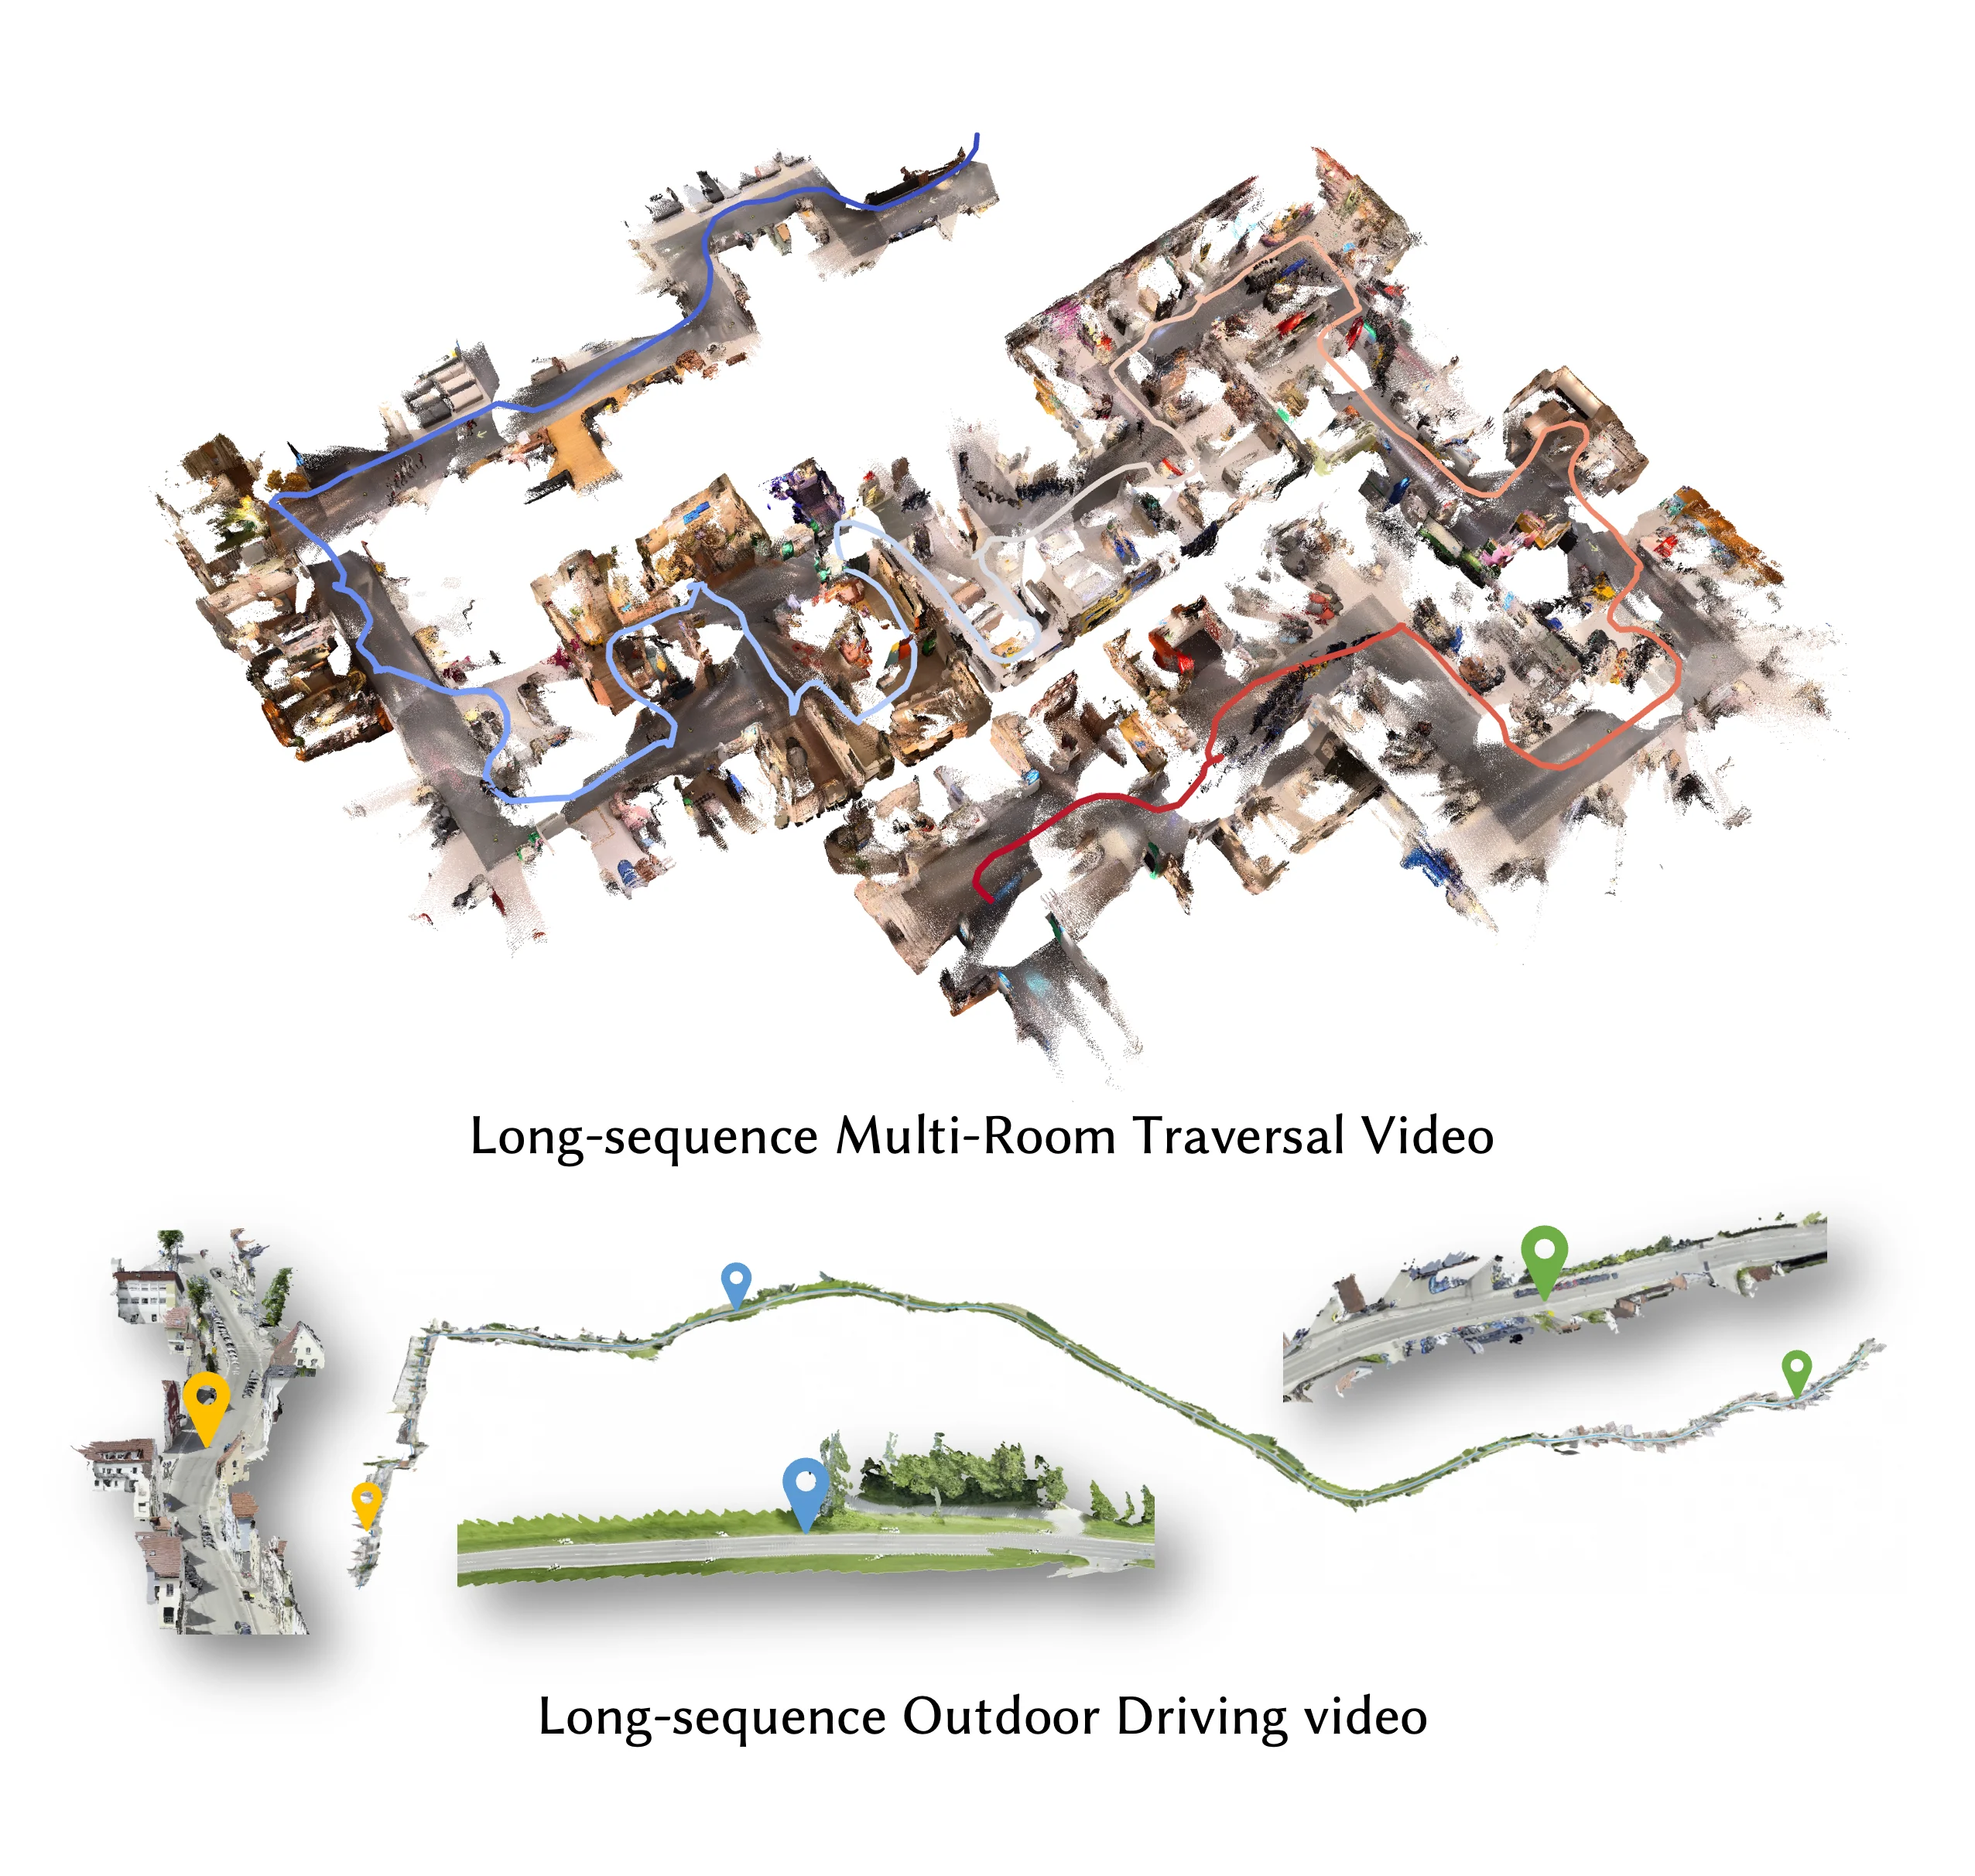
项目主视觉展示了从连续图像到相机轨迹、深度和稠密点云的流式重建流程。
多房间、航拍、驾驶和漫游场景的视频演示见 LingBot-Map 官方项目页。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/robbyant/lingbot-map |
| Star / Fork | 12,848 / 1,337(2026-07-18) |
| 代码行数 | 24,172 行(Python 92.7%,JavaScript 3.3%,CSS 1.7%,YAML 1.1%) |
| 项目年龄 | 约 3.1 个月(首个 commit:2026-04-16) |
| 开发阶段 | 密集开发(103 commits;近 30 天 19 次,近 90 天 73 次) |
| 贡献模式 | 核心作者主导:5 个 git identity;合并疑似重复身份后,核心作者约占 85.4% |
| 热度定位 | 大众热门(约 90 天积累 12.8K stars) |
| 质量评级 | 代码[良好] 文档[良好] 测试[不足] CI[无] |
代码规模统计不含空行与注释。项目共 128 个源代码文件,运行时依赖 23 个;注释约占 12%。仓库没有 git tag,采集时也未探测到正式 Release,复现时应固定 commit hash。
作者视角:为什么存在这个项目
创始人/作者背景
项目发布主体是 Robbyant 机构账号,官方技术站为 technology.robbyant.com。公开资料将其置于蚂蚁集团的具身智能技术布局中;LingBot 系列还覆盖视觉、深度、世界模型和机器人动作等相邻方向。论文与提交记录显示 Lin-Zhuo Chen 是核心作者:GitHub API 将约 88 / 103 次提交归入其账号,其他贡献主要来自少量合作者。
这意味着 LingBot-Map 不是偶然走红的个人 demo,而是机构研究栈中的一块基础设施;同时,高度集中的贡献结构也说明它仍处于「核心研究者驱动」而非成熟社区治理阶段。GitHub 公开位置字段为空,因此不对个人履历和团队所在地作进一步推断。
问题判断
团队看到的核心矛盾是:静态多视图基础模型已经能提供强几何先验,但其全局注意力和输入长度无法自然扩展到长视频。
- 离线 Transformer 若保留所有 patch token,内存和计算会随帧数持续增长;
- 只看最近短窗口,容易丢失初始尺度、坐标锚点和远程轨迹线索;
- 成对图像方法通常还需要后续全局对齐;
- 传统 SLAM 有成熟的回环和图优化,却依赖多组件管线,不是统一的 feed-forward 几何模型。
时机之所以成熟,是因为 DINOv2/VGGT 已提供可复用的视觉与几何表征,PyTorch SDPA 提供通用注意力实现,FlashInfer 又把 LLM 时代的 paged KV cache 基础设施带到可编程 GPU 推理中。LingBot-Map 的关键尝试,是把这些条件组合成视觉几何的长序列状态机。
解法哲学
项目选择的是「统一学习优先,再用受控状态实现流式化」,而不是从第一天就构造完整 SLAM:
- 性能优先,但不锁死高速后端:FlashInfer 负责高性能 paged cache,原生 SDPA 保留兼容路径;
- 允许有损压缩历史:旧帧稠密 patch 可以被驱逐,但低带宽的相机、尺度和 register token 长期保留;
- 输出与记忆解耦:非关键帧仍产生完整 pose/depth/points,只是不写入持久上下文;
- 把稳定性边界显式交给参数:初始尺度帧、滑动窗口、关键帧间隔、窗口 overlap 和相机细化次数都可调;
- 明确没有解决的部分:代码没有内置 loop closure 或 global pose graph。项目的流式记忆是学习式上下文,不是传统 SLAM 后端的等价物。
这种取舍换来了研究灵活性和较强的单模型表达,但用户也必须理解训练长度、缓存预算、关键帧密度和窗口重置之间的关系。
战略意图
仓库采用 Apache-2.0,模型、论文、benchmark、Demo 数据和可视化链同时公开;README 还展示了对 LingBot-World 生成视频的重建。这说明 LingBot-Map 更像 Robbyant 具身智能栈中的几何感知基座与评估组件:它既可以处理真实视频,也能为世界模型生成内容提供相机与空间结构解释。
但项目没有公开正式路线图、企业版、托管服务或 open-core 边界,不能据此推断具体商业模式。当前最关键的战略选择是:继续把流式基础模型做深,还是加入回环检测和全局位姿图,向完整 SLAM 系统扩展。
核心价值提炼
创新之处
-
三级几何上下文的两流 paged cache — 新颖度 5/5|实用性 4/5|可迁移性 4/5
初始尺度 patch 常驻、近期稠密 patch 循环复用、全历史特殊 token 追加保存。真正新颖的不是使用 Transformer,而是把几何语义、信息密度和内存生命周期绑定到一起。 -
每层共享页拓扑,每帧只规划一次 FlashInfer attention — 新颖度 4/5|实用性 4/5|可迁移性 3/5
所有 Transformer 层在同一帧使用一致的 page ID 布局,由第一层建立 attention plan,其余层复用;一页恰好容纳一帧 patch,减少 padding 与重复规划。 -
「不持久化,但不丢输出」的关键帧协议 — 新颖度 4/5|实用性 5/5|可迁移性 5/5
非关键帧照常读取历史并完成推理,只跳过持久写入。paged backend 通过临时 append、attention、commit/rollback 实现事务语义,适合所有「每步都要响应,只有部分步骤值得记忆」的在线模型。 -
重叠关键帧驱动的窗口 Sim(3) 对齐 — 新颖度 3/5|实用性 4/5|可迁移性 4/5
窗口间用共同关键帧确定旋转和平移,再以多个重叠关键帧的深度中位比估计尺度,并将同一变换同时应用到 pose、depth 和 points。它避免了完整全局优化,但仍会累积窗口链式误差。 -
几何运动驱动的缓存事务 — 新颖度 4/5|实用性 3/5|可迁移性 4/5
实验性 v2 流程先完成当前帧推理,再由 pose 与 depth 估计运动诱导光流,以此决定提交还是回滚该帧缓存。相比固定时间间隔,它让场景几何变化直接参与内存调度;但错误的深度或位姿也可能反向污染选帧。 -
面向超长几何序列的共享内存渲染流水线 — 新颖度 3/5|实用性 4/5|可迁移性 5/5
主进程负责 GPU 端 LOD 与视锥裁剪,只把当前可见点通过精确大小的 SharedMemory 交给 Open3D worker,并设计崩溃清理。这不是 GCT 算法创新,却是把研究输出变成可观看长视频的重要工程补全。
可复用的模式与技巧
- 锚点—窗口—摘要三级记忆:不可丢基准、近期高保真状态和长期低带宽摘要分别配置生命周期,适用于长视频、多模态 Agent memory 和在线传感器模型。
- 统一缓存协议,多物理后端:模型只依赖 append/evict/attention/reset 语义,高性能后端用 paged cache,兼容后端用原生 tensor。
- 事务式关键帧提交:defer eviction → 临时 append → 计算质量或运动指标 → commit/rollback,适用于必须先看模型输出才能决定是否记忆的系统。
- 输出与状态解耦:每帧都给用户结果,只有关键帧进入后续上下文;可迁移到全帧深度、跟踪、检测和在线 Agent。
- 窗口边界传播完整 Sim(3):pose、depth 和 point map 共享尺度、旋转与平移,并保留 chunk 对齐元数据,适用于 NeRF/3DGS 分块和单目 3D chunk。
- 逐帧 CPU 输出卸载:GPU 每次只处理初始化帧、单帧或一个窗口,预测立即卸载后再拼接,避免海量输出长期占用显存。
- 只编译固定形状热点:仅对 frame blocks、DINO blocks 和部分 attention/FFN 使用
torch.compile,避开动态 cache 和多尺度 head 引发的重编译。 - 可恢复的 benchmark 中间格式:prepare、run、evaluate、report 以稳定磁盘格式解耦,用 scene 级完成标记支持续跑,适合多数据集、多环境和多模型比较。
关键设计决策
1. 三种时间尺度,而非全历史稠密注意力
- 问题:长视频同时需要初始尺度、近期精细几何和远期轨迹,但全部保留会让状态膨胀。
- 方案:scale frames 常驻,recent window 保留稠密 patch,长期历史只保留 camera/register/scale 等特殊 token。
- Trade-off:稠密状态接近有界,但 special stream 仍随帧数线性增长,所以「近似恒定成本」不能理解为所有内存严格
O(1);压缩 token 也不足以天然完成精确回环。
2. FlashInfer 高速路径 + SDPA 兼容路径
- 问题:普通 tensor 拼接会反复分配与复制,而强制 CUDA 优化库又会牺牲可移植性。
- 方案:统一流式缓存语义,下层可切换 FlashInfer paged cache 或 PyTorch SDPA。
- Trade-off:前者性能潜力高但依赖 CUDA/JIT、精度和特定版本;后者便携但长序列复制成本更高。双后端一致性本身也成为长期维护负担。
3. 不同 token 使用不同生命周期
- 问题:稠密视觉 patch 很贵,相机与尺度摘要便宜;统一保留或统一驱逐都浪费信息预算。
- 方案:patch page 可回收,scale page 不驱逐,special page 追加保存。
- Trade-off:实现了分级压缩,却没有免费无限历史;长期 special attention 仍会增长。
4. 初始尺度阶段 + 重叠窗口 Sim(3) 拼接
- 问题:单目重建有尺度歧义,窗口重置又会产生多个局部坐标系。
- 方案:先联合处理若干 scale frames,再逐帧因果推理;窗口边界以共同关键帧估计完整 Sim(3)。
- Trade-off:不需要全局 BA,适合长视频;代价是误差会随窗口链传播,动态物体和深度伪影也会影响尺度估计。
5. 复用 DINOv2/VGGT 表征,而非从零训练
- 问题:流式 3D 模型训练昂贵,架构研究不应同时承担从零学习通用视觉先验的成本。
- 方案:默认以 DINOv2 ViT-L/14 初始化 patch embedding 与 frame/global blocks,并提供与 VGGT 阶段一权重衔接的 checkpoint。
- Trade-off:显著降低训练门槛,但模型受到固定维度和 head-dim 假设约束;宽松 checkpoint 加载也可能掩盖不匹配。
6. 推理、展示、评估分成三套资源模型
- 问题:交互查看器不适合万帧点云,评估又需要标准化、可恢复的中间结果。
- 方案:
demo.py负责交互,demo_render/负责离线视频,benchmark/分离准备、运行、评估和报告。 - Trade-off:能力更完整,但依赖扩大到 PyTorch、FlashInfer、Open3D、Kaolin、自定义 CUDA 扩展和 ffmpeg,安装治理明显更难。
竞品格局与定位
竞品对比矩阵
| 维度 | LingBot-Map | VGGT | CUT3R | DUSt3R / MonST3R | 传统 SLAM / 3DGS-SLAM |
|---|---|---|---|---|---|
| 首要目标 | 长视频流式 3D 基础模型 | 静态多视图通用几何 | 在线重建与回环 | 成对重建 / 动态场景 | 持续定位、建图与工程部署 |
| 历史状态 | 锚点 + 稠密窗口 + 特殊 token | 有限输入的双向全局上下文 | 在线场景状态 | 成对关系 + 后续对齐 | 关键帧、地图、位姿图 |
| 长序列资源控制 | paged cache、关键帧、分窗 | 非核心目标 | 支持在线处理 | 非核心目标 | 工程上成熟 |
| 回环 / 全局一致性 | 未内置,当前主要短板 | 不面向完整 SLAM | 更强调在线回环 | 依赖全局对齐方法 | 成熟后端与 pose graph |
| 动态场景 | 非主要优化目标 | 有限 | 依实现而定 | MonST3R 更有针对性 | 依动态过滤与前端设计 |
| 输出 | pose、depth、confidence、points | camera、depth、points、tracks 等 | 在线几何与相机 | pairwise point maps / 动态几何 | 轨迹、稀疏/稠密地图 |
| 最适合 | 连续长视频、前馈几何先验 | 有限帧静态重建 | 重访区域与在线一致性 | 图像集合或强动态场景 | 安全可靠定位、传感器融合、长期地图 |
差异化护城河
LingBot-Map 的护城河不是「用了 Transformer」,而是以下组合:
- 算法与系统协同:几何上下文训练方式和两流 paged cache、关键帧事务、窗口 Sim(3) 拼接共同设计;
- 从模型到输出链完整:模型、benchmark、交互查看器、万帧离线渲染同时开放;
- 上游先验与下游场景衔接:复用 DINOv2/VGGT 表征,同时面向机器人与世界模型的连续视频输入;
- 许可证宽松:Apache-2.0 降低研究和商业改造门槛。
短期内,竞品可以复制某个缓存技巧,却不容易在没有相同训练方案和 checkpoint 的情况下复现完整效果。
竞争风险
最危险的不是 VGGT,而是同时具备长序列吞吐与可靠回环的流式模型。CUT3R 类项目若在 paged cache、关键帧和窗口效率上追平,就会直接放大 LingBot-Map 没有 loop closure 的短板。
传统 SLAM 则从另一侧形成长期压力:只要用户真正关心的是机器人持续定位、全局地图一致性、IMU/LiDAR 融合或故障恢复,成熟 SLAM 仍是更稳妥的选择。LingBot-Map 更可能成为它们的学习式前端,而不是直接替换整套后端。
生态定位
最准确的定位是:静态 3D 基础模型与完整 SLAM 之间的流式几何前端。
它填补了「统一 feed-forward 模型如何处理连续长视频」这一空白。理想组合不是让 GCT 独自承担所有地图一致性,而是让它提供深度、姿态和高语义几何状态,再接外部回环检测与图优化后端。
套利机会分析
- 信息差:12.8K stars 意味着项目已经不冷门,传统的早期发现套利窗口基本结束;真正的认知差是,多数讨论只记住「万帧 20 FPS」,却没有解释三层缓存如何工作、为何 special stream 仍会增长,以及它为什么不等于 SLAM。
- 技术借鉴:锚点—窗口—摘要三级记忆、统一缓存协议、多后端实现、事务式关键帧提交、输出与状态解耦,都能迁移到长视频、多模态 Agent 和在线感知系统。
- 生态位:项目填补了静态 3D foundation model 与传统实时 SLAM 之间的流式模型层,可作为世界模型、机器人感知或外部 SLAM 后端的几何前端。
- 趋势判断:3D 基础模型正在从有限图像集合走向视频与具身智能,方向正确;但后发优势能否维持,取决于团队能否解决回环、动态场景和工程稳定性,而不只是继续增加可处理帧数。
风险与不足
- 没有回环与全局位姿图:#60 的循环轨迹漂移和 #78 对 global pose graph 的追问,直接暴露了当前最大结构性短板。
- 「近似恒定」不是严格
O(1):稠密 patch 窗口被限制,但全历史 special token 仍线性增长;长序列下注意力和预分配上限仍需管理。 - 训练长度与部署长度存在外推风险:README 提醒模型训练范围约 320 views,超出后可能 pose collapse。关键帧和分窗是在工程上控制风险,不是消除分布外误差。
- 局部窗口拼接会累积误差:Sim(3) 对齐依赖重叠帧 pose/depth;动态物体、弱纹理和 #27 点云分层伪影 都可能污染估计。
- 测试与 CI 明显不足:未发现正式测试套件或 CI。cache rollback、窗口拼接、坐标变换和 FlashInfer/SDPA 一致性恰好又是最需要回归测试的部分。
- GPU 依赖组合复杂:FlashInfer、PyTorch、Open3D、Kaolin、自定义 CUDA 扩展和 ffmpeg 扩大了环境矩阵;高速路径对 CUDA、精度和版本敏感。
- 依赖文档存在漂移:仓库没有 lock file;README 使用的
renderextra 与当前pyproject.toml定义不完全一致,关键 GPU 依赖仍需手工配对。 - 治理仍是研究型早期:项目约 3 个月、无 git tag、未探测到正式 Release,也没有 CONTRIBUTING、维护政策或完整 changelog;贡献高度集中于核心作者。
- 官方性能与 benchmark 尚需独立复现:项目方声明可处理 10,000+ 帧并达到约 20 FPS,但本次分析没有下载权重或运行 GPU benchmark;硬件、分辨率、后端和关键帧参数都会影响结果。
行动建议
-
如果你要用它:
- 先判断任务是否允许无全局回环。连续前进的视频转 3D、离线数据加工和世界模型几何评估适合尝试;闭环机器人定位、长期地图和安全关键场景不适合直接替代成熟 SLAM。
- 固定 commit hash 与 CUDA/PyTorch/FlashInfer 版本,不要依赖尚不存在的语义化 tag。
- 先在短序列验证坐标、尺度和显存,再逐步开启关键帧与窗口模式;对超过训练长度的轨迹重点检查 pose collapse、尺度漂移和点云分层。
- 生产方案优先考虑「LingBot-Map 前端 + 回环检测/pose graph 后端」,而不是把全局一致性完全交给 token memory。
-
如果你要学它:建议按以下顺序阅读:
lingbot_map/models/gct_stream.py— 流式生命周期、尺度阶段、逐帧输出与关键帧控制;lingbot_map/layers/flashinfer_cache.py— scale/window/special 三类页与 append/evict/rollback 状态机;lingbot_map/aggregator/stream.py— frame/global blocks、特殊 token 与 FlashInfer/SDPA 后端选择;lingbot_map/layers/attention.py— 两种注意力后端的缓存语义;lingbot_map/models/gct_stream_window.py— 重叠窗口和 Sim(3) 拼接;lingbot_map/models/gct_stream_window_v2.py— 几何光流驱动的实验性关键帧事务;benchmark/— 可恢复评估管线与指标组织;demo_render/rgbd_render/pipeline/parallel.py— GPU 裁剪、共享内存和并行渲染。
-
如果你要 fork 它:优先级最高的改进不是再加一个 Demo,而是:
- 为 cache append/evict/rollback、窗口 Sim(3)、pose/depth/points 同步变换和双后端一致性添加自动化测试;
- 建立 CUDA/PyTorch/FlashInfer 版本矩阵 CI,补齐 lock file 与
renderextra; - 抽取三个流式模型变体的重复代码,建立明确的 cache protocol;
- 把 loop closure 与 global pose graph 做成可插拔后端;
- 增加动态场景掩码、漂移检测和失败恢复;
- 发布固定 tag、迁移指南与可复现 benchmark 配置。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 页面入口(采集时未见完整可读内容) |
| Zread.ai | 未收录 |
| 关联论文 | Geometric Context Transformer for Streaming 3D Reconstruction |
| 在线 Demo | 官方项目页 |
| 模型权重 | Hugging Face / ModelScope |
| Demo 数据 | Hugging Face Dataset |