MinerU 深度分析报告
一句话总结
将复杂文档(PDF/图片/DOCX)高精度转换为 LLM 可用的结构化 Markdown/JSON,是文档解析领域 Star 数全球第一的开源方案,背靠上海人工智能实验室。
值得关注的理由
- 文档解析类全球 Star 数第一(58.2K),是第二名 Marker 的近 3 倍,且仅用 25 个月达成
- VLM + OCR 双引擎架构首创性地解决了「精度 vs 幻觉」的两难——pipeline 无幻觉稳定输出,VLM 引擎深度语义理解,hybrid 融合二者优势
- RAG 生态深度集成(LangChain/Dify/RAGFlow/MCP Server),加上 10+ 国产 AI 芯片适配,在中国 AI 基础设施中占据不可替代的生态位
项目展示
MinerU 项目 Logo
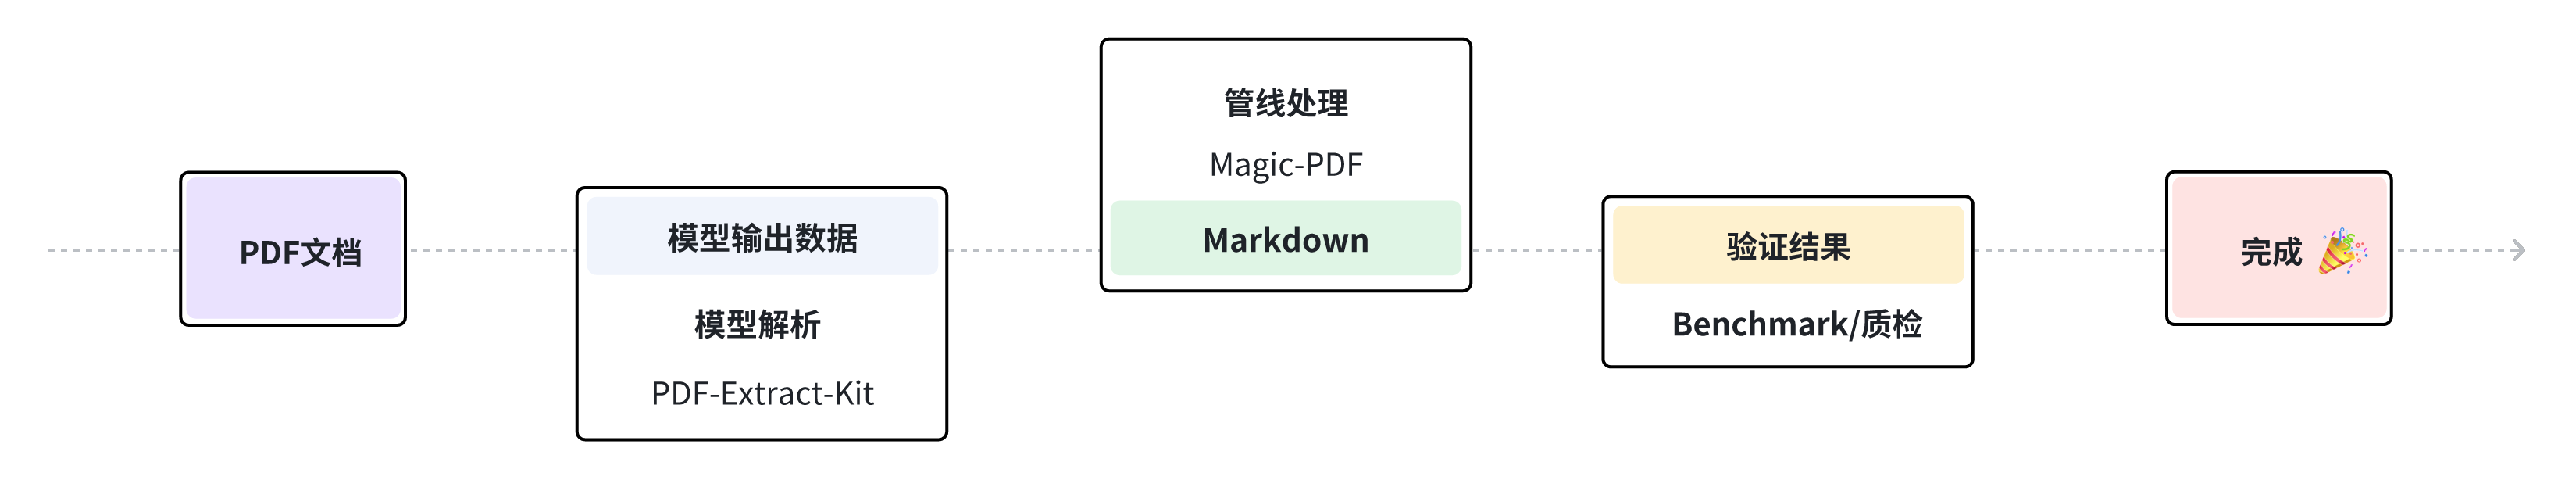
MinerU 文档解析处理流程图
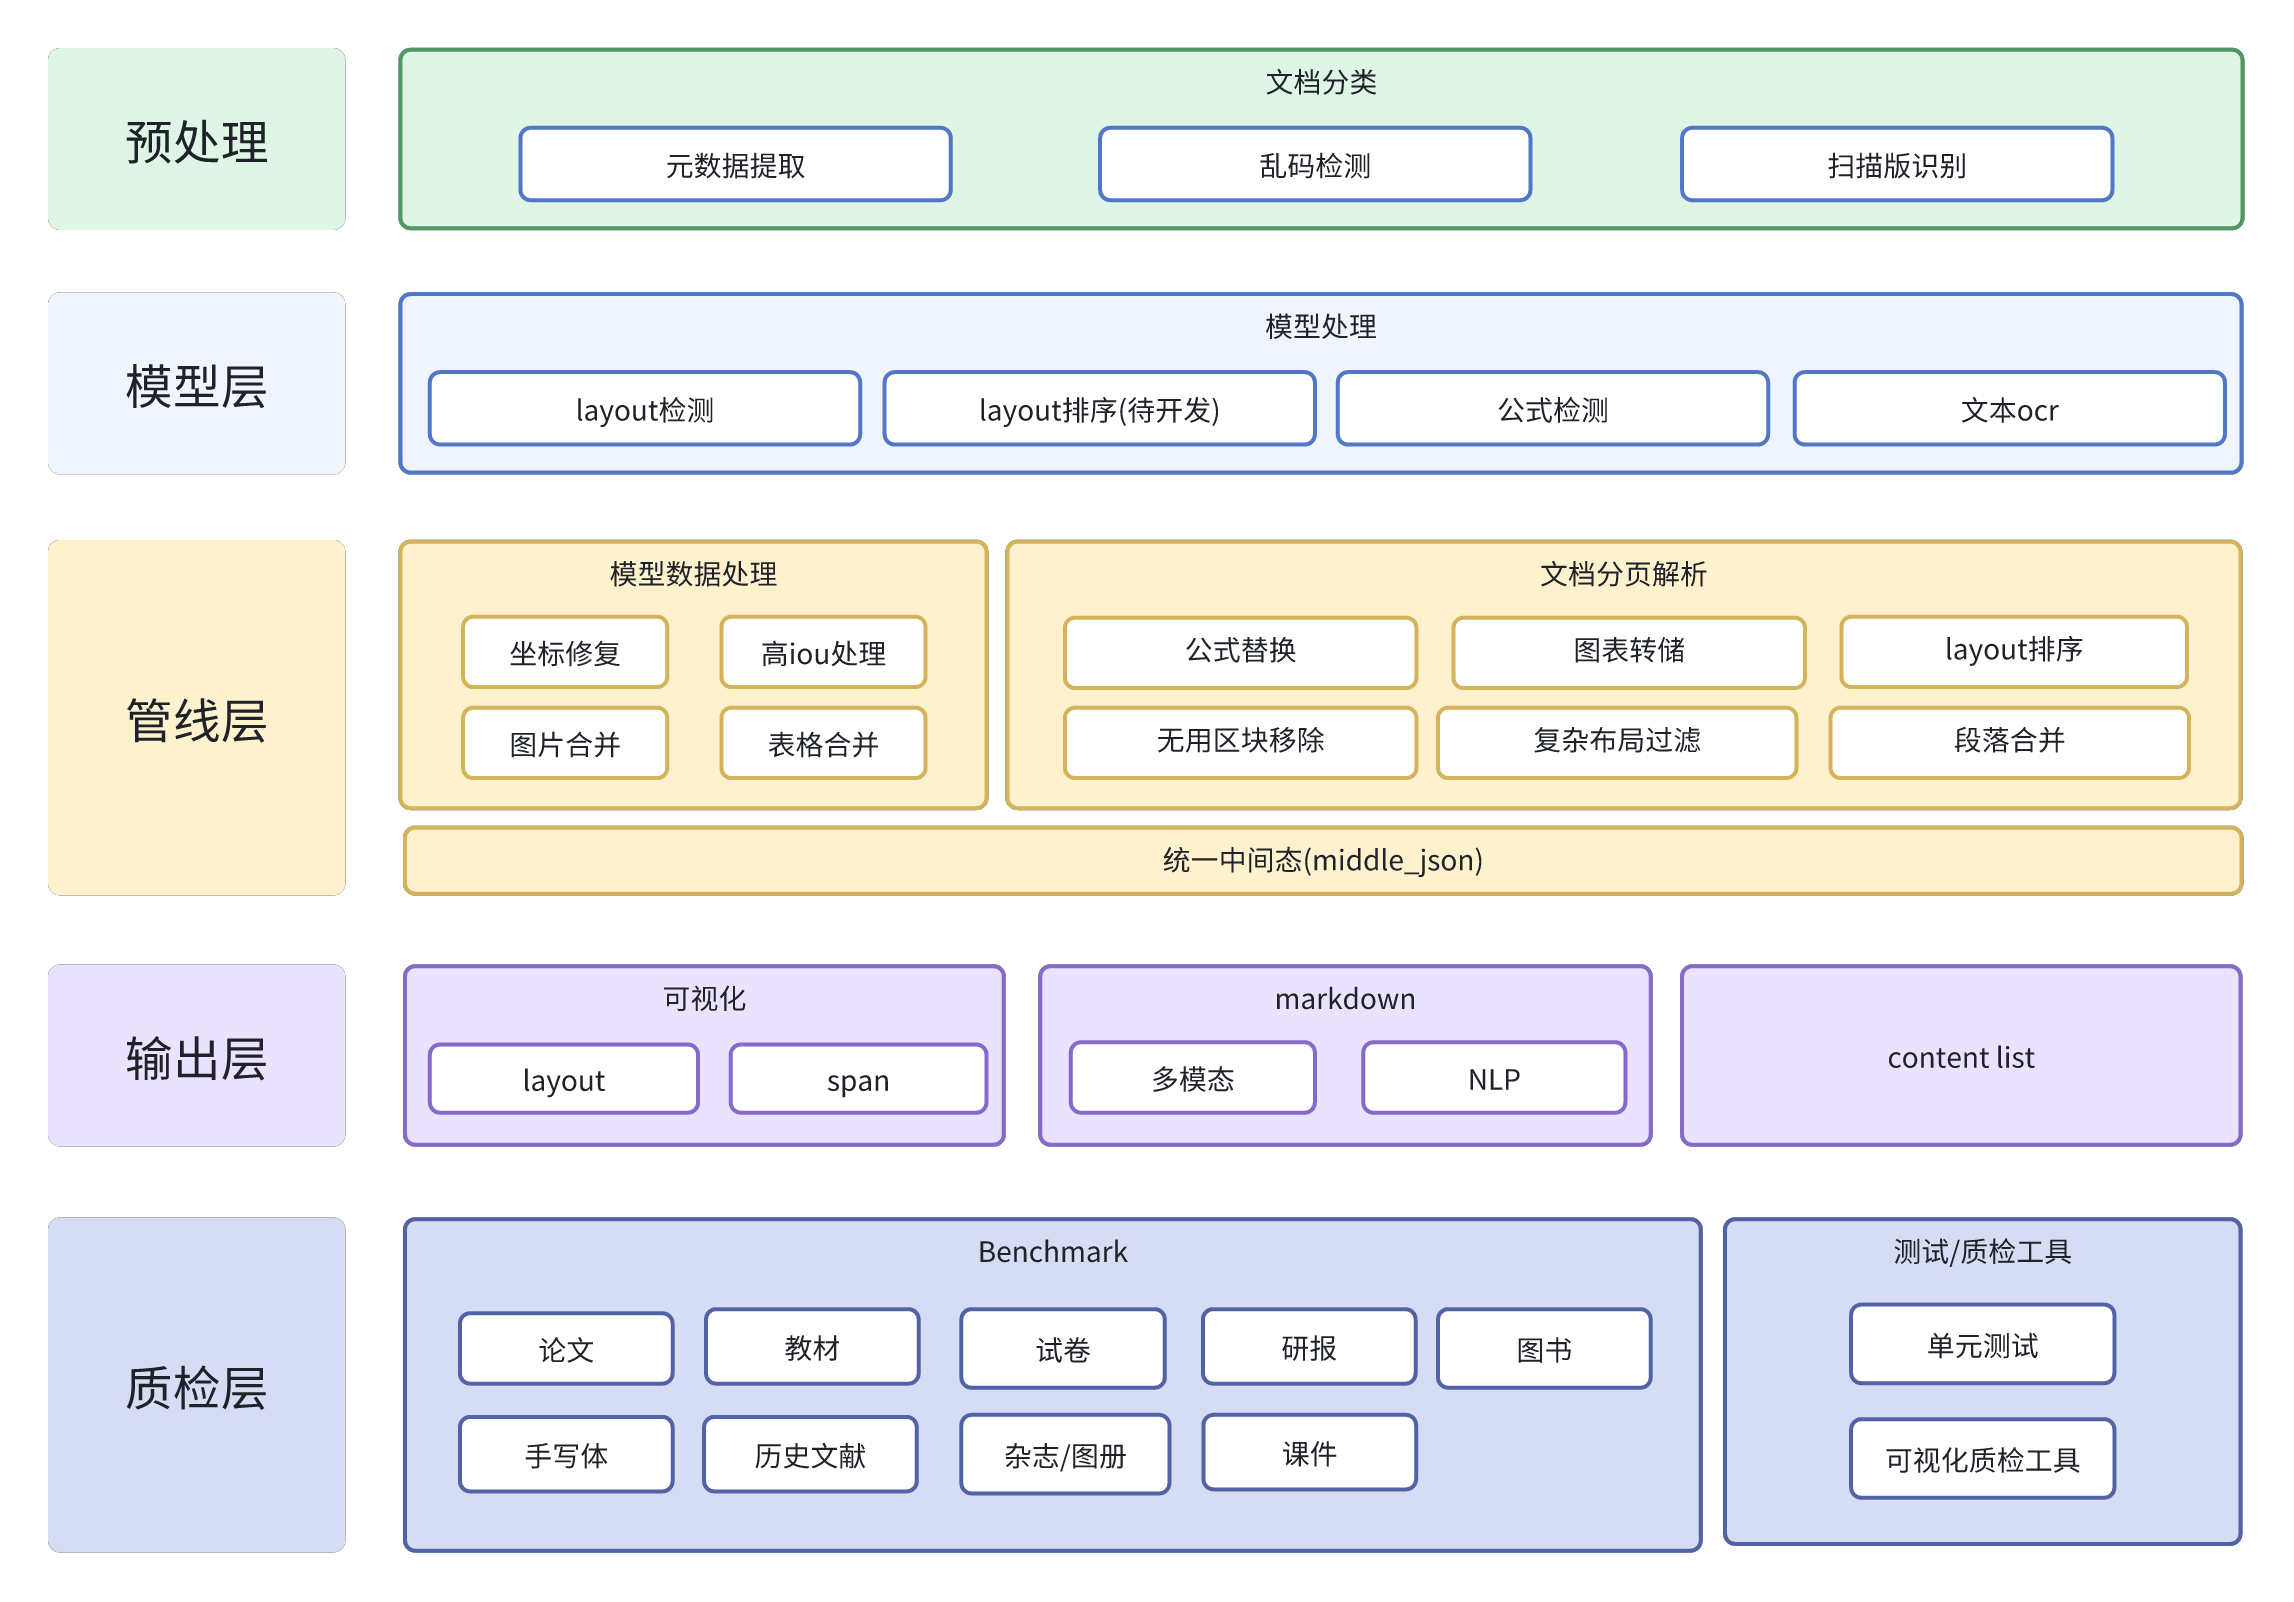
MinerU 项目全景——从输入格式到输出格式的完整覆盖
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/opendatalab/MinerU |
| Star / Fork | 58,208 / 4,802 |
| 代码行数 | 44,694 行 Python (93.9%),总计 122,772 行(含文档) |
| 项目年龄 | 25 个月(首次提交 2024-02-29) |
| 开发阶段 | 密集开发(3.0 刚发布,月均 189 次提交,日均 10 次) |
| 贡献模式 | 机构团队驱动(100 位贡献者,核心 3 人,myhloli 占 60%) |
| 热度定位 | 大众热门(58K Star,文档解析类全球 #1) |
| 质量评级 | 代码[良好] 文档[优秀] 测试[不足] |
作者视角:为什么存在这个项目
创始人/作者背景
OpenDataLab 隶属上海人工智能实验室(Shanghai AI Lab),中国国家级 AI 研究机构。核心维护者 myhloli(赵小蒙),Shanghai AI Lab 员工,贡献约 73% 代码。团队拥有大规模预训练数据工程、CV 模型工程化、国产 AI 芯片生态三重独特背景。这些背景直接塑造了 MinerU 的设计选择:全栈自研模型(PP-DocLayoutV2、UnimerNet)、10+ 国产芯片适配、以及经过千万级 PDF 磨练的长尾 case 处理能力。
问题判断
项目直接诞生于 InternLM 大模型预训练过程中——团队在构建千万级 PDF 预训练语料时反复撞到的工程痛点:科学文献中的数学公式、表格、多栏版面无法被现有工具可靠转为纯文本。时机上,正值 2024 年 RAG 生态爆发期,LLM 能力越强,对高质量文档解析的需求就越迫切。
解法哲学
「精度优先,多路灵活」:
- 双引擎而非单一路径——pipeline(无幻觉)+ VLM(高精度)+ hybrid(融合),体现「没有银弹」的工程务实
- 精度 > 速度 > 易用性——OmniDocBench 86.2 分(pipeline)/ 90+ 分(VLM),但也确保纯 CPU 环境可用
- 3.0 版主动移除三个非商业友好的模型依赖,在 AGPL-3.0 框架内尽量降低商用门槛
战略意图
MinerU 是 OpenDataLab 数据基础设施版图的关键拼图:InternLM 大模型 → OpenDataLab 数据平台 → MinerU 数据生产工具,形成「非结构化数据 → 结构化数据」的入口。通过 MCP Server、REST API、RAG 框架集成,目标是成为 AI Agent 生态中文档理解层的事实标准。mineru.net 提供商业化的 Web 版和桌面客户端。
核心价值提炼
创新之处
-
双引擎融合的 Hybrid 模式(新颖度 4/5 × 实用性 5/5)
- pipeline 负责精确 OCR 识别(无幻觉),VLM 负责复杂版面语义理解,通过
BlockType类型系统统一输出。竞品(Marker/Docling/olmOCR)均为单路径方案
- pipeline 负责精确 OCR 识别(无幻觉),VLM 负责复杂版面语义理解,通过
-
PP-DocLayoutV2 文档感知检测模型(新颖度 4/5 × 实用性 5/5)
- 基于 RT-DETR + LayoutLMv3 的混合架构,25 种细粒度布局类别(含 abstract、seal、vertical_text 等文档特有类型),每类独立置信度阈值
-
跨页表格智能合并(新颖度 3/5 × 实用性 5/5)
- 600+ 行专用逻辑,支持中英文 8+ 种续表标记检测,结合列数一致性和 rowspan/colspan 结构分析自动合并
-
PyTorch 重写的 PaddleOCR(新颖度 3/5 × 实用性 5/5)
- 消除双框架依赖,整个项目统一到 PyTorch 生态,支持 109 种语言
-
国产 AI 芯片自动检测链(新颖度 3/5 × 可迁移性 4/5)
- CUDA → MPS → NPU(昇腾) → GCU(燧原) → MUSA(摩尔线程) → MLU(寒武纪) → SDAA(平头哥) 逐级降级检测
可复用的模式与技巧
- 统一中间表示(middle_json):多引擎系统通过共享中间格式解耦输入处理和输出生成——适用于任何多模型/多算法融合的推理系统
- 滑动窗口批处理:大文件分窗口处理 + 流式写盘 + 完成即释放,将内存峰值从 O(总页数) 降到 O(窗口大小)——适用于任何内存受限的大规模数据管线
- 渐进式本地-远程架构:CLI 自动在本地临时服务和远程 API 间切换,实现单机到集群的平滑演进——适用于需要从工具演进到服务的产品
- 参数化模型单例池:以参数元组为 key 的线程安全模型缓存——适用于同模型不同配置并存的推理服务
- 多信号文档预分类:结合字符统计、CID 比例、图像覆盖率的 PDF 自动分类——适用于需要按文档类型选择不同处理路径的系统
关键设计决策
- 三后端统一中间表示:pipeline/vlm/hybrid 引擎输出格式各异,通过 middle_json 统一下游处理。增加一层抽象开销,换来新增引擎只需实现映射的可扩展性
- 客户端-服务端解耦的 CLI(3.0):
mineru命令作为编排客户端,底层调用mineru-api服务,未指定--api-url时自动启动本地临时服务。架构更复杂,但实现了单机和集群部署的统一入口 - 自动 PDF 分类决定 OCR 策略:采样前 10 页,通过字符数阈值、CID 比例、图像覆盖率多信号综合判断。可能误判,但大幅降低使用门槛
竞品格局与定位
竞品对比矩阵
| 维度 | MinerU | Marker | Docling | olmOCR |
|---|---|---|---|---|
| Stars | 58.2K | ~21K | ~18K | ~8K |
| 精度(OmniDocBench) | 86.2 / 90+ | 未公开 | 未公开 | 未公开 |
| 速度(L4 GPU) | 0.21s/页 | 0.86s/页 | 0.49s/页 | - |
| CJK 支持 | 优秀(竖排/繁简) | 一般 | 一般 | 较弱 |
| 引擎架构 | 双引擎(pipeline+VLM+hybrid) | 单引擎(LLM增强) | 单引擎 | 单引擎(VLM) |
| 许可证 | AGPL-3.0 | GPL-3.0 | MIT | Apache 2.0 |
| 国产芯片 | 10+ 种 | 无 | 无 | 无 |
| 纯 CPU 运行 | 支持 | 支持 | 支持 | 不支持 |
差异化护城河
- 双引擎灵活组合——「无幻觉 pipeline + 高精度 VLM」的互补架构,竞品均为单路径
- 国产 AI 芯片深度适配——10+ 种芯片支持使其成为中国信创环境的唯一选择
- 全栈自研模型——PP-DocLayoutV2、UnimerNet、MinerU2.5-VLM 等核心模型自研,不依赖第三方
竞争风险
- AGPL-3.0 许可证可能阻碍部分商业用户转向 MIT 许可的 Docling
- VLM 技术快速演进可能侵蚀 pipeline 后端的精度优势
- Docling 依托 IBM 生态的企业级整合能力不容忽视
生态定位
MinerU 正在从「文档解析工具」向「文档解析基础设施」演进,通过 MCP Server、REST API、Router 负载均衡等能力,目标是成为 AI Agent 生态中文档理解层的事实标准。在中国市场因国产芯片适配而几乎没有对手。
套利机会分析
- 信息差: 项目 Star 数已很高(58K),不存在被低估的信息差。但其国产芯片适配能力和双引擎融合架构的技术深度在国际社区认知不足
- 技术借鉴: 统一中间表示(middle_json)模式、滑动窗口流式处理、渐进式本地-远程 CLI 架构,均可直接迁移到其他多引擎处理系统
- 生态位: 在「LLM/RAG 工作流的文档预处理」赛道占据核心入口位置,RAG 框架集成最为完整
- 趋势判断: 处于强劲增长期。3.0 架构升级(线程安全、多 GPU 编排、滑动窗口)标志着从工具到基础设施的跃迁。随着 Agent 生态成熟,文档理解需求将持续上升
风险与不足
- AGPL-3.0 许可证:copyleft 传染性对商业使用有明确限制,可能迫使部分企业用户转向 Docling(MIT) 或 olmOCR(Apache 2.0)
- 核心开发者集中:myhloli 贡献 60-73% 代码,虽有组织支撑但技术决策高度依赖单人
- 测试覆盖严重不足:仅 1 个 E2E 测试文件,无单元测试,对于 4.5 万行 Python 项目风险较高
- 部分代码过于庞大:fast_api.py(53K 行)、gradio_app.py(51K 行)、router.py(54K 行) 严重超标
- 3.0 升级兼容性冲击:路径变更导致 RAGFlow 等下游集成报错,生态适配需要时间
- 缺少 linter 配置和依赖锁文件:PR 模板提及 pre-commit 但仓库中未见配置
- 国际社区渗透有限:Issue/Discussion 以中文为主,国际用户参与度相对不足
行动建议
- 如果你要用它: 如果处理中文/CJK 文档或需要国产芯片部署,MinerU 是目前唯一的选择。英文学术论文场景可对比 Marker(更轻量)和 Docling(MIT 许可更宽松)。注意 AGPL-3.0 许可证对商业场景的影响,如需商用考虑 mineru.net 的商业版本
- 如果你要学它: 重点关注
mineru/backend/三大引擎的实现差异、mineru/model/layout/的 PP-DocLayoutV2 模型设计、以及mineru/backend/utils.py中跨页表格合并的精巧逻辑 - 如果你要 fork 它: 可改进方向包括——补充单元测试覆盖、拆分超大文件(fast_api.py/router.py)、增加 linter/formatter 配置、扩展 XLSX/PPTX 原生解析支持