不切离散 token 的 TTS:27.5K star 的 VoxCPM 把克隆相似度做到反超 ElevenLabs
一句话总结
VoxCPM 是 OpenBMB(MiniCPM 团队)出品的「Tokenizer-Free」语音合成模型:它不像主流 TTS 那样先把音频量化成离散 token,而是让 LLM 在连续的 VAE 潜空间里做扩散自回归,把声学细节交给流匹配解码器补全。这条「连续表征」路线让它在 Seed-TTS-eval 同体量近 SOTA,多语言声音克隆相似度(SIM)在多数语言上反超闭源的 ElevenLabs/MiniMax——9 个月 27.5K star,Apache-2.0 权重+代码全开可商用。
值得关注的理由
- 一条与主流分道扬镳的技术路线:CosyVoice、fish-speech 等都走「音频量化成离散 token → LM 预测 → vocoder 还原」,量化必然丢信息、限韵律。VoxCPM 判断「LM 与音频之间的离散 token 接口才是瓶颈」,于是全程连续——这个「连续 vs 离散」的路线分化本身就是值得讲的技术故事,且它用 benchmark 证明了路线有效。
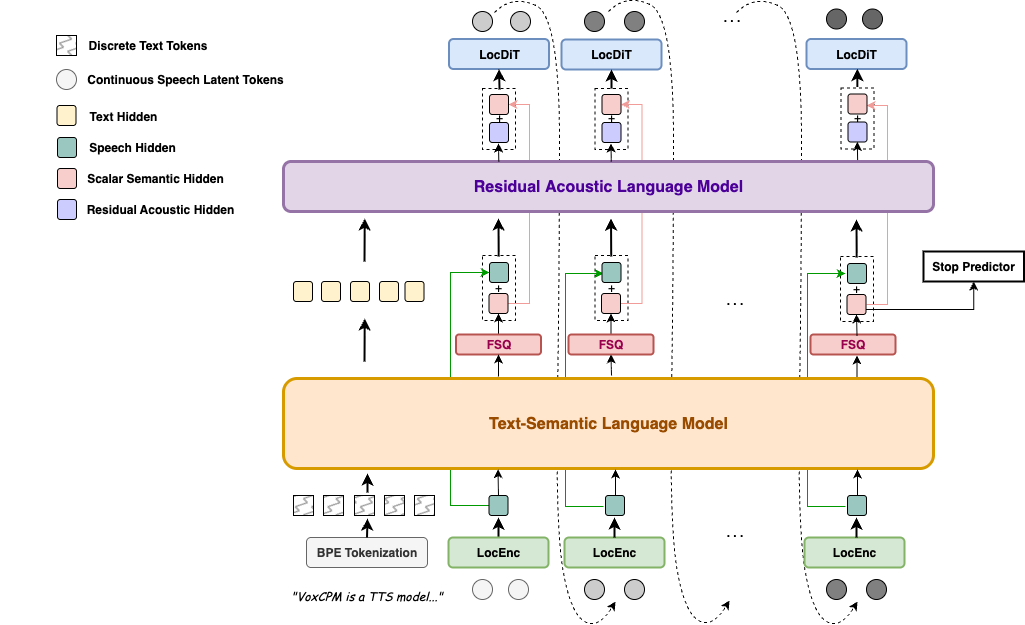
- 一个可直接迁移的解耦巧思(FSQ-as-bottleneck):它把 FSQ(标量量化,本是给图像 codec 的)用在LM 的隐状态而非音频上——音频位隐状态过一个
tanh→round→直通估计的低比特瓶颈、文本位不量化,逼语义/内容走主干、把音色等声学残差挤到另一路,实现「内容-音色」隐式解耦。这是把一个领域的技巧创造性地搬到另一处的范本。 - LLM-as-universal-backbone 的干净示范:四级流水线(LocEnc→TSLM→RALM→LocDiT)里有四处直接复用同一个 MiniCPM-4 Transformer 类,仅靠配置(
vocab_size=0/no_rope/层数/因果性)区分——KV cache、增量解码、torch.compile优化一处受益处处受益,是「用一套 LLM 实现贯穿多模块系统」的工程教科书。
项目展示
VoxCPM2 模型架构(四级流水线 LocEnc → TSLM → RALM → LocDiT,全程在 AudioVAE V2 连续潜空间):
- 在线试听(多语言 / 克隆 / 音色设计样本):https://openbmb.github.io/voxcpm2-demopage/
- 在线 Playground(HF Space):https://huggingface.co/spaces/OpenBMB/VoxCPM-Demo
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/OpenBMB/VoxCPM |
| Star / Fork | 27,470 / 3,107 |
| 代码行数 | 9,935 行(Python 97.6%,54 文件)——代码精简,项目「重量」在模型权重(托管 HF)与方法论 |
| 项目年龄 | 8.7 个月(2025-09-16 起,当前 VoxCPM2 / v2.0.3) |
| 开发阶段 | 密集开发转稳定期(近 30 天 5 commit、近 90 天 64,v2 发布后节奏回落) |
| 贡献模式 | 核心少数 + 社区(26 人,中文团队主导,Top 贡献者仅占 30%) |
| 热度定位 | 大众热门(9 个月 27.5K star,3.1K fork) |
| 质量评级 | 模型代码「优」 文档「优」 推理部署「优」 微调「良」 |
作者视角:为什么存在这个项目
创始人/作者背景
owner 是组织 OpenBMB(Open Lab for Big Model Base,6593 followers,2021 年成立),清华 NLP / 面壁智能 ModelBest 系,国内顶级开源大模型团队,代表作 MiniCPM 系列。VoxCPM 是 CPM 家族的语音分支,直接构建在 MiniCPM-4(2B,GQA + LongRoPE + muP)骨干之上——「CPM」即同源命名。核心贡献者是中文团队(刘鑫、周逸轩、曾国洋等 ModelBest 成员),海外社区补 Mac MPS、LoRA 等支持。团队既出 arXiv 技术报告(arXiv:2509.24650)、又做 pip 包 + CLI + vLLM 生产部署,学术 + 工程双强,可信度极高。
问题判断
ModelBest 是做高效小语言模型出身的团队,VoxCPM 是把「LLM 范式」迁到语音的自然延伸。他们看到的痛点不是「LM 不够强」,而是「LM 与音频之间的接口(离散 codec token)是信息瓶颈」。整个架构的设计目标就是消除这个接口:让音频在 AudioVAE 连续潜空间里全程流动,LM 只负责语义/节奏的自回归骨架,声学细节交给扩散解码器。
解法哲学
核心是「分工解耦 + 两头都要」,在代码里有三处明确落点:
- 连续 vs 离散的取舍兼得:音频始终连续(AudioVAE 输出 mu/logvar 潜变量,不是 VQ 码本),保证表现力;但在 LM 内部对音频位隐状态强行过一个 FSQ 标量量化瓶颈,用「类离散」的瓶颈逼出稳定的语义流,把声学细节挤给残差路径——拿离散的稳定性,又不牺牲连续的保真。
- 以 LLM 反哺语音:四级流水线里三级直接复用 MiniCPM-4,把 LLM 的高效结构原样搬过来当语音骨干。
- 生成交给流匹配:声学还原用 Conditional Flow Matching 的局部扩散 Transformer(LocDiT),而非回归 mel + vocoder。
团队在致谢里坦诚:LocDiT 的流匹配实现借自 CosyVoice、扩散自回归骨架借自 DiTAR、AudioVAE 骨架借自 DAC——擅长「站在已有组件上做系统级整合」,而非样样从零。
战略意图
VoxCPM 是 CPM 多模态家族的语音分支,用统一的 MiniCPM 骨干贯穿文本/语音,契合面壁「端侧 + 多模态」布局。Apache-2.0(权重与代码全开)是明确的商用友好信号,配合 vLLM-Omni(官方 OpenAI 兼容 /v1/audio/speech 端点)、Nano-vLLM、VoxCPM.cpp、ONNX、ANE 等繁荣的第三方生态,意图是抢占「开源可商用多语言 TTS 基础设施」的位置,对标闭源的 ElevenLabs/MiniMax 和开源的 fish-speech/CosyVoice。
核心价值提炼
创新之处
诚实区分:VoxCPM 的连续扩散 AR 骨架致谢 DiTAR、流匹配致谢 CosyVoice,属于「把已有方向做扎实并规模化(2M 小时 / 2B / 30 语种)」,真正原创的巧思集中在第 2 项。
- Tokenizer-Free 连续扩散自回归 TTS(新颖度 4/5,实用性 5/5):音频不离散化,LM 在连续 VAE 潜空间自回归 + 流匹配解码。放弃了离散 token 的「可枚举/易缓存/易上 KV」便利,换来表现力上限——代价是连续 AR 对数值稳定性更敏感(MPS 必须 fp32),靠 CFG + badcase 重试兜底。
- FSQ 隐状态瓶颈做语义-声学解耦(新颖度 4/5,可迁移性 5/5):把标量量化用在 AR 隐状态而非音频上(
scalar_quantization_layer.py:in_proj→tanh→round(·*9)/9→out_proj,文本位不量化),逼 TSLM 走内容/节奏、把音色残差挤到 RALM 路径,训练用直通估计保证可导。这是本仓库最巧的设计,可直接搬到任何需要多流解耦的生成模型。 - MiniCPM-4 单骨干贯穿四级流水线(新颖度 3/5,可迁移性 5/5):同一
MiniCPMModel类配置化复用为主 LM(TSLM)、残差 LM(RALM)、局部编码器(LocEnc)、DiT 主干,仅靠model_copy改配置区分。集成性创新,工程统一度极高。 - AudioVAE 非对称编解码 + 采样率条件(新颖度 4/5,实用性 5/5):编码 16kHz 入、解码 48kHz 出(倍率不对称,VAE 解码器本身就是超分器),每块插
SampleRateConditionLayer让一个解码器输出多档采样率,免外接 vocoder/upsampler;DAC 风格因果卷积天然支持流式(StreamingVAEDecoder)。 - Voice Design「格式即协议」(新颖度 3/5):自然语言描述造声靠
(描述)正文的固定语法,纯由训练数据约定生效,推理代码零解析分支(cli.py仅做字符串包裹)——用最低工程成本给生成模型加自然语言控制面。
可复用的模式与技巧
- FSQ-as-bottleneck(标量量化做信息瓶颈解耦):在两条信息流之间插
tanh→round→直通估计,逼一路走粗粒度语义、另一路走残差细节。 - LLM-as-universal-backbone:用
vocab_size=0/no_rope/is_causal开关把同一 LM 实现复用为编码器/解码器/DiT,集中维护推理优化。 - 隐状态作扩散条件的 in-context token:把上游 LM 隐状态拆成 token 拼进 DiT 序列做双向注意力,替代 AdaLN/相加式条件(V2 关键升级)。
- 非对称 VAE + 采样率分桶条件:编解码倍率解耦 + scale_bias 条件,一网多码率/内置超分。
- 格式即协议的控制面:把控制指令编码进输入文本的固定语法,靠训练数据约定生效、代码零分支。
- 有状态流式因果卷积解码 + badcase 自动重试 + 设备自适应 dtype:生产级生成模型鲁棒性的实用组合。
关键设计决策
最值得记录的是 FSQ 隐状态瓶颈实现的语义-声学解耦。问题是:若 TSLM 把完整声学信息透传给下游,语义/内容流会被音色细节污染,克隆与可控性变差。VoxCPM 的解法是在 TSLM 输出的音频位隐状态上插一个低比特标量瓶颈(约每维 19 档),「掐细节、留语义」,逼 TSLM 走内容/节奏,把音色等声学残差挤到 RALM + 原始帧 embedding 路径。Trade-off 是瓶颈太窄损失语义、太宽则解耦失效(scale=9 是经验平衡),且是隐式解耦、无显式监督、可解释性弱。但「把 FSQ 用在 AR 隐状态而非音频上做信息瓶颈」是一个可迁移到其他多流生成任务的真巧思(关键文件 src/voxcpm/modules/layers/scalar_quantization_layer.py、四级流水线编排 src/voxcpm/model/voxcpm2.py:974-1108)。
竞品格局与定位
竞品对比矩阵
| 维度 | VoxCPM2 | CosyVoice2(阿里) | F5-TTS | fish-speech/OpenAudio |
|---|---|---|---|---|
| Stars | 27.5K | 21.5K | 14.7K | 30.7K |
| 表征路线 | 连续(tokenizer-free) | 离散 FSQ 语音 token | 连续 flow-matching(非 AR) | 离散 VQGAN token |
| 架构 | LLM 骨干 + 扩散 AR | LM + 流匹配 | 纯非自回归 | 双 AR Llama |
| Seed-TTS EN WER | 1.84 | 3.09 | 2.00 | ~0.99(S2) |
| 许可 | Apache-2.0 | 部分开源 | 多非商用 | Apache-2.0 |
差异化护城河
① 纯连续 tokenizer-free 路线(与 CosyVoice/fish 的离散路线正面分化),Seed-TTS 同体量近 SOTA、多语言 SIM 大面积反超闭源 ElevenLabs/MiniMax;② 48kHz 内置超分免 vocoder;③ Voice Design + 可控克隆功能完整(30 语种 + 9 中文方言,无需语言标签);④ 统一 MiniCPM 骨干 + 完善推理生态(vLLM-Omni 官方支持、Nano-vLLM、cpp/ONNX/ANE/Rust);⑤ Apache-2.0 权重+代码全开可商用。
竞争风险
- 长尾多语言 WER 仍偏高(阿拉伯语 13.0、捷克语 24.1、罗马尼亚语 21.6、印地语 19.7,issue #213 波兰语词尾截断)——非中英语言离 ElevenLabs/Fish 还有差距;
- 连续 AR 数值稳定性敏感(MPS 必须 fp32、需 badcase 重试、可控生成 1~3 次才稳,README 自承);
- 赛道极度拥挤、迭代飞快,人气/社区仍落后 GPT-SoVITS(58K)、fish-speech(30.7K);
- 复现性弱于离散竞品:VoxCPM2 技术报告「coming soon」,预训练数据与完整训练脚本未开源,纯连续路线的复现门槛更高。
生态定位
押注「连续扩散自回归 + LLM 骨干」的开源可商用多语言 TTS 基座,靠功能广度 + 多语言克隆相似度 + 部署生态切入 ElevenLabs/MiniMax 的替代位,并与同源的 CosyVoice/fish-speech 做「连续 vs 离散」路线分化。
套利机会分析
- 信息差:团队背书(OpenBMB)+ 赛道热(开源 TTS)+ 技术差异化(tokenizer-free)三者叠加,是高确定性优质选题;中文圈对「连续 vs 离散 TTS 路线之争」「FSQ 用在隐状态解耦」这类技术细节的系统梳理稀缺,套利在内容深度。
- 技术借鉴:FSQ-as-bottleneck 解耦、LLM-as-universal-backbone、非对称 VAE 内置超分、格式即协议控制面——这四套设计可迁移到语音之外的多流/多模态生成、跨语言 SDK、轻量超分等领域。
- 生态位:填补「连续表征 + LLM 骨干 + Apache-2.0 可商用 + 48kHz + 30 语种」的组合位;与离散路线形成清晰分化。
- 趋势判断:踩在「开源 TTS 替代 ElevenLabs」与「以 LLM 为底座的多模态」两大趋势上;克隆相似度领先是它最锋利的差异化,长尾多语言可懂度是主要待补短板。
风险与不足
- 多语言长尾质量不均衡:中英 SOTA,但小语种可懂度(WER)明显落后,与社区反馈互证。
- 连续路线的工程代价:数值稳定性敏感、可控生成需多次重试、对部署 dtype 挑剔。
- 复现性与透明度:V2 技术报告未发、预训练数据/完整训练流程未开源,外部难以完整复现连续路线的训练。
- 近月开发放缓:v2 发布后近 30 天仅 5 commit,需观察后续迭代是否持续(团队重心已转向补微调链路)。
行动建议
- 如果你要用它:适合「需要可商用、多语言、零样本声音克隆 / 自然语言造声」的产品(有声书、配音、Agent 语音、数字人),尤其看重克隆相似度与本地/私有化部署(2B、
8GB 显存、RTF0.3,有 vLLM/cpp/ONNX 生态)。先用 HF Space 试听,极致克隆把同一段同时传prompt_wav和reference_wav。小语种生产慎用、需评测。 - 如果你要学它:直奔
src/voxcpm/model/voxcpm2.py:974-1108(四级流水线编排)、modules/layers/scalar_quantization_layer.py(FSQ 瓶颈解耦)、modules/locdit/unified_cfm.py+local_dit_v2.py(流匹配 + in-context 条件)、modules/audiovae/audio_vae_v2.py(非对称 VAE + 流式解码)。这四处是方法精华。 - 如果你要 fork / 微调它:团队已提供 SFT + LoRA 脚本(
scripts/train_voxcpm_finetune.py+conf/voxcpm_v2/+lora_ft_webui.py),微调到新语言/新音色是社区最活跃方向(issue #15/#114);但注意无预训练脚本,只能在开源权重上微调。
知识入口
| 资源 | 链接 |
|---|---|
| 关联论文 | VoxCPM 技术报告 arXiv:2509.24650(V1;V2 报告 coming soon) |
| 官方文档 | https://voxcpm.readthedocs.io/en/latest/ (architecture / quickstart / finetune) |
| DeepWiki | https://deepwiki.com/OpenBMB/VoxCPM(已收录,拆解四级流水线) |
| 在线 Demo | HF Space https://huggingface.co/spaces/OpenBMB/VoxCPM-Demo ;音频示例页 https://openbmb.github.io/voxcpm2-demopage/ |
| 模型权重 | HF openbmb/VoxCPM2 / ModelScope OpenBMB/VoxCPM2 |