68 万小时弱监督炼出的开源 ASR 标杆:openai/whisper 怎么用 30 秒滑窗和几行 token 统一语音任务
一句话总结
OpenAI 用 68 万小时多语种弱监督音频训练出的 Encoder-Decoder Transformer 通用语音模型——99 种语言 zero-shot ASR、英译、语种识别、VAD、词级时间戳用一套特殊 token 全部统一在 seq2seq 框架里,pip install 即可在笔记本上跑通,是当前开源 ASR 不可绕开的事实基线。
值得关注的理由
- 行业标准地位:101k+ stars、12k+ forks,衍生项目 faster-whisper / whisper.cpp / WhisperX / Distil-Whisper 全部以它为基座,OpenAI 顶会论文背书 + 一作 Jong Wook Kim 长期守门,权威性无可替代。
- 多任务统一范式值得借鉴:用
<|transcribe|><|translate|><|nospeech|>等特殊 token 把 5 个语音子任务塞进单一 seq2seq,丢掉流水线,这种「一模型多能力」的范式可推广到多任务 NLP 与跨模态生成。 - 「不修模型修解码器」的工程哲学:面对 seq2seq 通病 hallucination,作者不重训架构,而是用三道启发式阈值 + 温度回退兜住质量底线,是任何生成式模型部署都能复用的鲁棒解码模板。
项目展示
README 媒体
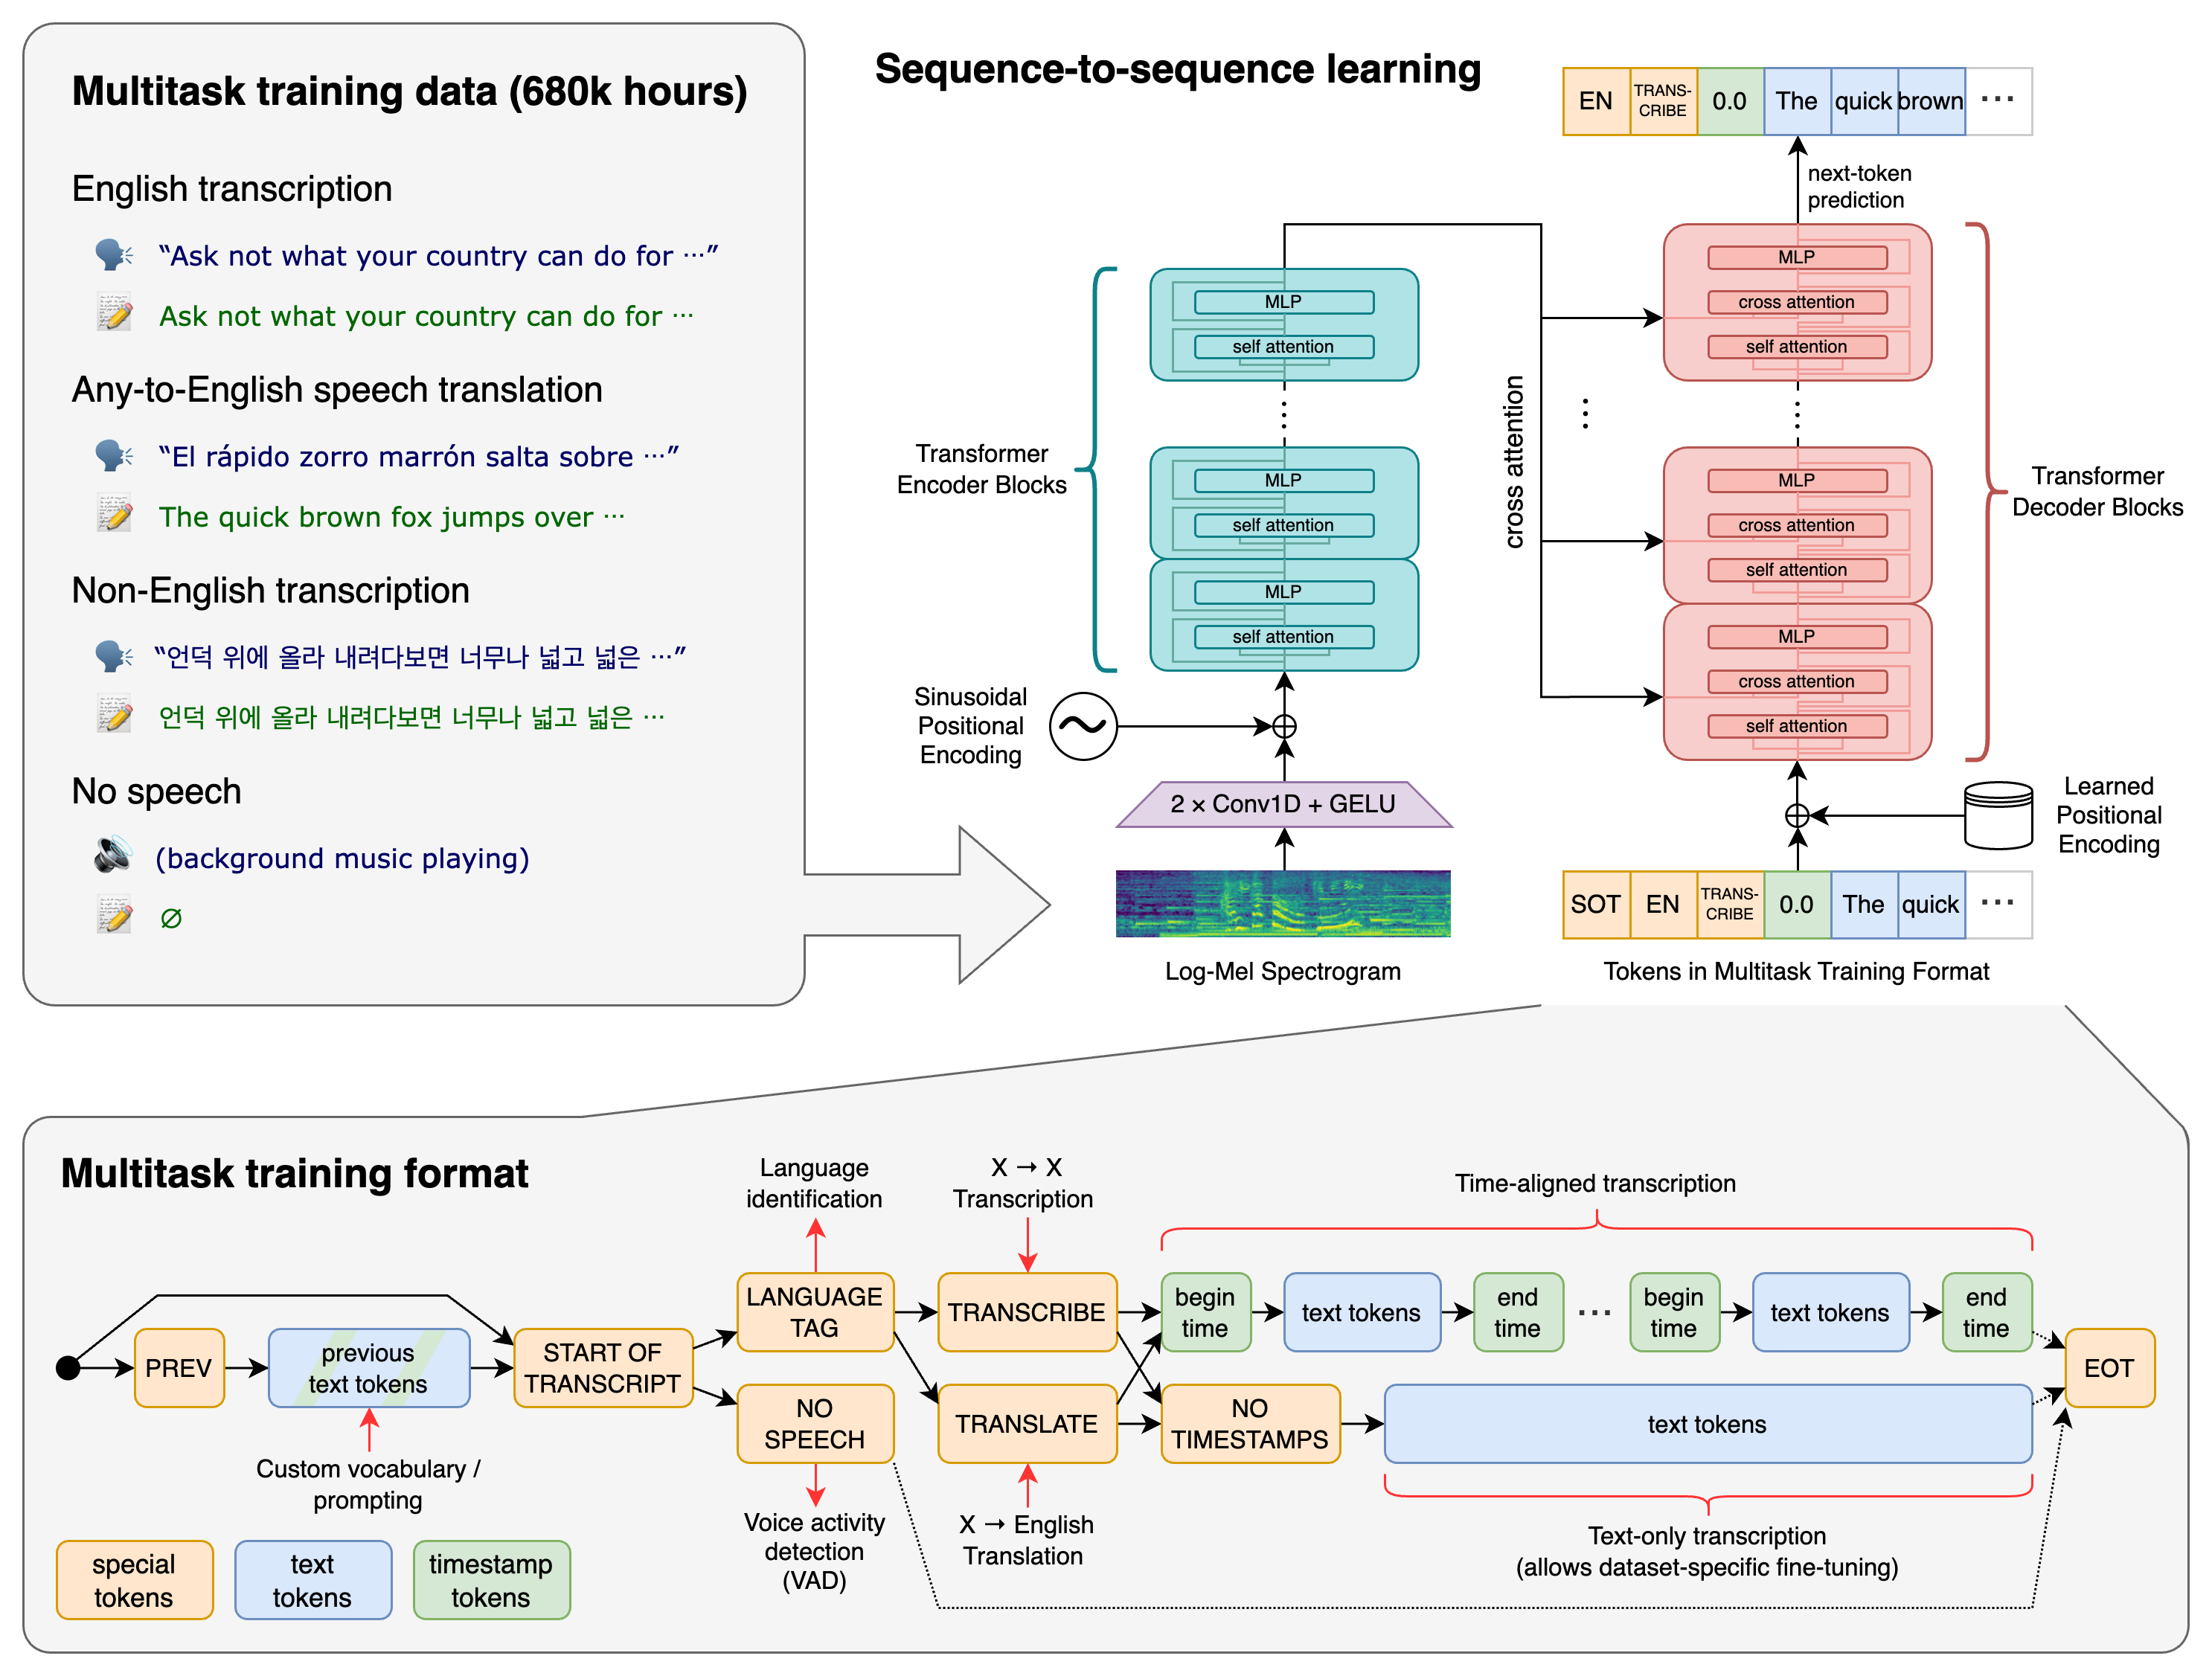 — 类型: architecture(论文 Approach 流程图,Encoder-Decoder + 30s 滑窗 + 任务 token)
— 类型: screenshot(多语种 WER 热力图,99 种语言在 FLEURS/CommonVoice 上的零样本表现)
筛选说明
- README 媒体共发现 2 个,全部保留(架构图 + 数据展示),均为 verified
- 官网(openai.com/index/whisper)WebFetch 403 拒访,官网媒体留空
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/openai/whisper |
| Star / Fork | 101,717 / 12,434 |
| 代码行数 | 13,791 行(SVG 59.5% / Python 25.2% / JSON 15.0% / 其他 0.3%) |
| 项目年龄 | 44.5 个月(首次提交 2022-09-22) |
| 开发阶段 | 低维护(近 365 天仅 10 个 commit,进入偶发维护期) |
| 贡献模式 | 单人主导(Top 1 贡献者 Jong Wook Kim 47.9%,含外围 83 位贡献者) |
| 热度定位 | 大众热门(OpenAI 旗下 ASR 标杆) |
| 质量评级 | 代码[优] 文档[优] 测试[中] CI/CD[优] |
作者视角:为什么存在这个项目
创始人/作者背景
Jong Wook Kim 是 OpenAI 研究科学家,也是论文《Robust Speech Recognition via Large-Scale Weak Supervision》的第一作者。他与 Alec Radford、Ilya Sutskever 共同主导了 Whisper 的设计与训练。OpenAI 官方组织账号作为发布主体,账号 10.7 年、122k 粉丝、255 个公开仓库,是业内少有的「能拿出 68 万小时弱监督数据 + 千卡 GPU 算力 + 顶会级论文背书」的玩家。
问题判断
传统 ASR 流水线(VAD → 声学模型 → 发音字典 → 语言模型 → 解码器)跨语种鲁棒性差,长尾领域(口音/噪音/术语)退化严重;主流自监督方案(wav2vec 2.0 / HuBERT)虽强却依赖大量领域微调,无法「下载即用」。Whisper 的赌注是:数据规模 + 任务统一可以替代工程经验——用 68 万小时多语种多任务数据训练单一模型,零样本即可在多数场景下接近人类水平。
解法哲学
- 不修模型修解码器:seq2seq 架构的 hallucination 通病,作者选择不改架构、不开源训练代码,而是在解码器外用 compression_ratio / logprob / no_speech 三道阈值 + 温度回退把症状兜住。
- 推理而非训练:仓库只发权重和推理代码,不开源训练脚本、不提供 fine-tuning API,主动放弃微调市场。
- 最小化 vendoring:6 个运行时依赖(more-itertools/numba/numpy/tiktoken/torch/tqdm),triton 条件依赖,pip install 即可在消费级 GPU 跑通。
- 不开源训练代码、开放推理生态:典型「中心化产出、分布式衍生」战略——OpenAI 借此坐拥行业标准地位,衍生项目反哺生态热度。
战略意图
Whisper 在 OpenAI 更大图景中处于「研究 demo + 生态锚点」位置:不开源训练代码、不开放微调脚本,但把权重、推理代码、tokenizer、normalizer、CLI、notebook 全部 MIT 释出。这份精准的开源策略让 OpenAI 既保有数据/算力优势,又让社区围绕 Whisper 衍生出 faster-whisper / whisper.cpp / Distil-Whisper / WhisperX 等完整生态——所有衍生项目都在为 OpenAI 的标准地位背书。
关联论文:Robust Speech Recognition via Large-Scale Weak Supervision(arXiv 2212.04356)
核心价值提炼
创新之处
按新颖度×实用性×可迁移性综合排序:
- 统一任务 token 化(新颖度 4/5 × 实用性 5/5 × 可迁移性 5/5)——用特殊 token 把 ASR/英译/lang_id/VAD/时间戳五任务统一到 seq2seq,单一损失函数训练,丢掉流水线
- 启发式解码 fallback(3/5 × 5/5 × 5/5)——compression ratio > 2.4 / avg_logprob < -1.0 / no_speech_prob > 0.6 三道闸门 + 温度回退(0 → 0.2 → 0.4 → 0.6 → 0.8 → 1.0),「不修模型修解码器」的鲁棒部署模板
- 已发现 cross-attention head + DTW 的无训练词级对齐(4/5 × 4/5 × 3/5)——把与时间戳强相关的 attention head 固化为
_ALIGNMENT_HEADS常量,推理时直接 DTW 反推词级时间戳 - Triton + Numba 双后端 + 字符串模板即时生成 bubble-sort kernel(3/5 × 3/5 × 2/5)——DTW/中值滤波热路径自实现 kernel,避开 torch.median 慢、scipy 不在 GPU 的算子缺失
可复用的模式与技巧
- 「CLI / Python API / Notebook」三层暴露同一能力——一个
transcribe()函数 + argparse CLI + Colab notebook,研究者/工程师/教学者各取所需 - 「哈希校验 + 集中权重表 + 集中对齐头表」——
_MODELS与_ALIGNMENT_HEADS集中常量,版本升级只需替换 URL 与字节,零外部依赖 - 「adapter-style Forward Hook 注入 KV cache」——用 PyTorch 原生 API 5 行代码获得 KV 缓存,0 侵入改造注意力
- 「四接口拆分解码器 (Inference / Ranker / Decoder / Filter)」——Greedy/BeamSearch 切换只需换对象,logit 后处理走 in-place filter 链
- 「device-aware kernel 自动回退」——Triton 优先,失败回落到 torch.sort,不让硬件栈短板阻塞主流程
- 「normalizer 链 + JSON 规则」——文本后处理按语言拆模块,数据驱动配置(normalizers/english.json),新增语种只需新增模块
- 「启发式阈值 + 温度回退」的鲁棒解码模板——三阈值 + 多温度组合,开源 seq2seq 模型低成本高回报的默认配置
关键设计决策
决策 1:用特殊 token 把多任务统一到 seq2seq 框架
- 问题:传统 ASR 流水线(VAD + lang_id + ASR + translation)多模型串行,工程复杂、延迟高、误差累积
- 方案:引入
<|transcribe|><|translate|><|nospeech|><|notimestamps|><|0.00|>…<|30.00|>等 token,task 切换和 language id 全部 token 化(tokenizer.py:131-275, decoding.py:80-113),甚至把语言检测 token 写回 SOT 序列 - Trade-off:单一损失函数无法针对各任务独立调优;seq2seq 通病(hallucination/长距离退化)难以根除;n_text_ctx=448 限制了 prompt 总长
- 可迁移性:高——任何多任务 NLP 场景(摘要/翻译/分类)都可复用
决策 2:30 秒硬切窗 + 启发式解码 fallback 而非流式
- 问题:训练侧 30s chunk 是工程效率与显存的最优折中;推理侧遇到静音/重复/幻觉段,要么错要么卡死
- 方案:三道闸门触发温度回退(0 → 0.2 → 0.4 → 0.6 → 0.8 → 1.0),transcribe.py:184-224
- Trade-off:无法实时/流式;长音频必须切分合并,边界可能丢失语义;参数敏感(社区普遍自行调优)
- 可迁移性:高——任何生成式模型都可借鉴「启发式校验 + 回退采样」
决策 3:把对齐做成「已发现的 attention head」而非训练新 head
- 问题:词级时间戳是体验关键,但从头训练对齐头需要额外数据
- 方案:论文先验式统计出与词级时间戳强相关的 head(large-v3: 16 层 × 20 head 布尔矩阵),base85+gzip 编码后作为
_ALIGNMENT_HEADS常量随仓库发布 - Trade-off:切头是「已固化」知识,新语种/新领域 head 选择不可调;社区 WhisperX 用 wav2vec2 重新对齐正是为了突破此限制
- 可迁移性:中——「预定义 head + DTW 后处理」可推广到多模态对齐
决策 4:Triton + Numba 双后端的热路径手写
- 问题:中值滤波与 DTW 是词时间戳热路径,torch.median 慢、scipy 不在 GPU、NumPy 不能在 GPU
- 方案:DTW 既写 Numba CPU 版(
dtw_cpu, parallel=True)也写 Triton GPU 版(dtw_kernel);中值滤波用字符串模板即时生成 bubble-sort kernel - Trade-off:复杂度集中在小众加速器;非 CUDA 用户落回 torch.sort
- 可迁移性:中-高——「为关键算子写 GPU kernel + CPU fallback」值得借鉴
决策 5:KV cache 用 PyTorch forward hook 而非改写注意力
- 问题:自回归解码需要缓存 K/V,重写注意力风险高
- 方案:
install_kv_cache_hooks在所有MultiHeadAttention.key/.value注册 forward hook,自动按 token 维拼接(model.py:310-341);配合rearrange_kv_cache支持 beam search 重排 - Trade-off:hook 引入的 Python 开销不可忽略;每个 step 触发 2 × n_layer 个 hook
- 可迁移性:高——任何 PyTorch seq2seq 模型都能 5 行代码获得 KV 缓存
竞品格局与定位
竞品对比矩阵
| 维度 | openai/whisper | faster-whisper (SYSTRAN) | whisper.cpp (ggerganov) | WhisperX (m-bain) | Distil-Whisper (HF) |
|---|---|---|---|---|---|
| Stars | 101k | 14k+ | 40k+ | 9k+ | 4k+ |
| 定位 | 研究基线 + 官方实现 | 生产部署首选 | 端侧/嵌入式 | 高精度时间戳+说话人分离 | 英文实时加速 |
| 速度 | 1×(原生 PyTorch) | 4×(CTranslate2) | 1-2×(纯 C/C++) | 70× 实时 | 6× 加速 |
| 显存/内存 | 中等 | 低 | 极低(量化到 Q4) | 中等 | 49% 参数 |
| 平台 | Python+消费级 GPU | Python+CPU/GPU | C/C++(Apple Silicon/移动/WASM/树莓派) | Python+GPU | Python+GPU |
| 训练/微调 | 不开源 | 不可训练 | 仅推理 | 不可训练 | 不可训练 |
| 时间戳精度 | 一般(cross-attn head) | 一般 | 不可用 | 极佳(wav2vec2 对齐) | 略弱 |
| 多语种 | 99 种 | 99 种 | 99 种 | 99 种 | 仅英文 |
| 维护节奏 | 低维护(近 1 年 10 commit) | 活跃 | 活跃 | 中等 | 活跃 |
差异化护城河
- 官方血统:OpenAI 论文与权重同步发布,顶会级背书,Jong Wook Kim 长期守门,权威性无可替代
- 极简 API 与最小依赖:6 个运行时依赖,pip install 即可在笔记本跑通
- 完整 normalizer + 词级时间戳 + 跨语种:99 种语言、词级时间戳、文本后处理链——三者齐全
- 生态锚点地位:所有衍生项目(faster-whisper/whisper.cpp/WhisperX/Distil-Whisper)的标准基线
- 论文与代码强绑定:arXiv 2212.04356 + 6 大模型权重 + 解码策略文档化完整
竞争风险
- 不提供训练/微调代码:微调市场被 Hugging Face / LoRA 生态蚕食
- 推理速度被全面超越:CTranslate2/faster-whisper 在 4× 速、whisper.cpp 在端侧、Distil-Whisper 在英文实时上都已经超过
- 流式能力完全缺位:WhisperLive / Insanely-fast-whisper 填补这一缺口
- 幻觉问题在严肃场景难落地:医疗/法律/金融场景下 seq2seq 通病难以根除
生态定位
不是「生产部署首选」而是「研究基线 + 教学/演示样板 + 衍生项目锚点」。任何多语种 ASR 项目的 PR/Issue 都会把它当对照基线。
套利机会分析
- 信息差:whisper 本身已无信息差(10万+ star + ASR 事实标准),但衍生生态(faster-whisper、whisper.cpp、WhisperX、Distil-Whisper)每个都值单独深入
- 技术借鉴:四个工程模板可立刻迁移到自己的项目——「统一任务 token」「启发式解码 fallback」「adapter 化 KV cache」「四接口拆分解码器」
- 生态位:填补了「下载即用、跨语种、零样本、pip install」这一空白——之前所有 ASR 都要领域微调
- 趋势判断:仓库本身已进入低维护期(近 1 年 10 commit),但生态外溢仍在加速;大型多模态(Canary/Parakeet)正在从企业级角度蚕食其地位,但研究侧的基线位置 5 年内不会动摇
风险与不足
- 训练代码不开放:无法复现/微调,微调需求被 Hugging Face 生态分流
- hallucination 通病未根除:启发式阈值是兜底而非根治,医疗/法律/金融场景下风险显著
- 流式能力缺位:30s 硬切窗导致实时/流式场景必须用衍生项目
- 测试覆盖薄:仅 4 个测试文件,test_transcribe 依赖真实权重,无 e2e 流式测试
- 无 lock file:仅 pyproject.toml 宽松约束,对生产部署不够友好
_get_audio_features有 bug:transcribe.py:660 的return TypeError(...)应为raise,且把 TypeError 当正常返回- 依赖 NVIDIA 闭源训练流程:生态外的人无法复现论文结果,只能消费权重
行动建议
-
如果你要用它:
- 研究/教学场景直接用 openai/whisper 原版,论文/代码/文档/Colab 全套齐
- 生产部署首选 faster-whisper(4× 速 + Silero VAD + CPU 可跑)
- 端侧/嵌入式选 whisper.cpp(Apple Silicon/移动/WASM/树莓派全覆盖)
- 需要精确时间戳 + 说话人分离选 WhisperX
- 英文实时选 Distil-Whisper(6× 速 + 49% 参数)
-
如果你要学它:
- 必读:
whisper/transcribe.py(CLI 入口 + 启发式 fallback)、whisper/decoding.py(四接口拆分解码器)、whisper/model.py(AudioEncoder + TextDecoder + KV cache hook) - 重点关注:
_ALIGNMENT_HEADS矩阵(__init__.py:36-51)、install_kv_cache_hooks(model.py:310-341)、decode_with_fallback(transcribe.py:184-224) - 推荐精读论文 arXiv 2212.04356(68 万小时弱监督 + 多任务 prompt 的设计哲学)
- 必读:
-
如果你要 fork 它:
- 短期可做:①补 e2e 流式接口(社区最大痛点);②补充更多语种 normalizer(目前仅 basic + english);③修
_get_audio_features的 TypeError bug - 中期可做:①把 KV cache 换成编译期优化(torch.compile + CUDA graph);②训练代码的社区化重写(填补 OpenAI 主动放弃的微调市场)
- 长期可做:跨模态扩展(Whisper + LLM 联合推理,Audio-LLM 方向)
- 短期可做:①补 e2e 流式接口(社区最大痛点);②补充更多语种 normalizer(目前仅 basic + english);③修
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | deepwiki.com/openai/whisper |
| Zread.ai | 未收录(WebFetch 403) |
| 关联论文 | Robust Speech Recognition via Large-Scale Weak Supervision |
| 在线 Demo | huggingface.co/spaces/openai/whisper(2.76k likes) |
| 衍生生态 | faster-whisper · whisper.cpp · WhisperX · Distil-Whisper |