14k star 的 OpenMetadata:一份 JSON Schema 生成全栈,再喂给 AI 当上下文
一句话总结
OpenMetadata 是企业级开源元数据/数据治理统一平台(数据目录、血缘、质量、可观测性、数据契约),用 schema-first 的方法论把元数据标准化——一份 JSON Schema 同时生成 Java/Python/TypeScript 类型、驱动数据库存储、渲染 UI 表单、定义 AI 工具契约;2026 年它正从「数据目录」升维为「Data 与 AI 的开放语义上下文层」。
值得关注的理由
- schema-first 贯彻到极致的工程范本:不是「先写代码再补 schema」,而是「JSON Schema 是唯一事实源,其它产物都是它的投影」。874 个 schema 文件向外辐射到 6 个面(三语言类型 + DB + UI 表单 + MCP 工具),跨栈零漂移——这套 codegen 管线对任何多语言平台都极具借鉴价值。
- 不用图数据库、不用 Kafka,在普通 MySQL 上跑出「数据知识图谱」:实体整体存 JSON 列 + 通用边表承载关系图,正面切 DataHub「实时但运维重」的最大软肋(OpenMetadata 卖点是「仅四个系统组件」)。
- 早一步卡住「AI 上下文层」生态位:README 直接喊「AI does not need another raw database connector. AI needs context.」——通过 MCP server 把治理后、带血缘和质量信号的元数据喂给 AI agent,护城河从「连接器数量」升级为「受治理的可信上下文 + 开放标准」。
项目展示
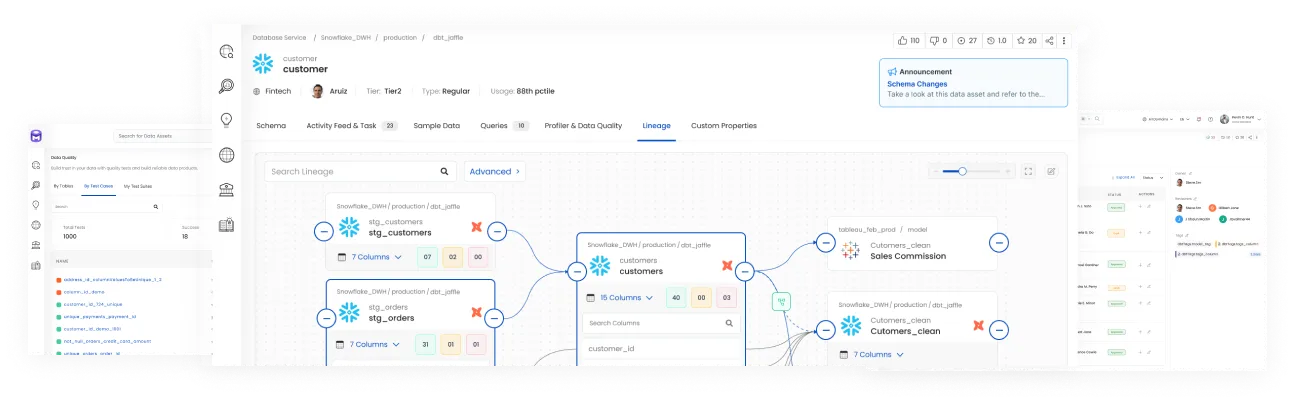
OpenMetadata 产品横幅——统一的元数据平台,一站式覆盖发现、可观测、治理、质量、协作、血缘。
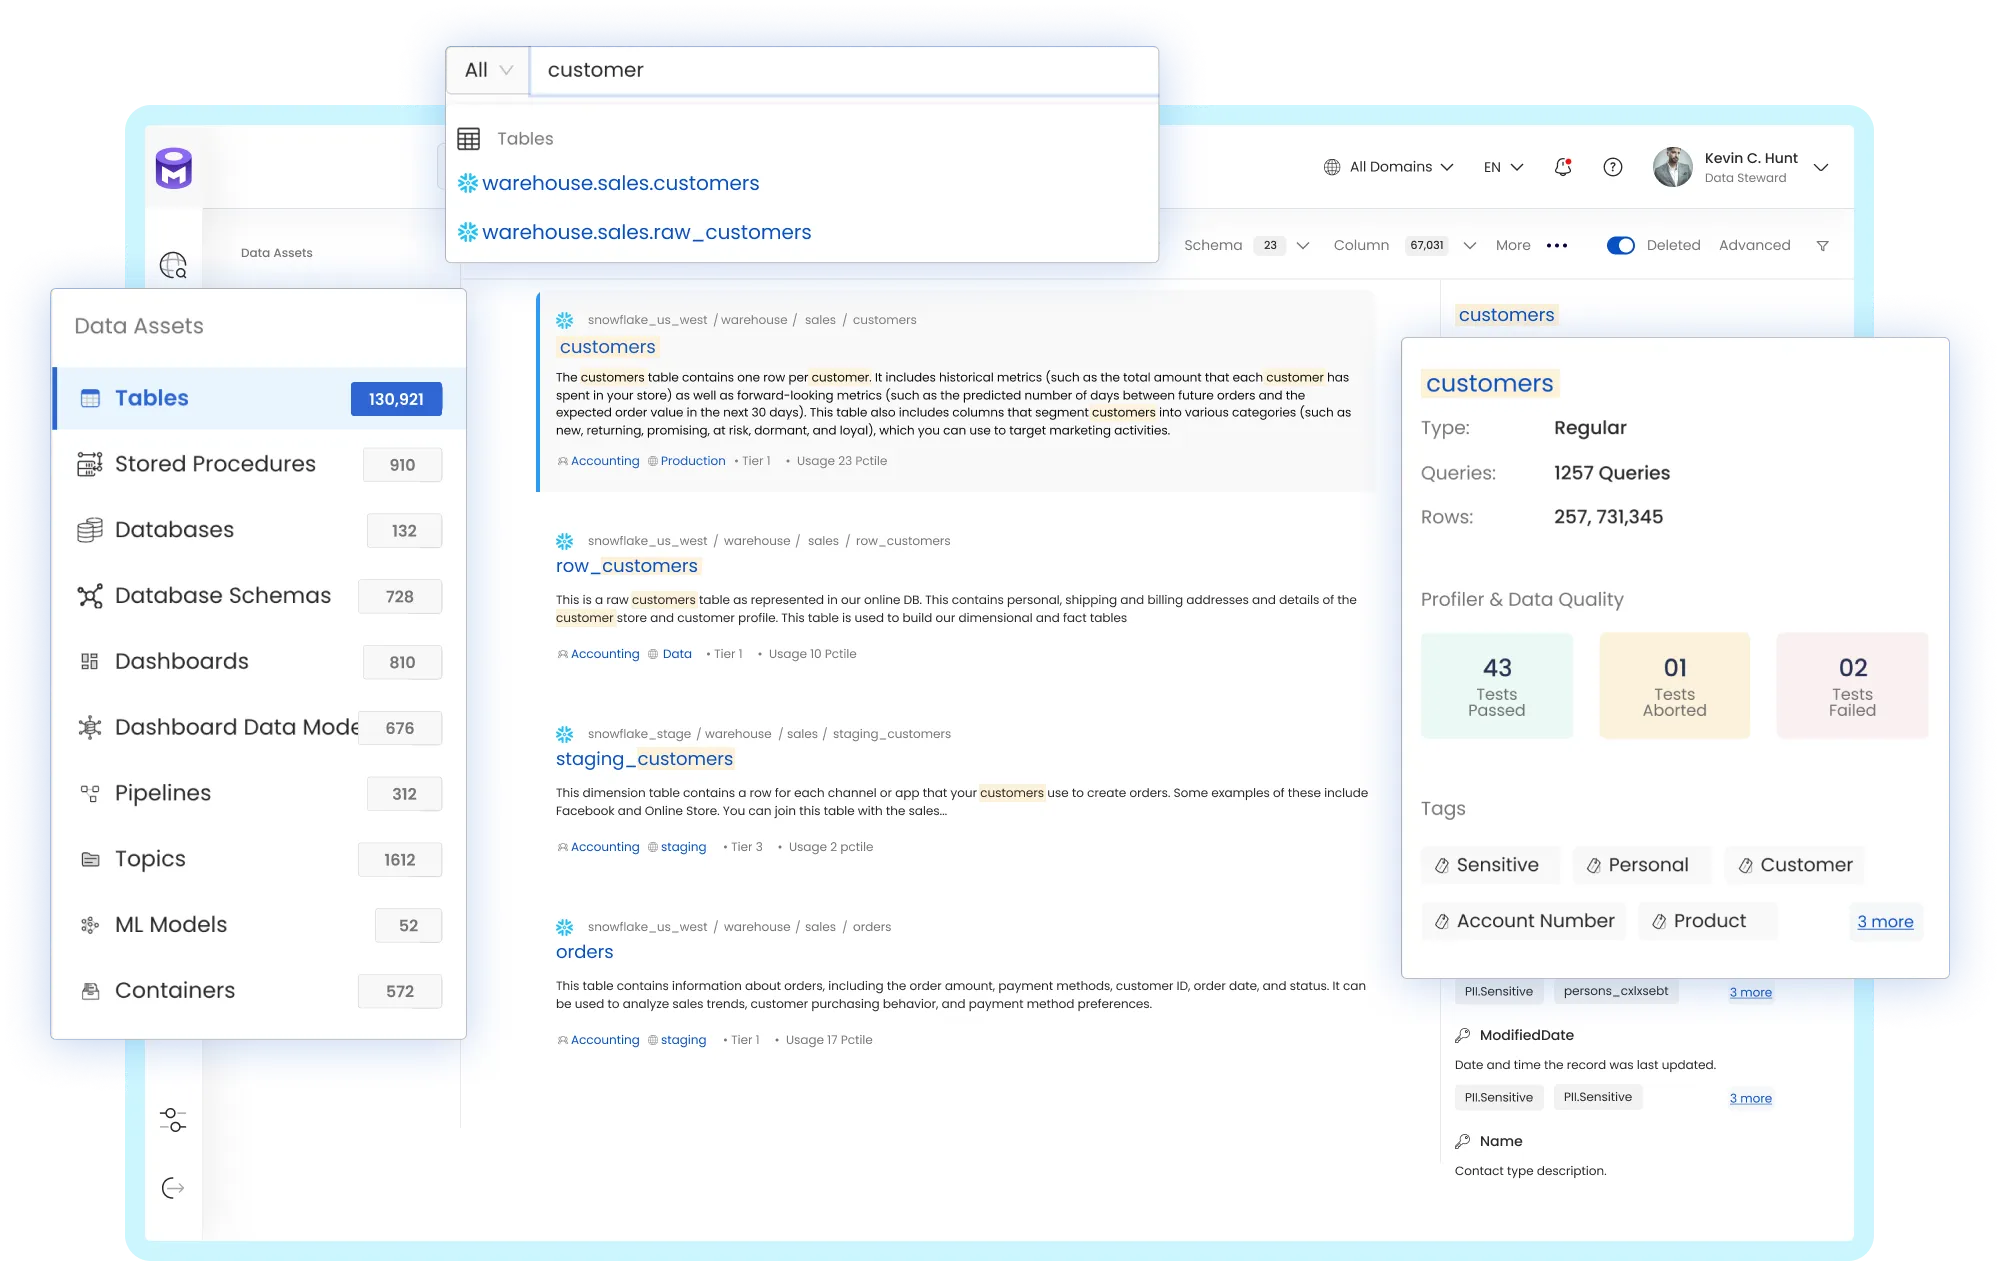
数据发现界面:技术与非技术用户都能用的 UI,业务分析师无需工程师介入即可探索数据资产。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/open-metadata/OpenMetadata(官网 https://open-metadata.org,沙箱 https://sandbox.open-metadata.org) |
| Star / Fork | 14,129 / 2,142(Watcher 54、open issues 557、open PR 312) |
| 代码行数 | 241.9 万行 / 14,237 文件(三栈巨型 monorepo:Java 后端约 65 万行 + React/TS 前端约 85 万行 + JSON Schema 46.6 万行 + Python ingestion 34.8 万行) |
| 项目年龄 | 58.3 个月 / 4.9 年(2021-08-01 起,活跃至 2026-06-08) |
| 开发阶段 | 密集开发(月均约 288 commit,近 30 天 407、近 90 天 1,226,2026 上半年是开站以来最猛的爆发段) |
| 贡献模式 | 公司团队 + 大型社区(492 名贡献者,Top1 仅占 6.5%,高度分散) |
| 热度定位 | 大众热门、高速增长(开源数据目录赛道第二,仅次于 DataHub) |
| 质量评级 | 代码[优] 文档[优] 测试[优] |
作者视角:为什么存在这个项目
创始人/作者背景
背后商业主体是 Collate(VC-backed startup,cloud.getcollate.io)。核心团队即创始团队——Top 贡献者 Sriharsha Chintalapani(harshach,Collate 联合创始人/CEO,1685 commits)出身 Uber 数据平台、Hortonworks/Apache 体系;Pere Miquel Brull 等也是 Collate 全职工程师。492 名贡献者、Top1 仅占 6.5%,说明已超出公司团队形成真社区。
问题判断
团队在 Uber 量级的数据平台运营中反复踩到「元数据没有统一标准、每个系统各自为政、血缘/治理拼不起来」的痛。这直接催生了第一性原理:先定义元数据的标准(schema),再谈系统。这与 DataHub(LinkedIn 系,从「事件流」视角切入)形成方法论分野——一个先标准化「数据模型」,一个先标准化「变更事件」。
解法哲学
schema-first 是项目灵魂,且贯彻得极其彻底:在 openmetadata-spec 定义实体后,向外辐射到 6 个面——① jsonschema2pojo 生成带校验的 Java POJO;② datamodel-code-generator 生成 Pydantic v2;③ quicktype 生成 TS 类型;④ 实体整体存 DB 的 JSON 列;⑤ react-jsonschema-form 直接吃 schema 渲染 UI 表单;⑥ MCP 工具参数复用同一套。明确「不做什么」:不做 DataHub 式的 Kafka 事件总线(选择关系库 + 通用边表承载图)、不为每种实体写专用 API(用泛型基类统一)。trade-off 取向是「标准化与运维简单优先于实时性」。
战略意图
经典 open-core 三段卡位:① 开源内核(Apache-2.0)做标准与社区飞轮;② Collate Cloud 托管/企业支持变现;③ 第三跳是抢占「AI 上下文层」生态位——openmetadata-mcp 把治理后的元数据通过 MCP 协议喂给 Claude/Cursor 等 AI 客户端。把「元数据目录」重新定义为「AI 时代的语义上下文基础设施」。
核心价值提炼
创新之处
- schema-first 单一事实源 → 6 路辐射 — 一份 JSON Schema 同时生成 Java/Python/TS 类型、驱动 DB 的 JSON 列存储、rjsf 渲染 UI 表单、定义 MCP tool 契约。新颖度 4/5、实用性 5/5、可迁移性 5/5。
- JSON-blob + 生成列的关系库文档化存储 — 实体整体存 JSON 列,索引字段全用
GENERATED ALWAYS AS (json_extract())投影,schema 加字段免ALTER TABLE。新颖度 4/5、实用性 5/5、可迁移性 5/5。 - 通用 entity_relationship 边表 = 知识图谱跑在普通 RDBMS 上 — 一张带类型的邻接表(fromId/toId/fromEntity/toEntity/relation)+ field_relationship 列级血缘表,在 MySQL/PG 上实现「统一元数据图谱」,省掉图库/Kafka。新颖度 3/5、实用性 4/5、可迁移性 4/5。
- 声明式 ServiceTopology DAG + 动态生成的上下文模型 — 120+ 连接器只声明「拓扑」(service→database→schema→table→column 的 DAG),框架统一驱动遍历,并用
create_model动态合成 Pydantic 上下文模型在节点间传递实体、自动构建 FQN。连接器作者只写「怎么从源系统取数」。新颖度 4/5、实用性 4/5、可迁移性 4/5。 - MCP 把「治理后」元数据(含血缘/质量/RCA)作为一等公民喂给 AI agent — 16 个富 LLM 描述的工具(读侧 search/semantic_search/get_lineage/root_cause_analysis,写侧 create_glossary_term/patch_entity/create_lineage…)+ OAuth 受治理访问 + 读写分级。新颖度 5/5、实用性 4/5、可迁移性 3/5。
可复用的模式与技巧
- schema-as-source codegen 管线:单一 JSON Schema → 多语言/多产物自动生成,跨栈零漂移。
- 关系库 JSON 列 + 生成列投影:把 RDBMS 当文档库用又保 SQL 索引,免频繁 DDL——适用模型快速演进的业务。
- 通用类型化邻接表存图:
(from, to, fromType, toType, relation, json)一表存任意关系图——适用中等规模图谱、拒绝额外图库。 - 泛型基类 + 少量抽象钩子:
EntityResource/EntityRepository把版本化/软删/PATCH/搜索/血缘等横切逻辑沉到基类,子类只填setFields/prepare/storeEntity/storeRelationships等 5 个抽象方法——百种实体共享,新增实体几十行。 - 声明式拓扑 + 动态上下文模型:插件只声明 DAG,引擎统一驱动——适用大批量同构爬取/ETL 插件框架。
- 领域系统 MCP 化:富描述 tool + OAuth + 读写分级,让 AI agent 安全消费既有平台。
关键设计决策
- 搜索/血缘下沉到 ES/OpenSearch 双引擎抽象:
SearchClient接口 +SearchRepositoryFactory同时适配 Elasticsearch 与 OpenSearch,写入侧有 BulkSink + 熔断器 + 分布式索引策略等工业级重索引编排;MCP 的关键词搜索与语义搜索都建在这层之上。 - 泛型 EntityResource / EntityRepository 基类:基类极重(EntityRepository 8000+ 行)但子类只需实现 5 个差异化钩子,所有实体共享版本化、软删除、关系、标签、PATCH 语义。
竞品格局与定位
竞品对比矩阵
| 维度 | OpenMetadata | DataHub | Amundsen | Apache Atlas | Collibra/Atlan(商业) |
|---|---|---|---|---|---|
| 体量 | 14.1k★ | ~11.8k★ | ~4.5k★ | ~1.9k★ | 闭源企业 |
| 架构 | 四组件(无 Kafka) | Kafka 事件驱动(重) | 轻量 | Hadoop 生态 | SaaS |
| 扩展性 | schema-first 强类型 | 事件模型 | 弱 | 中 | 配置化 |
| 实时性 | 批/近实时 | 实时流 | 弱 | 中 | — |
| 治理深度 | 全栈(质量/契约/术语) | 丰富 | 薄弱 | 中 | 业务语境最深 |
| AI/MCP | 原生 MCP + 语义搜索 | 跟进中 | 无 | 无 | 增值 |
差异化护城河
① schema-first 开放标准(标准本身是网络效应资产);② 「全功能 + 仅四组件」的运维简单性,正面切 DataHub 的最大软肋;③ 原生 MCP + 治理后上下文,早一步卡住「AI 数据上下文层」生态位;④ 120+ 连接器靠声明式拓扑框架可持续扩展。
竞争风险
① 自托管仍重(MySQL/PG + ES/OS + server + 摄取),相对 SaaS 目录有运维门槛;② 超大规模血缘的关系库递归遍历 + UI 渲染是结构性短板,正面对上 DataHub 实时血缘时吃亏;③ AI 上下文层是兵家必争,DataHub 与商业巨头会快速跟进 MCP;④ 业务语境富化相对 Collibra/Atlan 仍偏工程师向。
生态定位
开源元数据双雄之一——「商业目录的自托管平替(约 80% 功能 / $0 license)」+「数据与 AI 的开放语义上下文层」,靠开放标准 + 架构简单 + AI 卡位三条腿站位。整个开源数据目录赛道 2026 集体向「AI 上下文层」迁移(DataHub 同期改口号为「The Context Platform for your Data and AI Stack」)。
套利机会分析
- 信息差:已是 14k★ 头部成熟项目,非「早期套利」标的;但「数据治理 × AI agent 上下文层」是 2026 热点交叉,叙事新鲜度高,且 schema-first/JSON Schema 方法论是中文社区稀缺可写点,适合做深度技术解读。
- 技术借鉴:「schema-first 全栈代码生成」「JSON 列 + 生成列把 RDBMS 当文档库」「通用边表存知识图谱」「声明式拓扑连接器框架」「领域系统 MCP 化」五项可直接迁移。
- 生态位:填补了「开源 + 全功能 + 架构简单 + AI 上下文」一体化的空白。
- 趋势判断:踩在「数据治理 + AI agent 上下文」两个上升趋势上,原生 MCP 集成具备先发卡位优势;但要警惕超大规模血缘的性能结构性短板。
风险与不足
- 自托管组件数(4 个)对小团队仍偏重,缺轻量单机模式。
- 超大规模血缘的图遍历/UI 渲染性能:关系库递归 join 是结构性短板,500+ 节点血缘图 UI 渲染会卡,这是「在 RDBMS 上跑图」的代价。
- 重基类的理解门槛:EntityRepository 8000+ 行、改动半径大;schema 改一处牵动全链路重新生成,构建链复杂、生成代码不可手改。
- 相对商业巨头偏工程师向:业务语境富化、面向业务用户的体验与工作流/审批,相比 Collibra/Alation/Atlan 仍有差距;开源层无官方支持(需 Collate Cloud)。
行动建议
- 如果你要用它:想要全功能数据目录 + 治理 + 血缘 + 质量,又拒绝 DataHub 的 Kafka 运维——OpenMetadata 是开源里最均衡的选择,可先用官方沙箱 https://sandbox.open-metadata.org 零安装试用。只做轻量数据发现选 Amundsen;要实时事件驱动血缘选 DataHub;要企业级业务治理且预算充足选 Collibra/Atlan。
- 如果你要学它:重点看 schema 源
openmetadata-spec/.../schema/entity/data/table.json与三语言 codegen(openmetadata-spec/pom.xml的 jsonschema2pojo、scripts/datamodel_generation.py、UI 的json2ts.sh);实体抽象看EntityRepository.java/EntityResource.java;存储模型看bootstrap/sql/schema/mysql.sql(table_entity / entity_relationship / field_relationship);连接器框架看ingestion/.../api/steps.py与models/topology.py;MCP 看openmetadata-mcp/.../McpServer.java与tools.json。 - 如果你要 fork 它:可改进方向是优化超大规模血缘遍历(考虑物化视图或专用图存储旁路)、提供轻量单机部署模式;但要清楚 Collate Cloud 的 AI 增值(collate-ai-proxy)是闭源,fork 只能得到社区内核。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/open-metadata/OpenMetadata(已收录,含系统架构/摄取框架/UI/部署 30+ 主题) |
| Zread.ai | 未确认(返回 403) |
| 关联论文 | 无(工程平台型项目) |
| 在线 Demo | 官方沙箱 https://sandbox.open-metadata.org(零安装,含样例数据 + 75+ 连接器) |