10k star 的开源 Neuro-sama 平替:一个人把 22 个语音引擎拼成本地 AI 伴侣
一句话总结
Open-LLM-VTuber 是一个跨平台、可完全本地离线运行的开源 AI 伴侣框架——用「免手操语音对话 + 可随时打断 + Live2D 会说话的脸」复刻闭源的 Neuro-sama,背后是一套把 22 个 TTS、8 个 ASR、多家 LLM 自由拼装的可插拔架构。
值得关注的理由
- 赛道事实标准底座:10,394 star 在「开源 AI VTuber / Live2D AI 伴侣」赛道断层领先,竞品多在千星量级,且已衍生出大量直接 fork(Open-LLM-VTuber-x、LLM-Live2D-Desktop-Assistant 等),是别人方案的上游。
- 可复用的工程范式密集:流式装饰器多模态管线、并发生成+序号重排的 TTS 交付、工具调用「原生→prompt」运行时降级、配置即产品 API——这些是脱离「AI 伴侣」场景也能直接迁移的高质量模式。
- 典型的「人气惯性 > 当前投入」反差信号:star 仍以约 150–200/天高速流入,但代码已进入低维护(近 90 天仅 1 commit),核心逻辑高度依赖单一开发者、且零自动化测试——一个值得拆解的「成熟期开源项目」标本。
项目展示
 项目 Banner — 开源、跨平台的 LLM 驱动 Live2D AI 伴侣。
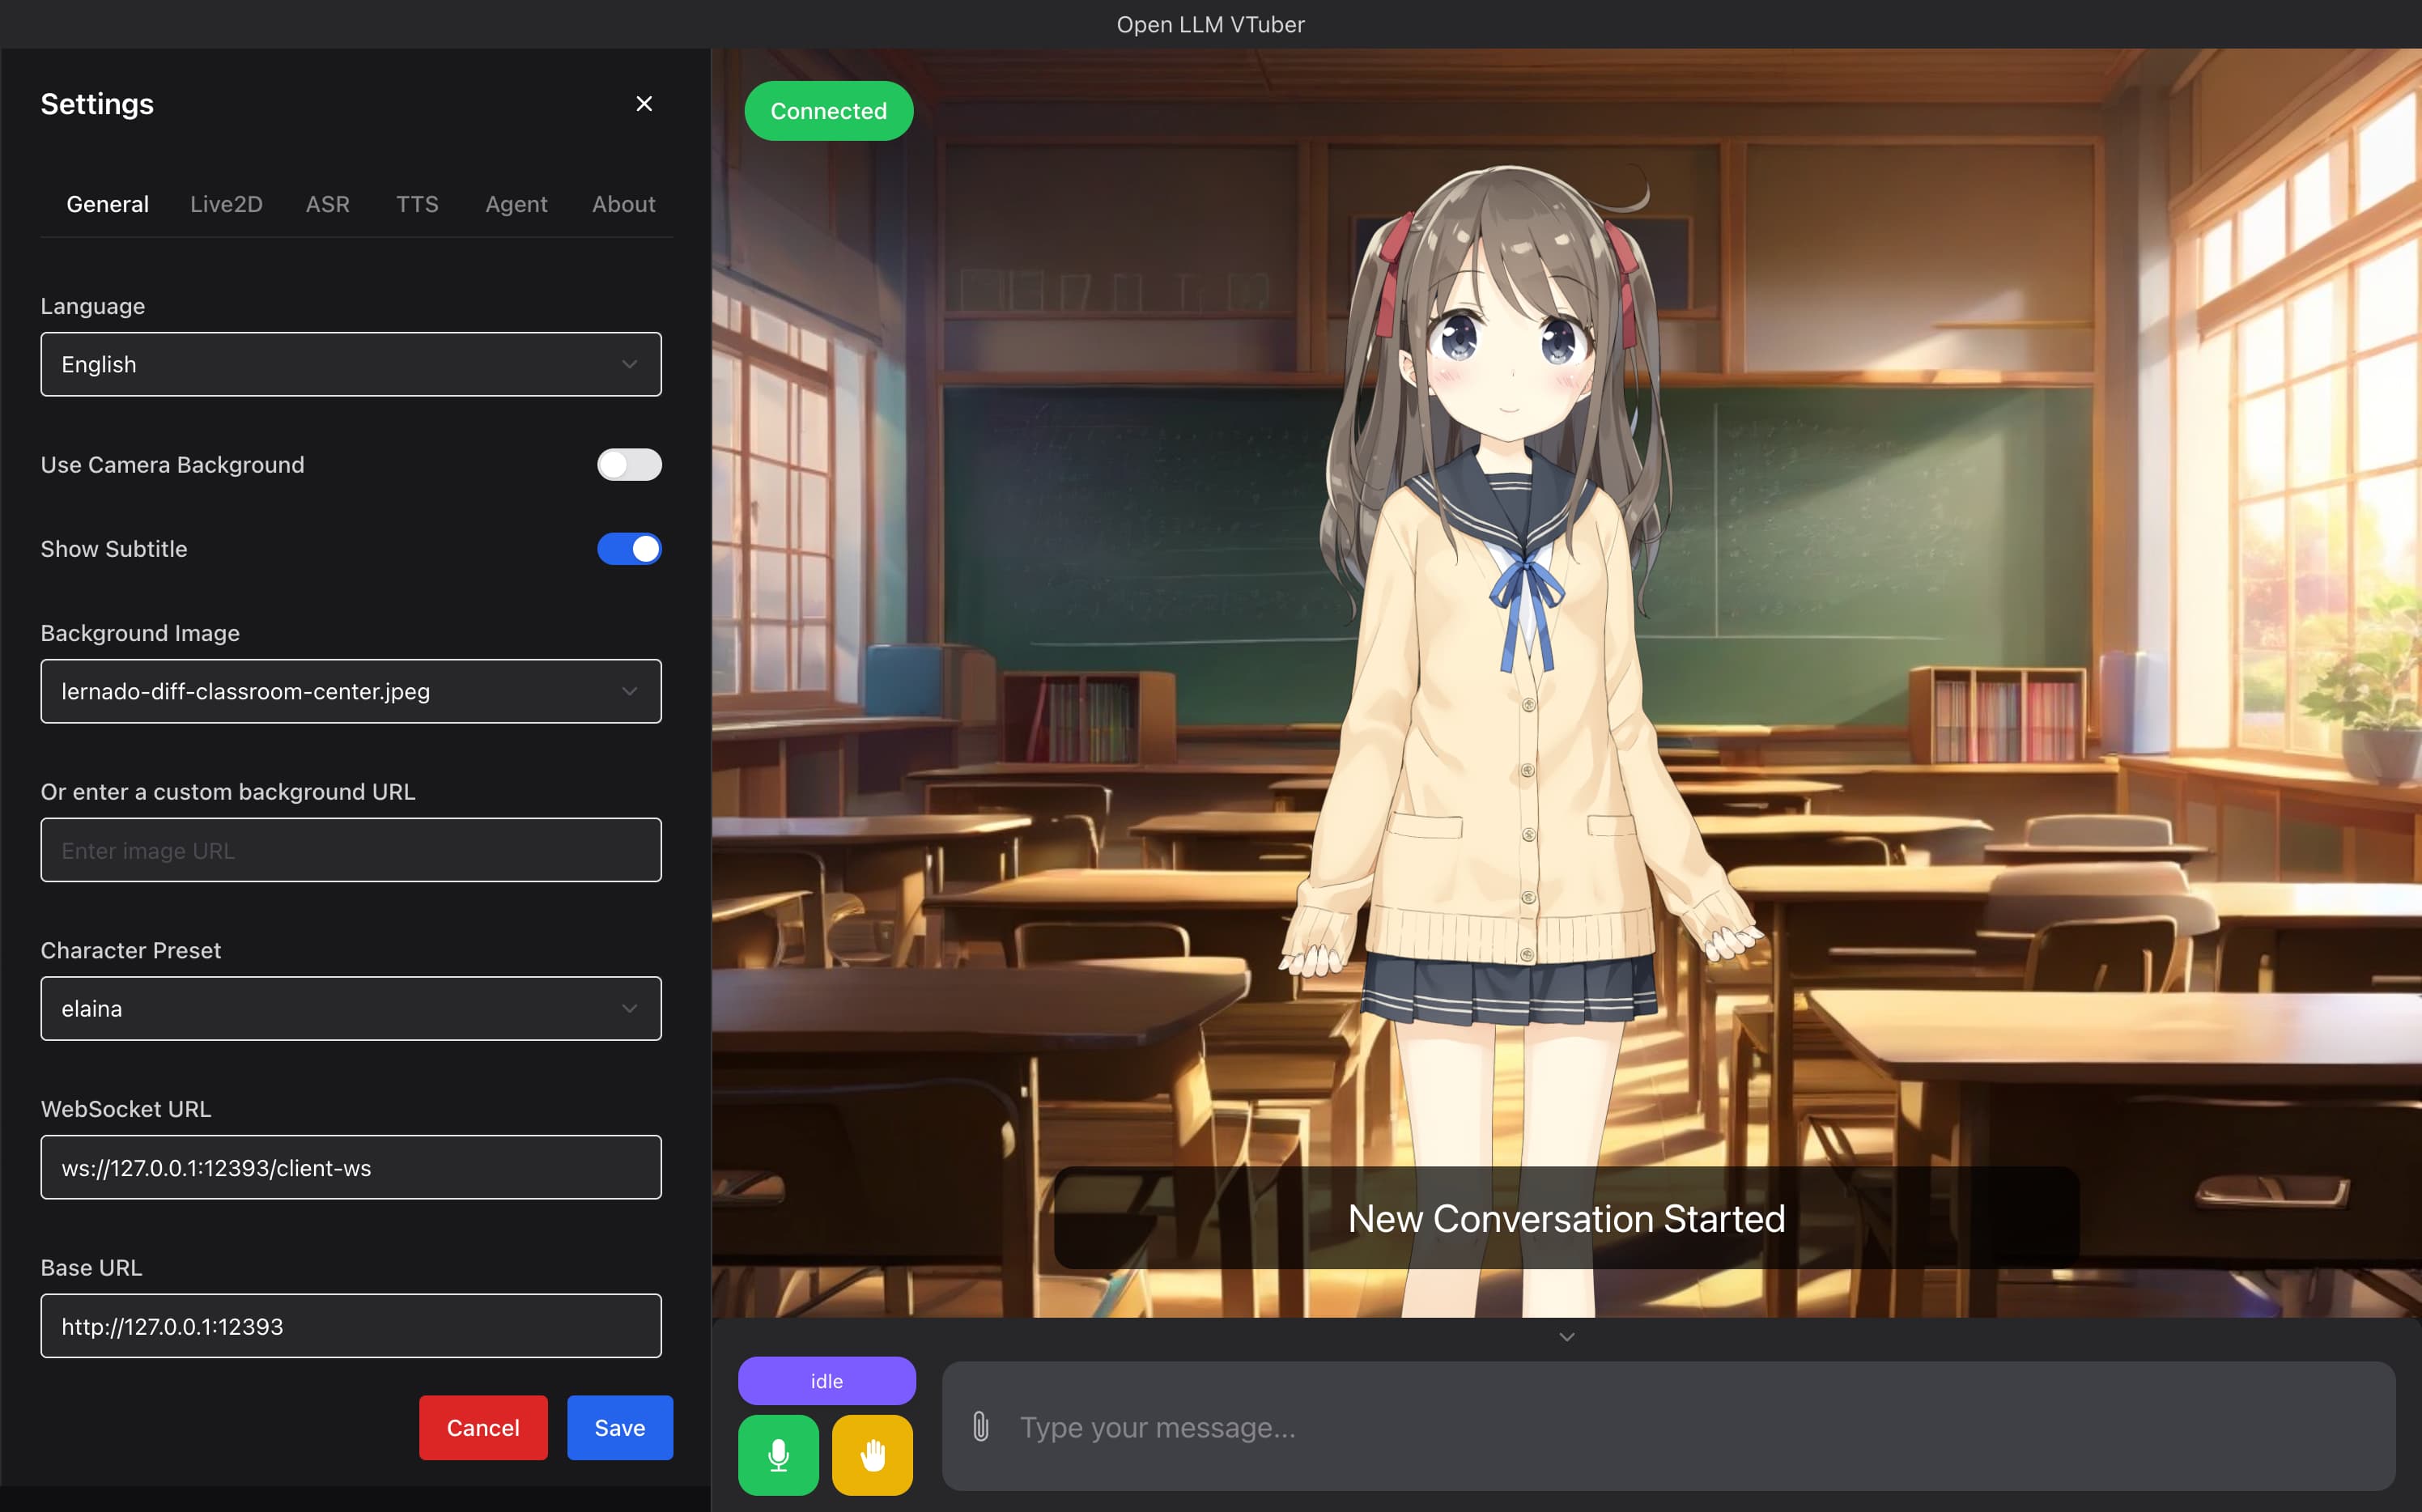 交互界面:语音/文字对话 + Live2D 形象实时表情联动。
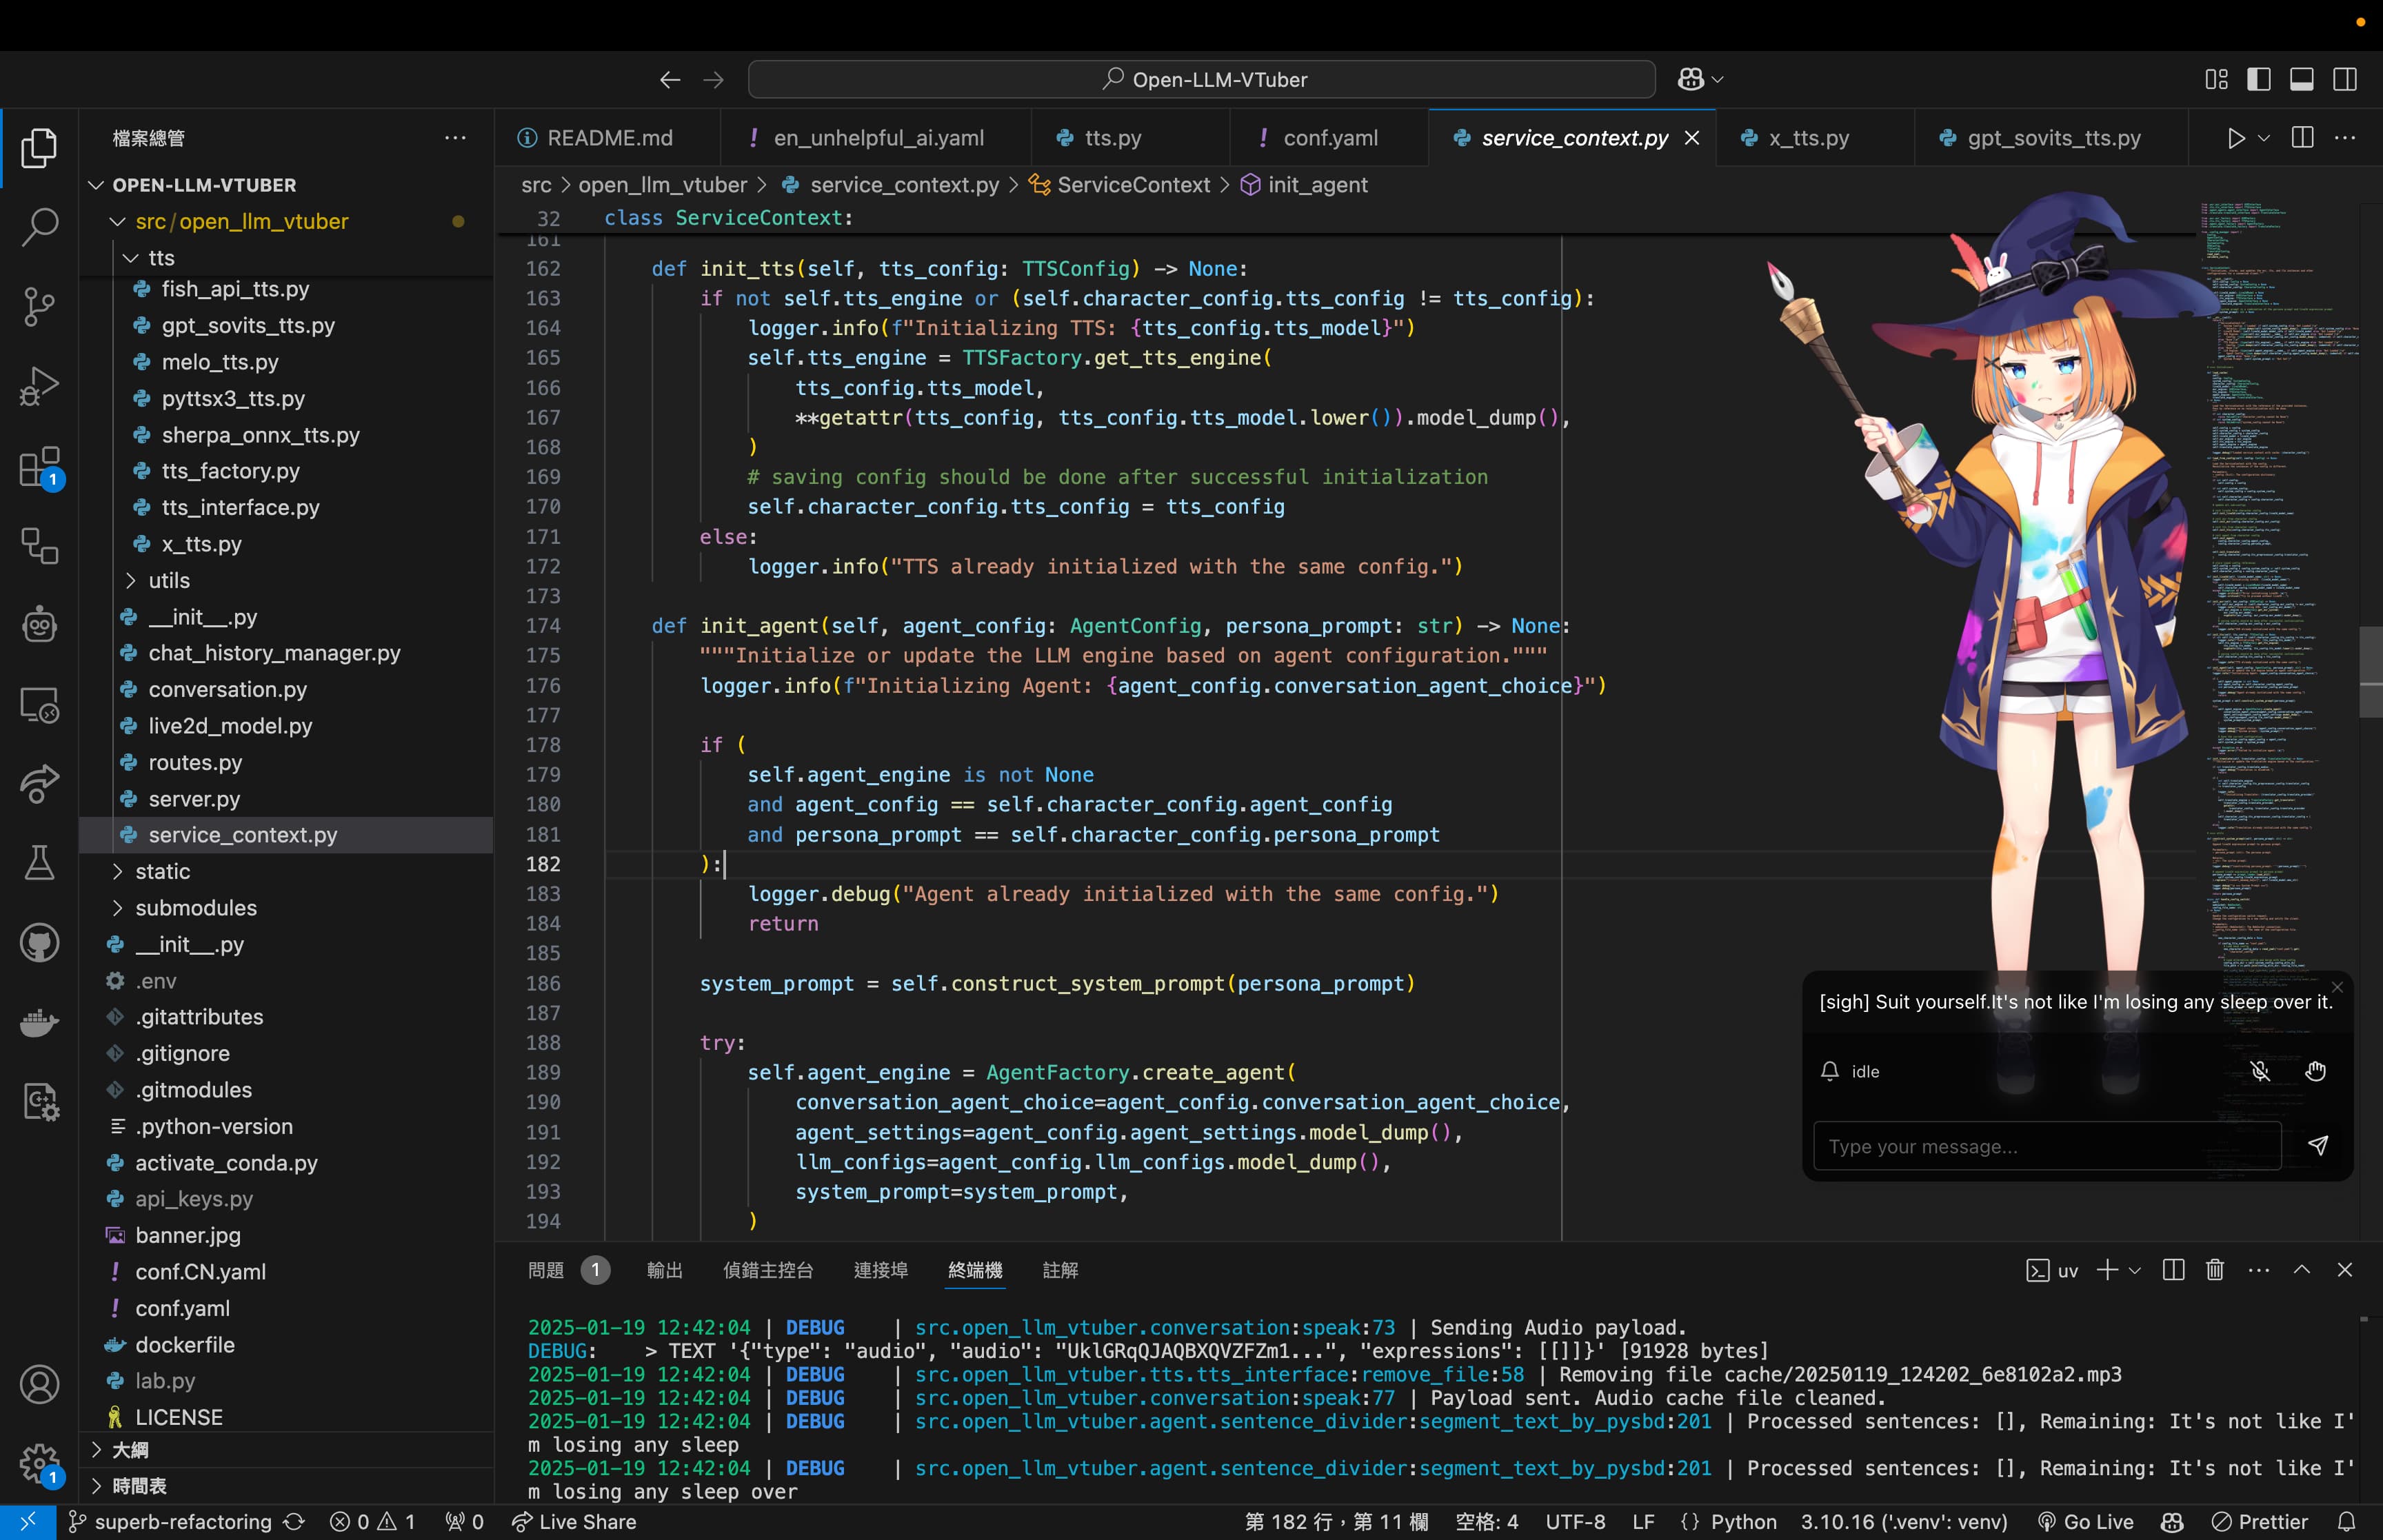 桌宠悬浮模式:透明背景、可折叠界面的桌面伴侣形态。
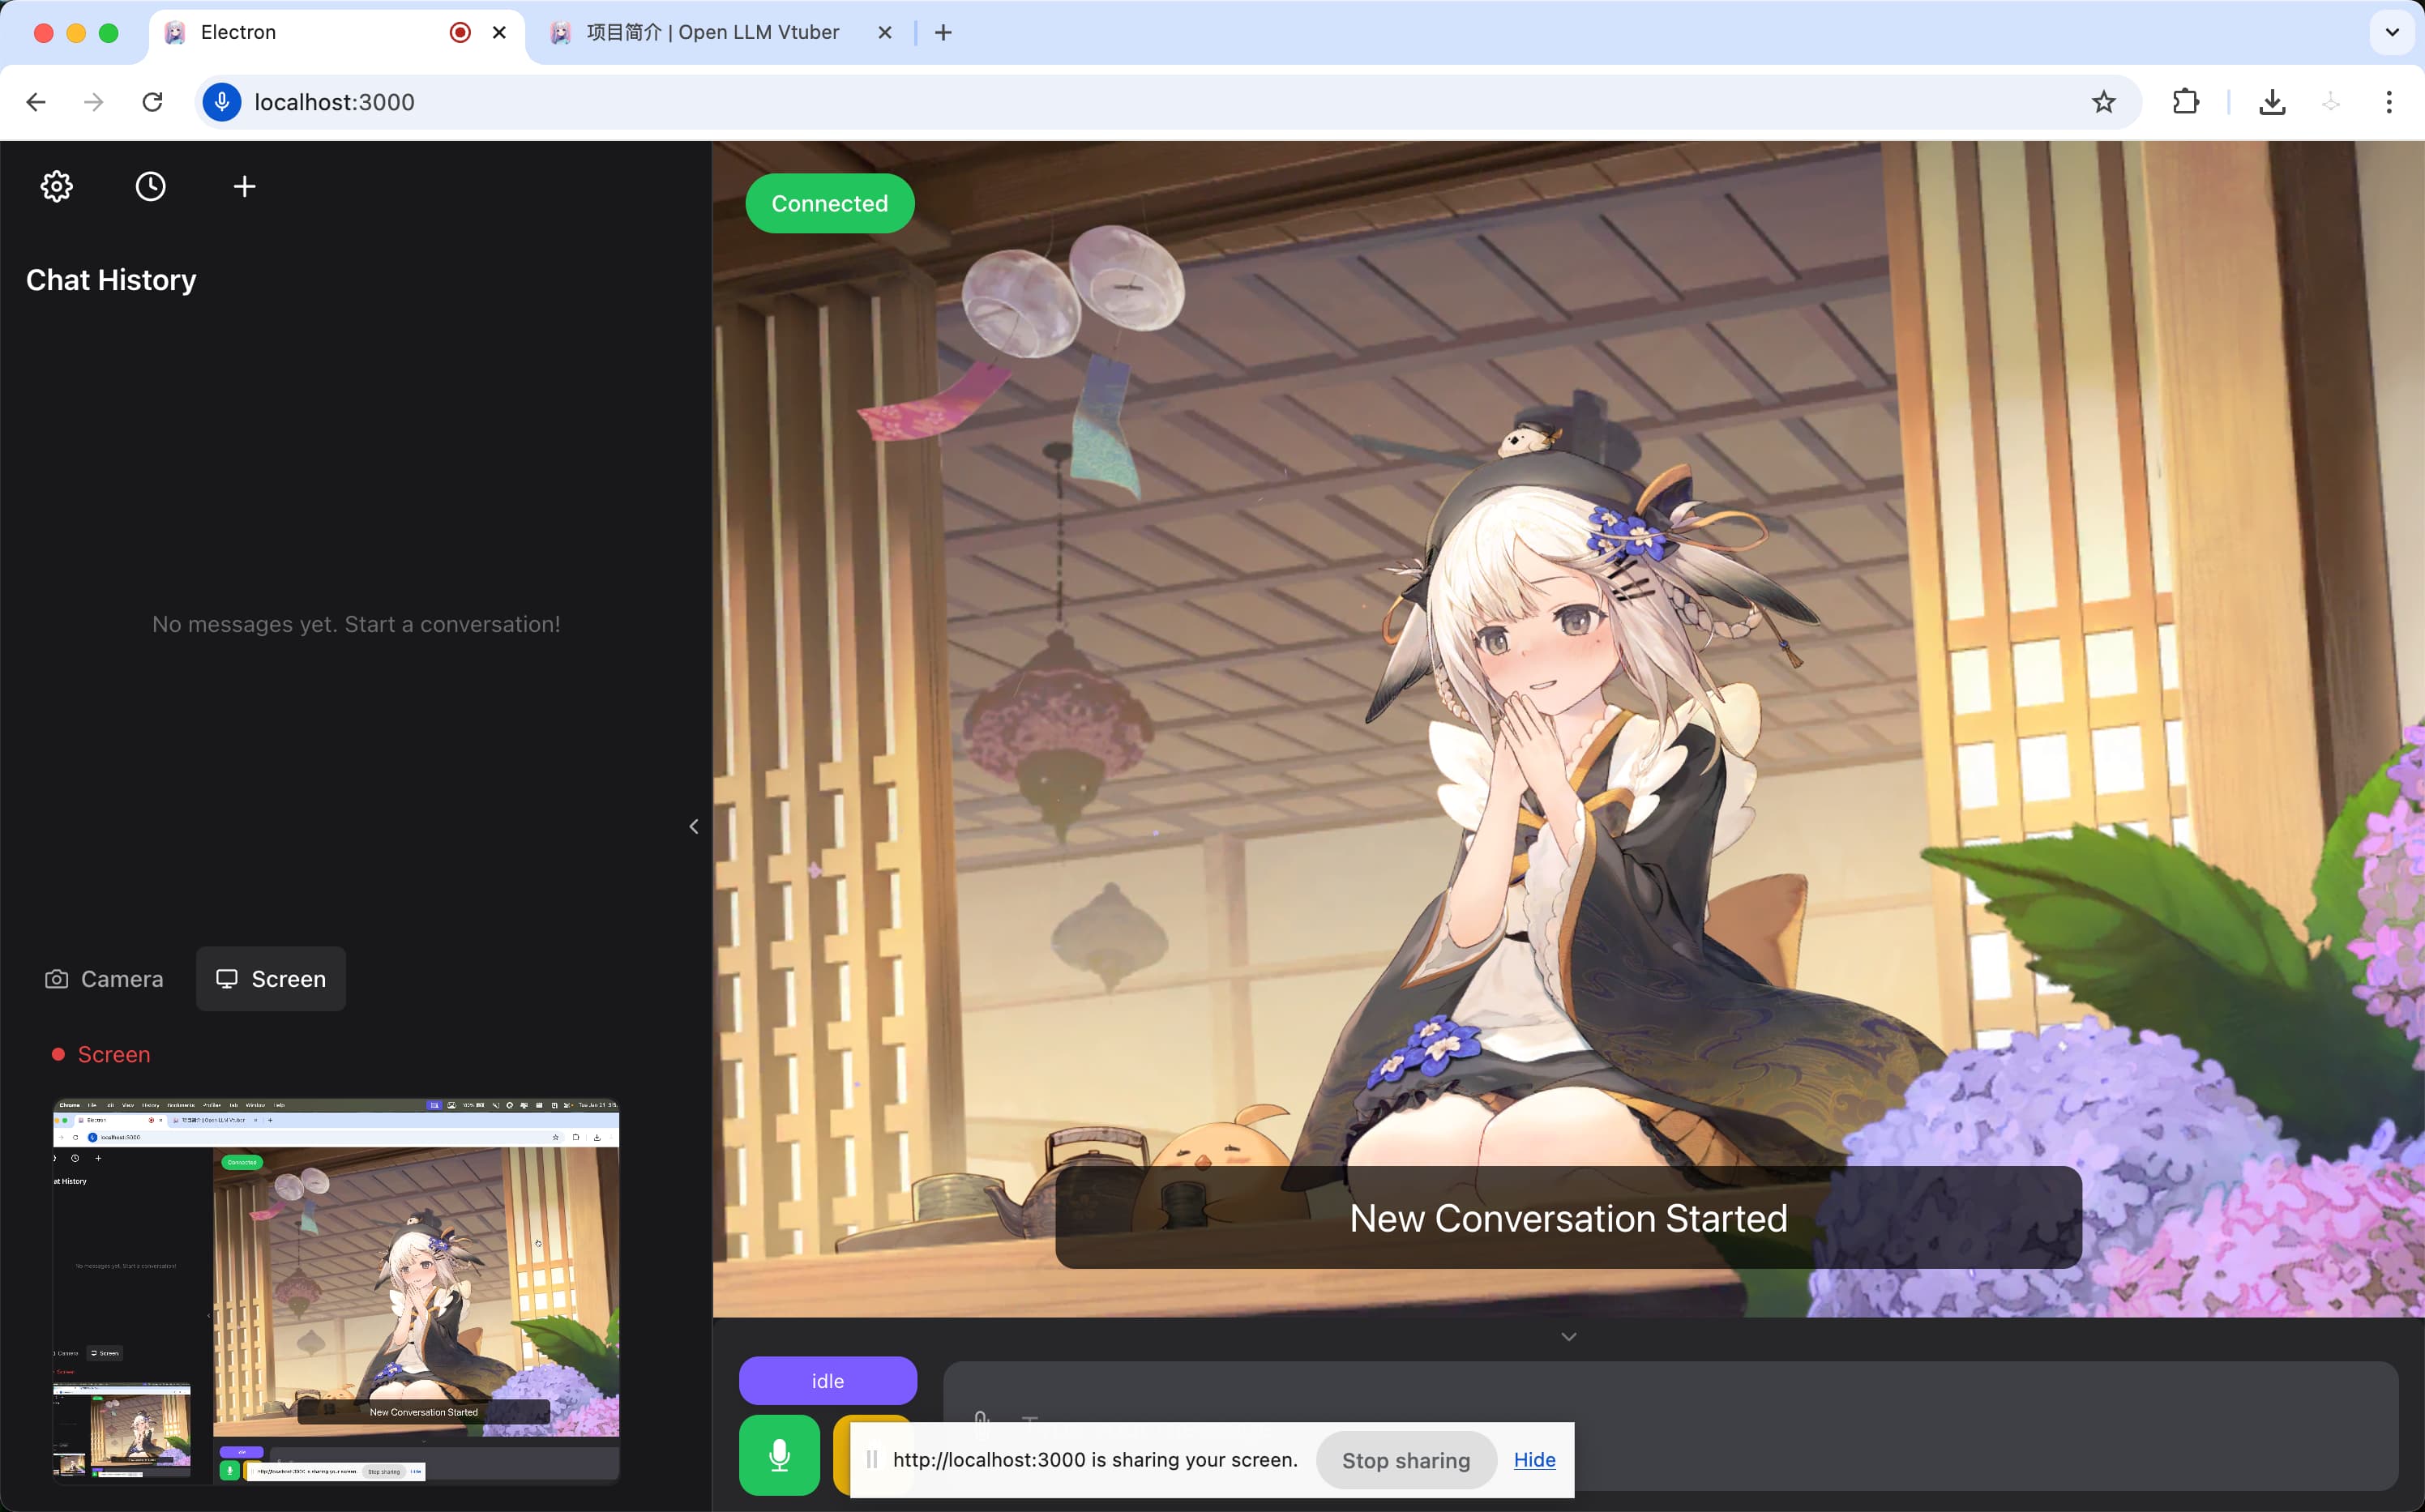 多模态感知:摄像头/屏幕视觉输入。
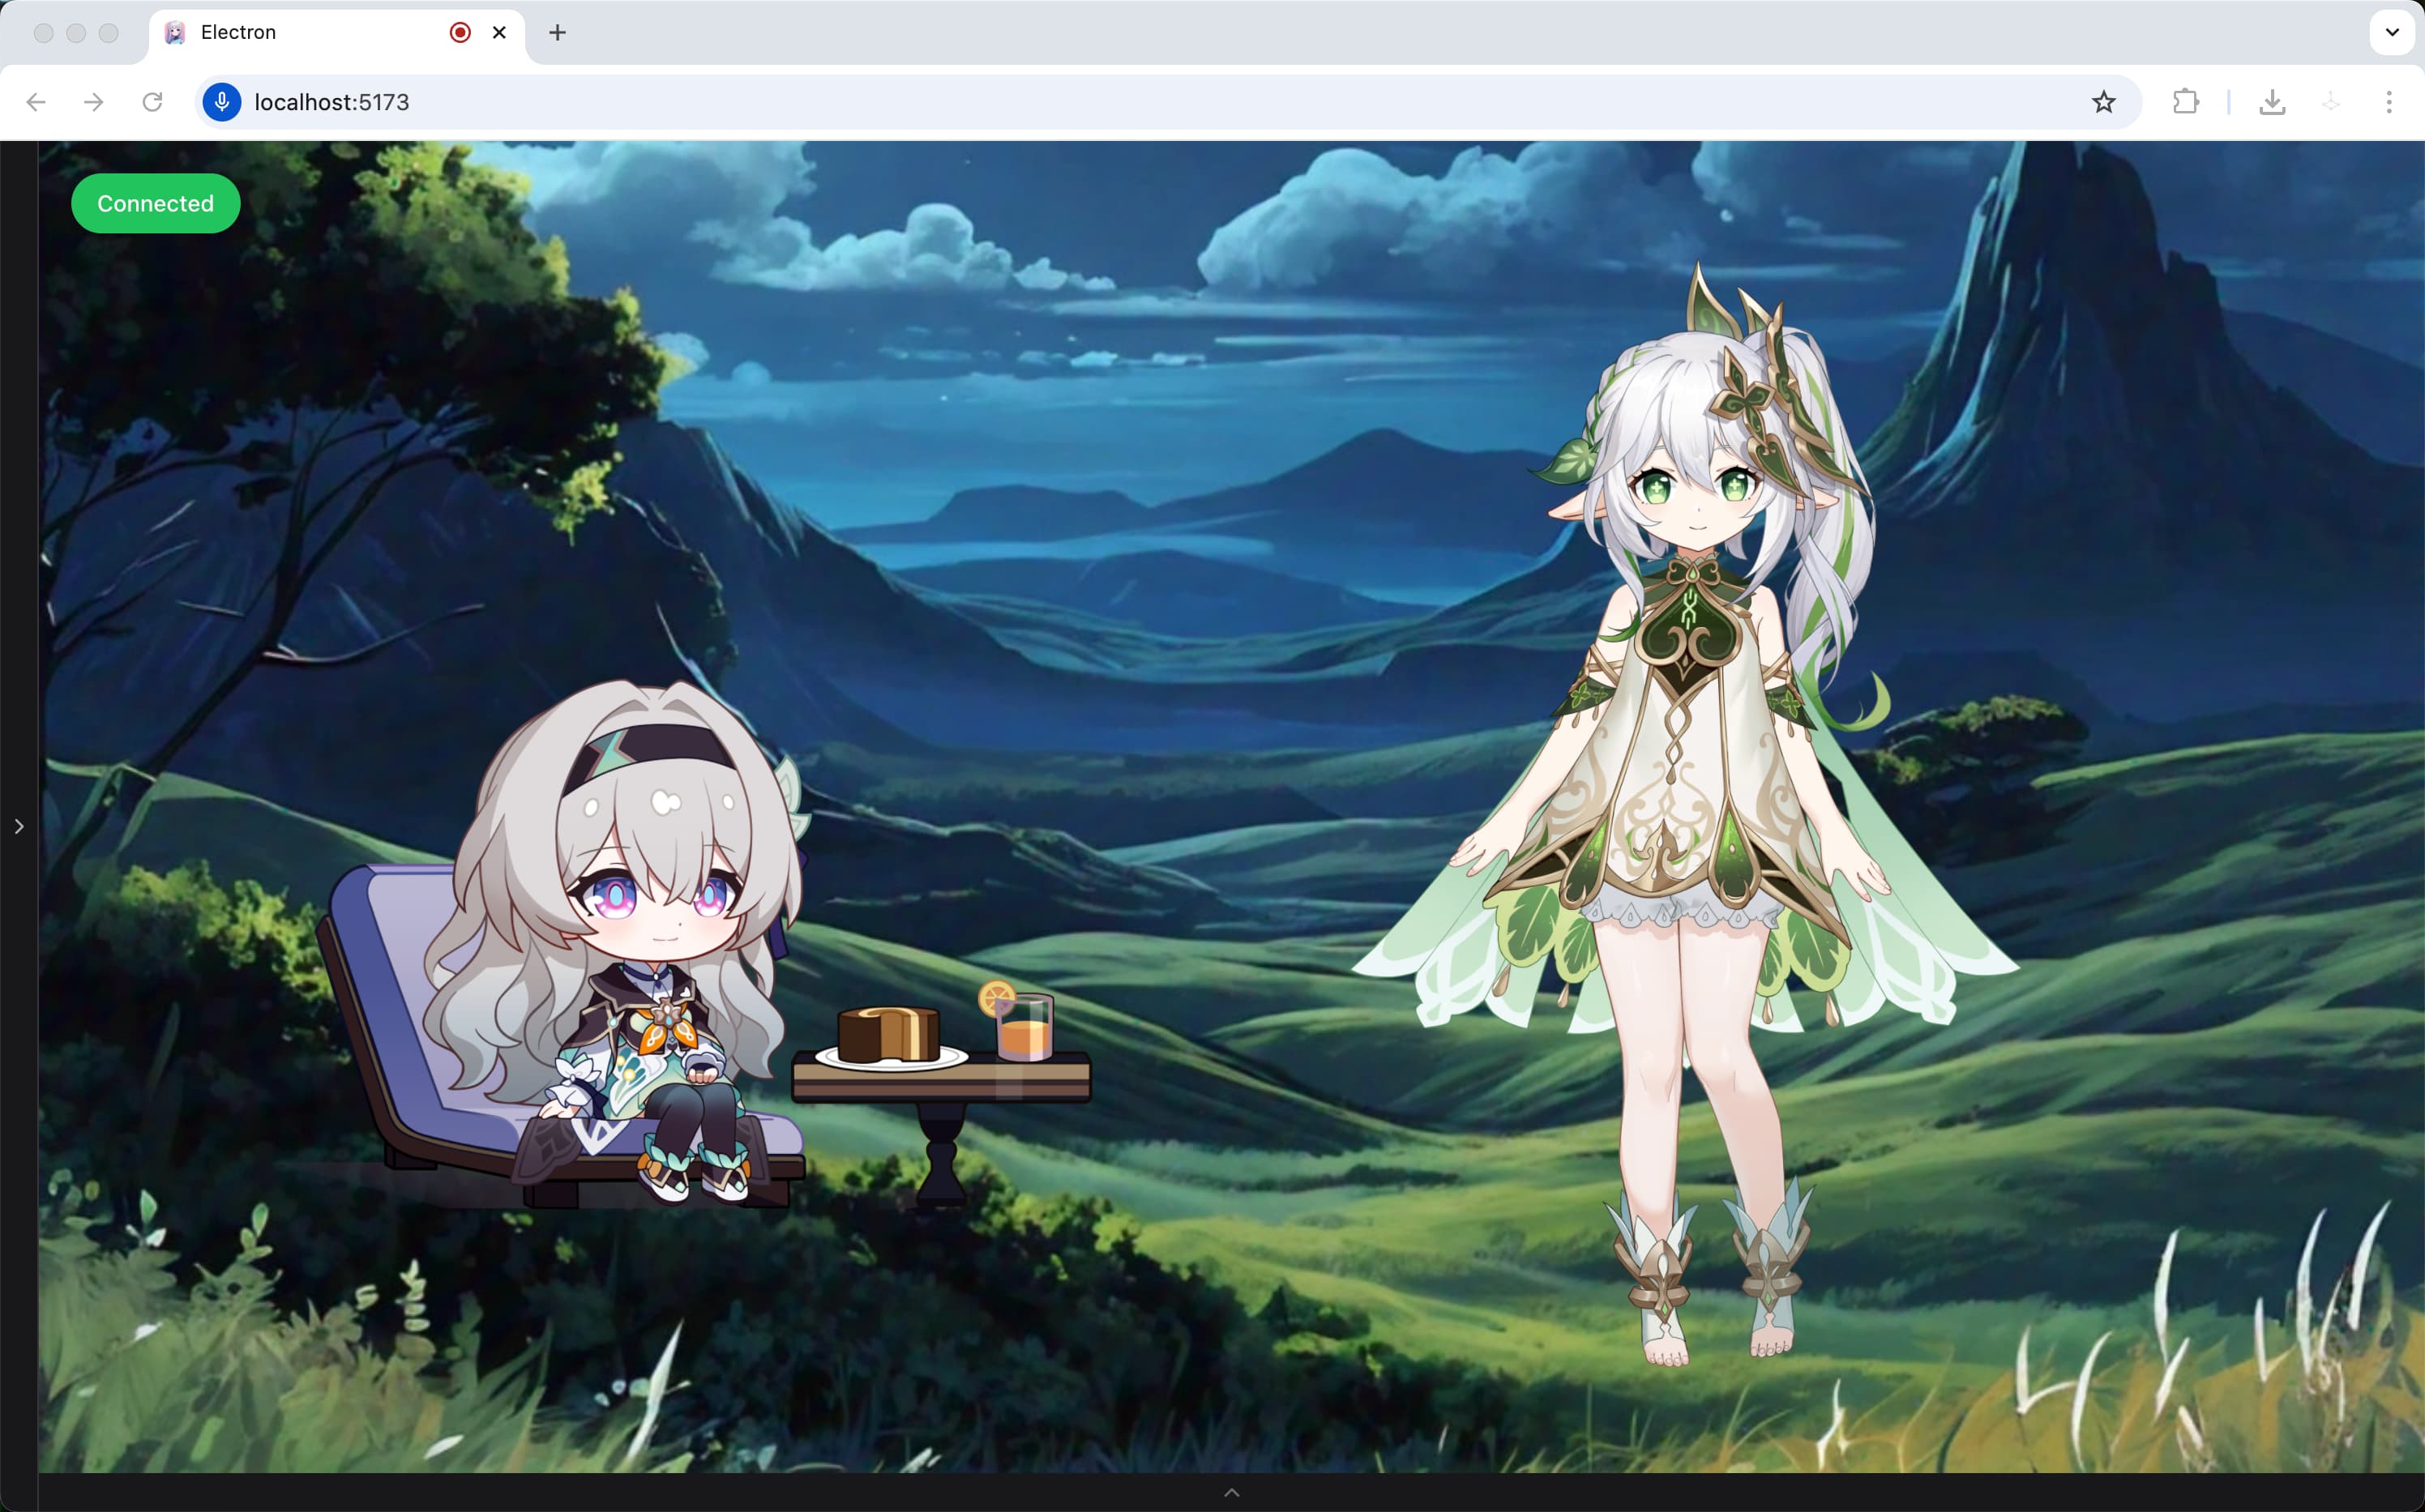 跨平台运行与可插拔后端配置。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/open-llm-vtuber/open-llm-vtuber |
| Star / Fork | 10,394 / 1,222 |
| 代码行数 | 44,877(Python 32.4%/1.45 万行为业务核心,JSON 64.7% 为 Live2D 模型与配置数据资产,JS/YAML 等其余 < 3%) |
| 项目年龄 | 30.5 个月(首次提交 2023-11) |
| 开发阶段 | 低维护(近 90 天仅 1 commit,主体功能已定型) |
| 贡献模式 | 单核心开发者主导(主作者 t41372 占 69.5%/约 576 commits,共 35 名贡献者) |
| 热度定位 | 大众热门(赛道头部,star 仍高速流入) |
| 质量评级 | 代码[良] 文档[优] 测试[无] |
作者视角:为什么存在这个项目
创始人/作者背景
项目由开发者 t41372(Yi-Ting Chiu,按姓名推断为华语/台湾开发者) 主导,从个人项目孵化升格为 GitHub 组织 Open-LLM-VTuber 托管。作者贡献占比约 70%,并围绕主仓搭出了完整生态矩阵:独立的 Web 前端仓、Electron 桌面端仓、文档站(docs.llmvtuber.com)、Docker 配置、Zulip 开发者社区。这种「单核心 + 组织化运作」的形态,决定了项目的设计基因——一个人能维护,就必须极度模块化、极度依赖配置而非硬编码。
问题判断
作者看到的是一个具体的空白:闭源的 Neuro-sama 火爆,但不可自托管、不保护隐私、且基本绑定 Windows。README 里明确写到,命名为「Open-LLM-VTuber」而非「Companion」或「Waifu」,正是因为初衷就是「在 Windows 之外的平台、用可离线的开源方案重建 Neuro-sama」。时机也恰到好处:2024–2025 年开源 LLM、ASR(sherpa-onnx)、TTS(GPT-SoVITS、Edge-TTS)同时成熟,本地推理刚好够跑实时语音,MCP 协议又刚出现——天时齐备。
解法哲学
可以概括为「大而全的后端 + 极致解耦的中间层 + 对非程序员友好的配置面」:
- 可插拔压倒一切:宁可维护成本爆炸,也要支持 22 个 TTS、8 个 ASR、多家 LLM,让用户按硬件自由选型。
- 易用 > 性能:配置文件即 API,普通用户改 YAML 就能换引擎,无需碰代码。
- 明确不做的事:不自研模型、不做前端(前端/桌面端是独立仓库)、长期记忆宁可暂时移除也不凑合(README 坦承「temporarily removed」)。
战略意图
这是一个定位清晰的「集成层/编排器」——本身不造模型也不造 UI,而是连接 LLM 生态与 Live2D 表现层的中间件,野心是做「AI 伴侣界的操作系统/编排框架」。采用 MIT 协议、无 open-core 阉割,靠 BuyMeACoffee/爱发电支持,是 genuinely open 的纯开源而非商业化前置。目前正在重写 v2.0。
核心价值提炼
创新之处
按「新颖度 × 实用性」排序:
- 流式装饰器多模态管线(新颖 4 / 实用 5 / 可迁移 5):用异步生成器装饰器链
tts_filter(display_processor(actions_extractor(sentence_divider(raw_stream)))),把 LLM 的 token 流逐级变换为「显示文本 + 送 TTS 文本 + Live2D 表情动作」的结构化输出,工具调用状态 dict 全程穿透。每级单一职责、声明式、可插拔。 - 工具调用运行时降级(native → prompt)(新颖 4 / 实用 4 / 可迁移 4):不同 LLM 工具调用格式不一、很多本地端点根本不支持原生 tools;当 API 返回不支持时抛出哨兵字符串
__API_NOT_SUPPORT_TOOLS__,Agent 捕获后切到 Prompt 模式——把工具描述塞进 system prompt,并用流式 JSON 探测器在 token 流里实时抽取工具调用。 - 流式 JSON 增量探测器(StreamJSONDetector)(新颖 4 / 实用 4 / 可迁移 4):在 token 流中跟踪
{位置、增量尝试解析、记录已处理区间,边流边抽出完整 JSON 对象。 - 并发生成 + 序号重排交付(TTSTaskManager)(新颖 3 / 实用 5 / 可迁移 4):每句分配自增序号、并发合成、由专职 sender 任务用重排缓冲按句子顺序经 WebSocket 下发,吞吐与顺序兼得。
- 「更快首句响应」+ 标签感知流式分句(新颖 3 / 实用 5):首句在逗号处提前切分以更早启动 TTS,配合 pysbd 多语言分句、
<think>标签栈处理,优化语音 AI 的感知延迟。 - 带内表情标记驱动 Live2D(新颖 3 / 实用 4):在 system prompt 注入 emo_map 关键字,让 LLM 文本里写
[joy]/[anger],再解析出表情索引并从 TTS 文本剥离——用提示工程 + 字符串解析低成本驱动虚拟形象,无需独立情感模型。
可复用的模式与技巧
- Interface + Factory + 惰性导入:多后端按需加载、零冗余依赖、实现门槛极低——任何「可插拔多实现」子系统的范本。
- 生成器装饰器链做流式变换:每级单一职责、逐级富化类型、异类消息穿透。
- 序号重排缓冲(concurrent-but-ordered):自增序号 + 缓冲字典 + 专职 sender,适用并发处理但需有序输出的 async 场景。
- 运行时能力探测 + 哨兵降级:用特殊返回值触发 feature 优雅降级,适用对接不可控外部服务。
- 两层 Stateless/Stateful 抽象:纯推理(StatelessLLM)与编排(Agent)解耦,使裸模型与外部 Agent 平台(Letta、HumeAI EVI)同接口接入。
- 配置即 API:Pydantic + i18n 双语描述 +
${ENV}替换 + 多编码探测 + 跨版本迁移,把配置文件当用户数据来建模与保全。
关键设计决策
- 每个模态统一 Interface + Factory + 惰性导入:工厂用字符串→类分发,
import写在分支内部(被选中才加载),换来支持 22 个后端却零额外依赖加载。Trade-off:工厂是巨型 if-elif,加引擎要改工厂。可迁移性高。 - StatelessLLM 与 Agent 两层抽象分离:
StatelessLLMInterface只负责无状态chat_completion,AgentInterface在其上叠加记忆/system prompt/工具/打断处理;BasicMemoryAgent用前者组合出状态,而 Letta/Hume 直接实现后者绕过它。可迁移性高。 - 会话级 ServiceContext + 共享重组件 by-reference:启动建模板 context,新连接按引用复用 MCP ServerRegistry 等重组件、只新建会话私有部分,并支持
deep_merge热切换人设。换来低开销的多会话 + 运行时换角色。
竞品格局与定位
竞品对比矩阵
| 维度 | Open-LLM-VTuber | my-neuro | AI-Waifu-Vtuber | Soul-of-Waifu | Amica |
|---|---|---|---|---|---|
| Star 量级 | ~10.4k | ~1.3k | ~1.1k | ~719 | 中等 |
| 核心定位 | 通用编排平台 | 极速单体方案 | 直播 AI VTuber | 沉浸角色扮演 | 3D 角色对话 |
| 后端可插拔广度 | 极广(22 TTS/8 ASR/多 LLM) | 聚焦 | 较窄 | 中 | 中 |
| 形态 | Live2D + 桌宠 + Web/桌面双端 | 桌面 | 直播推流 | Live2D/VRM 双形态 | 3D/VRM |
| 本地离线/隐私 | 强(可完全离线) | 强 | 弱(偏云) | 强 | 中 |
| 独特卖点 | 生态完整 + 工程深度 | 1 秒应答 + 语音克隆 + 可训练 | 直播弹幕集成 | 双形态沉浸 | 3D 空间感 |
差异化护城河
护城河来自「集成深度 + 生态」而非单点算法:①后端可插拔的广度断层领先,用户能按任意硬件/预算组合;②流式实时管线 + 并发有序 TTS 的工程深度;③围绕单仓建起的生态矩阵(Web/Electron/文档站/Docker/MCP/插件)+ 10k+ star 的社区网络效应。这些是小项目难以快速复制的。
竞争风险
- 强单点依赖:核心逻辑约 70% 由单一开发者贡献,bus factor 低。
- 零自动化测试:22 个 TTS / 多后端组合的回归风险随增长放大(Issue #24 网页麦克风无响应、#27 ASGI 异常即部署期稳定性坑)。
- 长期记忆被暂时移除,而竞品 my-neuro 正以记忆为卖点。
- v2.0 全量重写本身是风险窗口期。
生态定位
不与竞品拼单点(极速/克隆/直播/3D),而是占据「开源 AI 伴侣的通用编排层/平台」生态位——做别人方案的上游底座。
套利机会分析
- 信息差:项目本身已是赛道公认头部,认知红利已被充分定价,不属于被低估的项目。真正的信息差在「实现细节」——它的流式管线、运行时降级、并发有序 TTS 等工程模式知名度远低于项目本身,对做语音 AI / Agent 框架的人是高价值素材库。
- 技术借鉴:流式装饰器管线、TTSTaskManager 的序号重排、工具调用哨兵降级、配置即 API,可直接迁移到任何流式 LLM 输出 / 多后端 Agent 系统。
- 生态位:填补了「开源、可离线、跨平台、后端自由组合的 AI 伴侣编排层」空白。
- 趋势判断:人气仍在强劲增长且符合「本地 AI + 陪伴」趋势,但当前开发已放缓,处在「等 v2.0」的观望期;后发竞品若在记忆/延迟上做深,存在被局部超越的窗口。
风险与不足
- 测试是与 10k star 体量极不匹配的硬伤:零测试文件、无 CI 测试 job,多后端组合的正确性只能靠社区 issue 兜底。
- 可维护性集中风险:核心由单人主导,若作者投入下降,项目推进高度承压。
- 注释率偏低(7.8%):对一个面向社区二次开发的项目略显单薄,可读性更依赖结构与文档。
- 工厂为巨型 if-elif 而非注册表:每加一个后端都要改工厂文件,规模继续膨胀时维护性下降。
- Live2D 商用模型授权风险:项目已单列第三方许可提醒,使用者需自行注意样例模型的商用边界。
行动建议
- 如果你要用它:想要一个可本地离线、隐私可控、能自由换 LLM/语音引擎的 AI 伴侣或桌宠,且愿意改 YAML 配置——它是当前最完整的选择。若你只要「开箱即用的极速语音克隆伴侣」,my-neuro 更聚焦;若做直播内容,AI-Waifu-Vtuber 的推流集成更顺手。
- 如果你要学它:重点读
src/open_llm_vtuber/conversations/transformers.py(流式装饰器管线)、agent/(StatelessLLM 与 Agent 两层抽象 + 工具调用降级)、TTSTaskManager(并发有序交付)、config_manager/(配置即 API)。这四处是脱离场景也能复用的精华。 - 如果你要 fork 它:最值得补的是自动化测试(哪怕只覆盖工厂分发与流式管线骨架);其次可把巨型工厂改造为注册表式插件机制,降低后端扩展的改动面。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 已收录(40+ 章节系统架构/配置/语音处理/部署,含架构图) |
| Zread.ai | 未确认(直连被 Cloudflare 403 拦截) |
| 关联论文 | 无直接论文;同领域旁证 arXiv:2509.10427《My Favorite Streamer is an LLM》(研究 AI VTuber 粉丝生态,以 Neuro-sama 为对象) |
| 在线 Demo | 无(需本地部署,无官方在线 playground) |
| 官方文档站 | https://docs.llmvtuber.com |