能边听边说的语音 AI:NVIDIA 开源,延迟低 18×
一句话总结
PersonaPlex 是 NVIDIA(ADLR 实验室)开源的实时全双工语音对话模型——它把传统「听写(ASR)→ 理解(LLM)→ 合成(TTS)」的串行流水线坍缩成单个 7B Transformer,能边听边说、随时被打断,并通过「文本角色提示 + 音频声音条件」两路输入定制一致的人格与嗓音;它基于 Kyutai 的 Moshi 架构,是少见的「开源 + 真全双工 + 可控 persona/voice + 可本地跑」组合。
值得关注的理由
- 全双工是体验上的代差:传统语音助手是「你说完→它想→它答」的回合制,有明显延迟和「抢话」尴尬。PersonaPlex 能同时听和说、可被打断、支持重叠语音,论文给出 smooth turn-taking 延迟 0.170s、打断响应 0.240s,宣称比 Gemini Live 低 18×(注:这是特定基准下的 takeover 延迟,非端到端体验全貌)。
- persona/voice 双重可控是它最硬的差异点:用文本 role prompt 定义角色、用一段音频定义声音,语音克隆 speaker similarity 达 0.57,而 Gemini/Qwen/Moshi 近 0——这既是它区别于一切同类开源模型的卖点,也正是双用途风险点(见风险节)。
- NVIDIA 权威 + 开放权重:论文 / 权重(HF nvidia/personaplex-7b-v1)/ Demo 三件套齐备,Bryan Catanzaro(NVIDIA 应用深度学习研究 VP)等署名,5 个月涨近 1 万 star。
项目展示
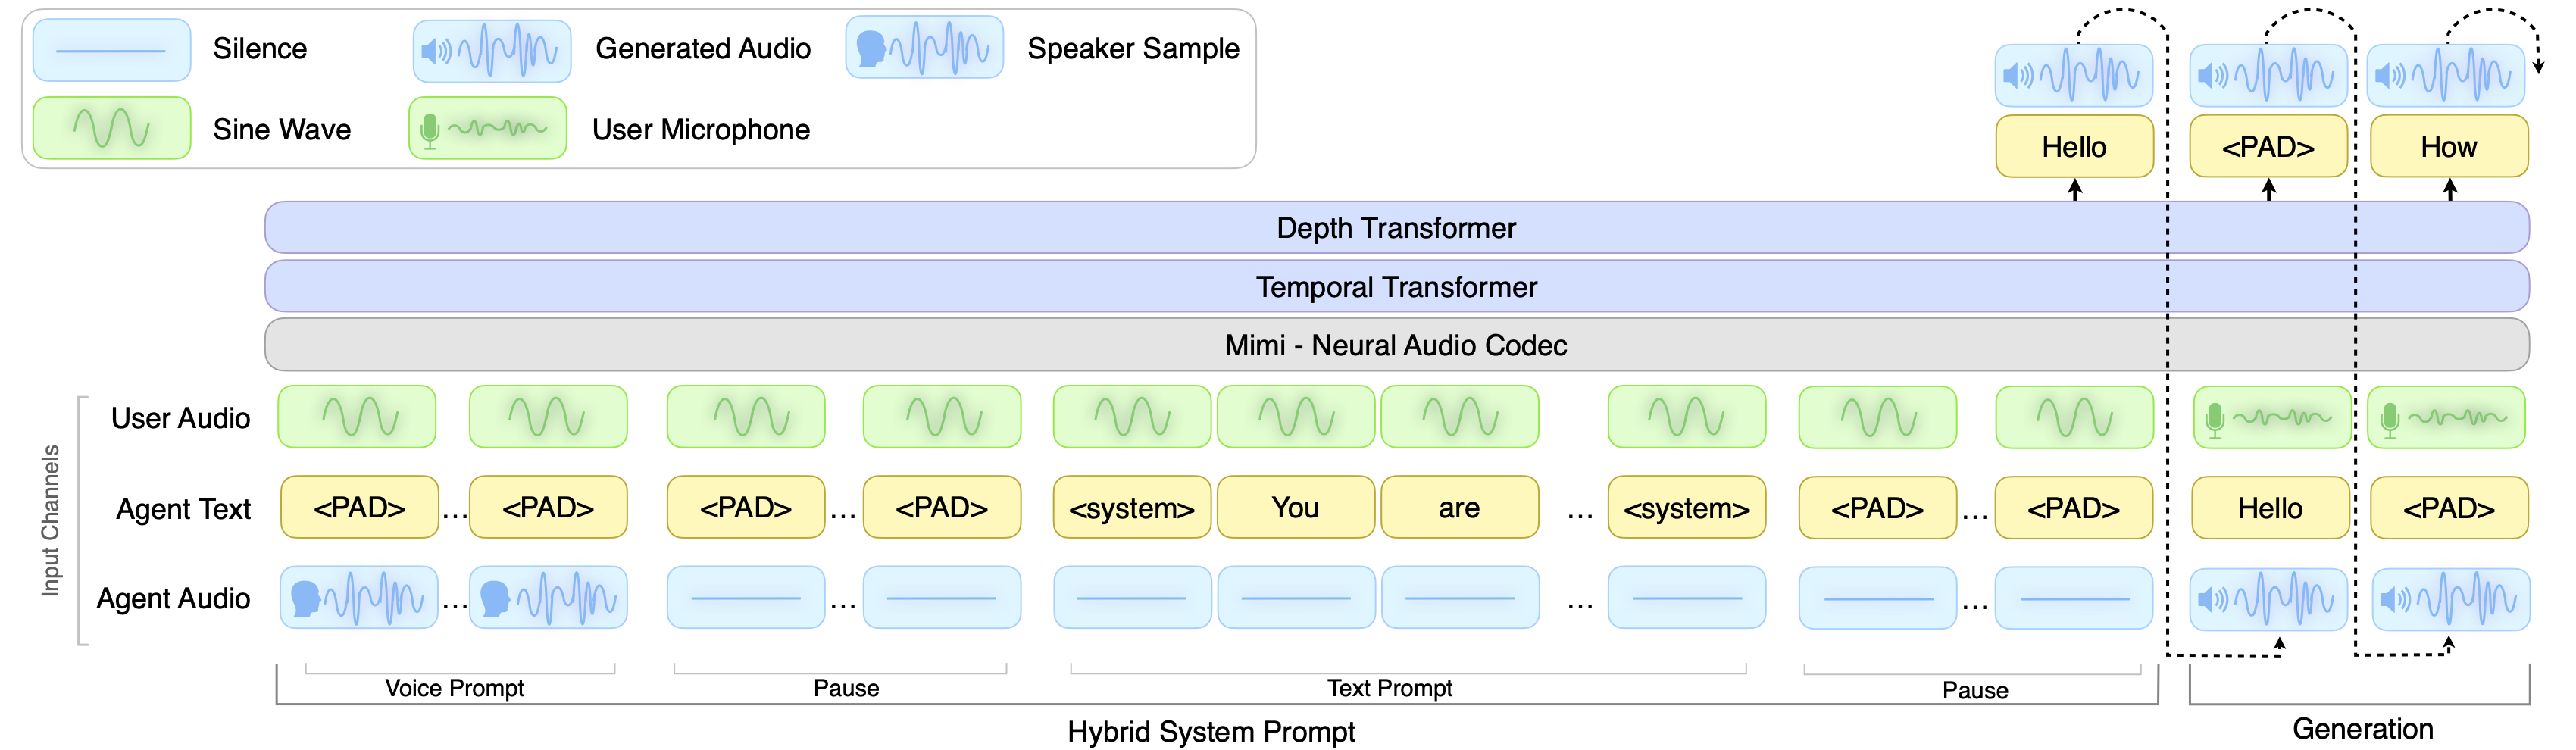
PersonaPlex 架构(单模型双音频流 + 文字「内心独白」对齐,继承自 Moshi)。官方 Demo(含全双工对话演示视频):research.nvidia.com/labs/adlr/personaplex。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/NVIDIA/personaplex |
| Star / Fork | 9969 / 1393(大众热门,发布峰值已过但仍高速涨星) |
| 代码行数 | 16.6K(剔除 lockfile 后约 9.5K 业务代码:Python 推理 5.8K + TS/TSX 前端 2.6K;7B 权重不在仓库、在 HF) |
| 项目年龄 | 4.7 个月(2026-01 发布) |
| 开发阶段 | 低维护(2026-03 后停更,近 90 天 0 commit,研究代码一次性发布模式) |
| 贡献模式 | NVIDIA ADLR 研究团队主导(Rajarshi Roy 占 53%,7 人 + 零星社区) |
| 热度定位 | 大众热门 + 技术稀缺标的(同类开源解读供给少) |
| 质量评级 | 代码[一般·研究薄封装] 文档[良·README+论文+Demo] 测试[无·研究代码常态] |
| License | 代码 MIT;模型权重 NVIDIA Open Model License(可商用,附 Trustworthy AI / 责任使用条款) |
作者视角:为什么存在这个项目
创始人/作者背景
org NVIDIA(26376 followers),出品方是 NVIDIA ADLR(Applied Deep Learning Research)实验室。主作者 Rajarshi Roy(NVIDIA 研究员),论文团队含 Jonathan Raiman、Sang-gil Lee、Jaehyeon Kim,由 Bryan Catanzaro(NVIDIA 应用深度学习研究副总裁) 压阵——典型的「工业研究实验室出品 + 论文/权重/Demo 三件套」开源研究项目,可信度极高。
问题判断
语音 AI 长期受困于「串行流水线」:ASR 听写 → LLM 理解 → TTS 合成,每一段都加延迟,且本质是回合制(你说完它才答),无法像真人那样边听边说、被打断、抢话。OpenAI/Gemini 的实时语音虽强但闭源、不可本地化。Kyutai 的 Moshi 开创了开源全双工,但人格和声音不可控(你无法指定它是谁、用什么嗓音)。PersonaPlex 看到的缺口是:全双工 + 可控人格/声音 + 开源三者从未同时满足。时机上,2026 年实时语音 Agent(客服、助手、NPC)需求爆发,正是把「可定制的实时语音」开源出来抢生态的窗口。
解法哲学
- 明确选择单模型全双工而非串行流水线:一个 7B Transformer 同时处理「自己说 + 用户说」两路音频流 + 文字内心独白对齐,消除级联延迟。
- 明确选择站在 Moshi 肩上:复用 Moshi 架构/权重(Helium LLM 骨干 + Mimi 音频 codec),不重造轮子,专注加 persona/voice 可控性。
- 明确选择双路 persona 控制:用 Hybrid System Prompt 把「角色」(文本)和「声音」(音频)解耦为两路条件。
- 明确选择开放权重 + 可商用许可:代码 MIT、权重 NVIDIA Open Model License,降低采用门槛。
- 明确选择研究 drop 形态:一次性发布推理代码 + web 客户端 + Docker,之后不持续维护。
战略意图
对 NVIDIA 而言,开源前沿语音模型是「卖铲子」战略的一环——开放权重能跑在 NVIDIA GPU 上(issues 显示对显存/硬件强绑定),既树立 AI 研究品牌,又拉动自家硬件需求。它不追求产品化维护,而是用论文 + 权重 + Demo 树立「开源全双工 + 可控 persona」的技术标杆,把生态留给社区(已有 Apple Silicon MLX 移植等)。
核心价值提炼
创新之处
- 全双工 + 可控 persona/voice 的开源实现(最值得关注):开源 × 真全双工 × 文本角色+音频声音双重控制 × 7B 可本地跑——这个四交集目前几乎只有 PersonaPlex。
- 音频声音条件(voice conditioning):给一段参考音频,模型就能用那个声音对话,speaker similarity 0.57 远高于同类(≈0)——这是它最硬的技术区分点。
- 单模型双音频流 + 文字内心独白对齐:继承自 Moshi 的核心机制,增量编码用户音频的同时流式生成输出,消除级联延迟。
- ServiceDuplexBench:论文配套提出的客服场景全双工基准(FullDuplexBench 扩展),推动该方向评测标准化。
可复用的模式与技巧
- 研究模型发布范式:权重在 HF + GitHub 提供「推理/流式服务/客户端」薄封装 + Docker 一键复现——任何要开源大模型的团队都可照搬。
- 浏览器实时语音全链路:client/ 的「opus-recorder 麦克风采集 → ws WebSocket 流 → 低延迟音频播放/解码」是 Web 端实时语音 UI 的实用样本。
- 解耦的条件控制:把「角色」和「声音」拆成两路独立条件,是可控生成的通用思路。
- 站在开源基座上做增量:fork 成熟框架(Moshi)+ 自有训练数据 + 新能力,而非从零。
关键设计决策
- 坍缩流水线为单模型:换来全双工与低延迟,代价是训练难、精度/稳定性仍打折(独立报道指出)。
- 权重在 HF、代码做薄封装:仓库仅 1.3MB,价值在权重与方法;但也意味着 GitHub 端 bug/硬件适配少有官方修复。
- 英语单语 + 数据中心 GPU 取向:漂亮的延迟数字依赖高端 GPU,消费级显卡撞 VRAM 墙(见风险)。
竞品格局与定位
竞品对比矩阵
| 维度 | PersonaPlex | Moshi (Kyutai) | OpenAI Realtime/GPT-4o | Sesame CSM |
|---|---|---|---|---|
| 开源 | ✓(权重 NVIDIA OML) | ✓ | ✗ 闭源 API | ✓ |
| 真全双工 | ✓ | ✓(首创) | ✓ | ✗(需外接 LLM) |
| persona/voice 可控 | ✓ 双路控制 | ✗(相似度≈0) | 部分(预设音色) | 表现力强 |
| 本地可跑 | ✓ 7B(需较强 GPU) | ✓(Mac/MLX 可跑) | ✗ | ✓ |
| 质量 | 研究级 | 研究级 | 最强(Big Bench Audio 96.6%) | 表现力导向 |
差异化护城河
护城河 =「开源 + 真全双工 + 文本角色+音频声音双重 persona 控制 + 7B 可本地跑 + NVIDIA 背书」的独特交集,以及 voice conditioning 的高保真克隆能力(0.57 vs ≈0)。但它向上撞 OpenAI/Gemini 的闭源质量墙,向下与 Moshi 共享同一根基。
竞争风险
- 夹在母体与闭源墙之间:技术根基是 Moshi(开源同类),质量上限被 OpenAI/Gemini 闭源前沿压制。
- 低维护 = 长期落后风险:发布即停更,bug/硬件/多语言问题靠社区,难追前沿迭代。
- 硬件门槛劝退:7B 全双工对消费级显卡不友好,VRAM 墙是普及核心痛点。
- 能力本质的双用途争议:高保真语音克隆易被滥用,可能招致平台/监管限制。
生态定位
它是「开源全双工 + 可控 persona/voice」这一细分蓝海的近乎独占者,填补了 Moshi(不可控人格)与闭源实时语音(OpenAI/Gemini)之间的空白,是开源实时语音 AI 的技术标杆与研究起点。
套利机会分析
- 信息差:非被低估(已大众热门),但「可深度解读的同类开源稀缺」——全双工 + 语音克隆 + 双用途三重内容钩子,技术科普价值高。
- 技术借鉴:「研究模型发布范式(权重 HF + 薄封装)」「浏览器实时语音全链路」「解耦条件控制」「站在开源基座做增量」可迁移。
- 生态位:做实时语音 Agent/客服/NPC、想要可定制人格声音又要开源可本地的团队,这是当前最佳起点(注意硬件门槛与合规)。
- 趋势判断:实时语音 Agent 是 2026 明确上升方向,PersonaPlex 占据开源标杆位;但低维护、硬件门槛、与闭源前沿的质量差是需观察的变量。
风险与不足
- ⚠️ 语音克隆的双用途与合规(最需正视):audio-based voice conditioning 本质是「给一段音频就能用该嗓音说话」的语音克隆能力(相似度 0.57,远高于同类)。合法用途:自定义语音助手、无障碍、游戏 NPC、客服、内容创作、研究;滥用风险:未经同意的语音冒充、电话诈骗、deepfake,涉隐私/同意/各地声音肖像权法律。使用他人声音必须获得本人同意;权重侧的 NVIDIA Open Model License 附责任使用条款。本报告不提供任何冒充/绕过的实现细节。
- 硬件/VRAM 墙:7B 全双工对消费级显卡不友好,连 NVIDIA 自家 DGX Spark(GB10) 都有音频卡顿(issue #3,57 评论未解);社区在自发做量化/低显存(#10/#55 悬而未决)。
- 仅英语 + 低维护:当前仅英语,官方未承诺多语言/量化/Mac/Windows 支持,发布后基本停更,问题靠社区。
- 质量未及闭源前沿:全双工训练难,精度/稳定性仍打折扣。
行动建议
- 如果你要用它:你在做实时语音 Agent/客服/NPC、需要可定制人格与声音、且要开源可本地部署、手握较强 NVIDIA GPU——它是当前最佳开源起点(
pip install moshi/.+ Docker 跑 demo,权重从 HF 拉)。务必确保所用声音已获本人同意、合规使用。要最强对话质量选 OpenAI Realtime/Gemini Live(闭源);要 Mac/低配本地跑可看 Moshi 或社区 MLX 移植。 - 如果你要学它:重点读论文(arXiv 2602.06053)理解全双工 + persona/voice 控制方法;代码读
moshi/moshi/models/loaders.py(persona/voice 条件加载)、server.py(实时流式 WebSocket 服务)、client/src(浏览器实时语音全链路)。配合 Moshi 论文理解根基。 - 如果你要 fork/扩展它:最有价值的方向是量化/低显存适配(社区第一痛点)、多语言训练、跨平台移植(Mac/Windows),以及在权限与伦理框架内做领域 persona 定制。
知识入口
| 资源 | 链接 |
|---|---|
| 论文 | PersonaPlex (arXiv:2602.06053) |
| 模型权重 | https://huggingface.co/nvidia/personaplex-7b-v1 (NVIDIA Open Model License) |
| 官方 Demo | https://research.nvidia.com/labs/adlr/personaplex/ (含全双工对话演示视频) |
| 技术根基 | Moshi (Kyutai, arXiv:2410.00037) | kyutai-labs/moshi |
| DeepWiki | https://deepwiki.com/NVIDIA/personaplex |
| 独立报道 | the-decoder: NVIDIA open-sources PersonaPlex |