Milvus 深度分析报告
一句话总结
开源向量数据库赛道的领导者,以存算分离的分布式架构和最丰富的索引类型,为十亿级向量的 AI 应用提供生产级搜索和管理能力。
值得关注的理由
- AI 基础设施核心组件:43k+ Star,向量数据库赛道 Star 数第一,RAG/语义搜索/推荐系统的底层支撑,NVIDIA/Salesforce/eBay 等 10,000+ 企业在生产环境使用
- 工程与学术双重深度:SIGMOD 2021 和 VLDB 2022 顶会论文背书,134 万行代码的大型分布式系统,存算分离 + 微服务 + 流式架构的教科书级实现
- 赛道竞争白热化中的差异化护城河:面对 Qdrant(Rust)、ChromaDB(轻量)、pgvector(SQL 原生) 的多维竞争,Milvus 在扩展性、索引丰富度和企业级特性上建立了明确护城河
项目展示
Milvus — 为 AI 应用构建的高性能向量数据库
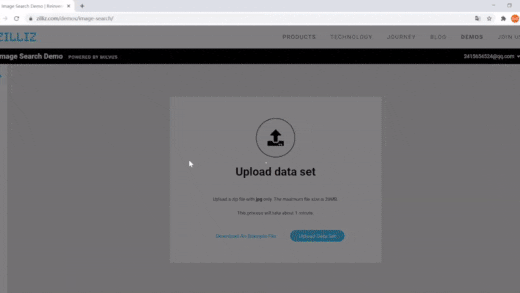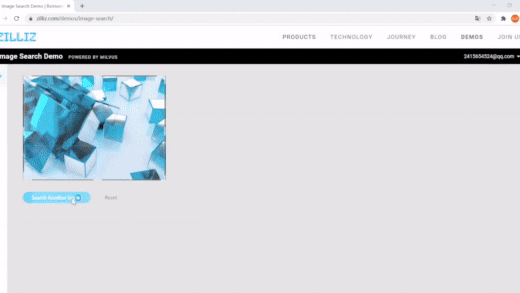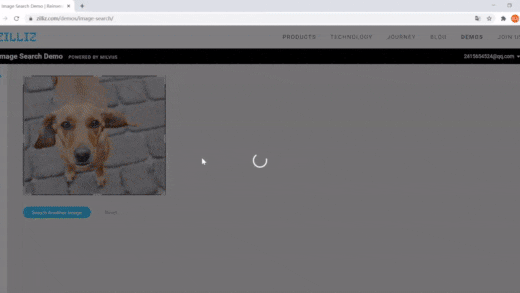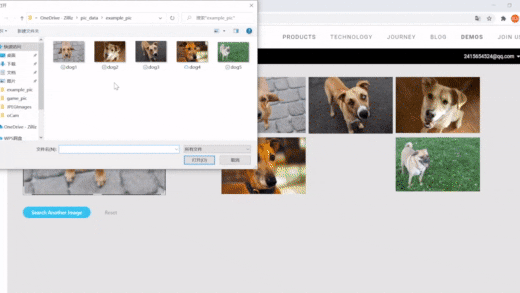 图像相似性搜索 Demo
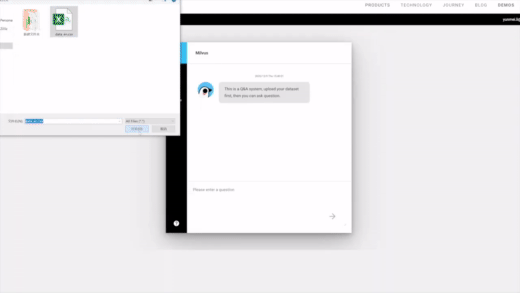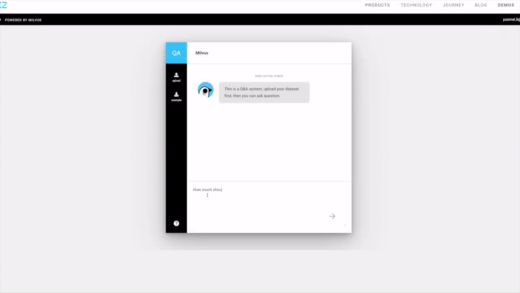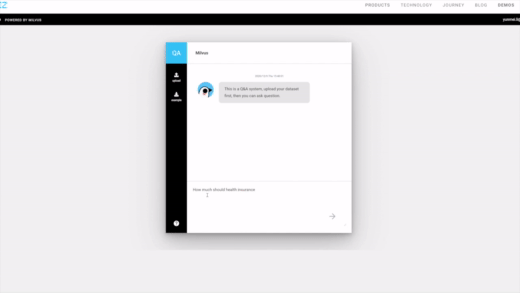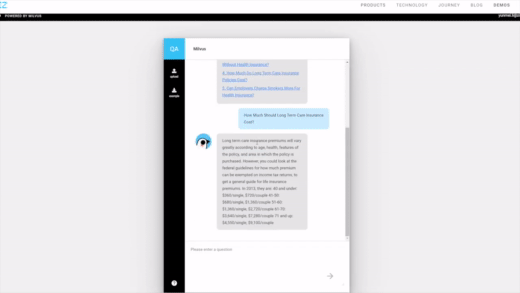 RAG 问答系统 Demo
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/milvus-io/milvus |
| Star / Fork | 43,442 / 3,910 |
| 代码行数 | 1,338,535(Go 66.1%, Python 13.2%, C++ 10.4%) |
| 项目年龄 | 84 个月(首次提交 2019-03-18) |
| 开发阶段 | 密集开发(近 30 天 171 commits,近 90 天 543 commits) |
| 贡献模式 | 企业级社区驱动(Zilliz 主导,432 位贡献者) |
| 热度定位 | 大众热门(向量数据库赛道 Star 数第一) |
| 质量评级 | 代码[优秀] 文档[优秀] 测试[良好] |
作者视角:为什么存在这个项目
创始人/作者背景
Milvus 由 Zilliz 公司创建并主导开发(融资 ~$132M,总部旧金山)。创始团队有深厚的数据库与向量检索学术背景,核心论文发表于 SIGMOD 2021(“Milvus: A Purpose-Built Vector Data Management System”)和 VLDB 2022(“Manu: A Cloud Native Vector Database Management System”)。项目归属 LF AI & Data Foundation,拥有中立治理框架。432 位贡献者中,前 10 名贡献者提交次数在 700-1,684 之间,分布相对均匀,表明有健康的团队协作模式。
问题判断
Zilliz 在 2019 年就意识到,深度学习将非结构化数据转化为向量嵌入(Embedding)正成为主流,但现有技术栈存在根本性缺口:FAISS 等库提供了算法但缺乏数据管理能力(事务、持久化、分布式);传统数据库的 B-tree 索引不适用于高维空间;Elasticsearch 的向量搜索是后加功能。2023-2025 年 RAG/LLM 爆发完美验证了这个判断——向量数据库成为 AI 应用的必备基础设施。
解法哲学
“存算分离 + 微服务 + 流式架构”:
- 选择做:将向量数据库当作分布式流处理系统来构建,存储和计算完全分离(MinIO/S3 + 无状态计算节点),通过 WAL 实现流式数据同步
- 选择不做:不追求”简单上手”(对标 ChromaDB),不走单体路线(对标 Qdrant),不做数据库扩展(对标 pgvector)
- 双语言策略:Go 负责分布式协调(并发模型优势),C++ 负责核心向量搜索(计算性能优势),各取所长
战略意图
开源核心引擎 → LF AI 基金会托管建立信任 → Zilliz Cloud 提供全托管商业服务(Serverless/Dedicated/BYOC)。这是经典的”开源核心 + 云服务”商业模式。2.6+ 版本引入 Woodpecker(自研 WAL,替代 Pulsar/Kafka)和 MixCoord(协调器合并),标志着从依赖外部组件向自包含架构演进,降低部署复杂度的同时巩固技术护城河。
核心价值提炼
创新之处
-
Woodpecker 自研 WAL(新颖度 4/5,实用性 5/5,可迁移性 3/5) 基于对象存储(S3/MinIO)的写前日志,消除了对 Pulsar/Kafka 的强依赖,大幅简化部署
-
流式时间同步机制(新颖度 4/5,实用性 4/5,可迁移性 3/5) 通过 Guarantee Timestamp 实现 WAL、binlog、索引三种数据形态的一致性快照,支持”在时间 T 执行搜索”的语义
-
混合搜索(Dense + Sparse + Full-text)(新颖度 3/5,实用性 5/5,可迁移性 4/5) 同一 Collection 中同时存储稠密向量、稀疏向量和 BM25 全文索引,支持多路召回 + 重排
-
GPU 加速索引(CAGRA 集成)(新颖度 3/5,实用性 4/5,可迁移性 2/5) 通过 NVIDIA cuVS 库支持 GPU 索引构建和搜索,面向超大规模场景
-
Partition Key 多租户(新颖度 3/5,实用性 5/5,可迁移性 4/5) 数据库/Collection/Partition/Partition Key 四级隔离,单集群可处理百万级租户
可复用的模式与技巧
- Coordinator-Worker 分离模式:Coordinator 管元数据和调度,Worker 无状态执行——适用于任何需要水平扩展的分布式系统
- MQ 抽象层 + 多后端模式:统一消息队列接口支持 Pulsar/Kafka/RocksMQ/Woodpecker——降低基础设施锁定
- CGO 双语言桥接模式:Go 处理分布式逻辑 + C++ 处理计算密集内核——适用于兼顾分布式和极致性能的系统
- 微服务先拆后合(MixCoord):先按职责拆分保持清晰边界,成熟后合并减少通信开销——经典架构演进模式
- Segment 不可变 + Compaction:数据以不可变 Segment 写入,后台异步合并压缩——类似 LSM-Tree 思路
- 元数据存储抽象(etcd/tikv):MetaKv 接口抽象,etcd 适合小规模,tikv 适合大规模
关键设计决策
| 决策 | Trade-off |
|---|---|
| 存算分离架构 | 架构复杂度高(多组件依赖),换来独立扩缩容和故障隔离 |
| Go + C++ 双语言 | CGO 调用有开销且调试困难,但各取所长(并发 + 性能) |
| MixCoord 协调器合并 | 单点风险增加,但简化部署和降低跨服务延迟 |
| 可插拔索引引擎 Knowhere | 通用抽象难以极致优化每种索引,但获得了灵活性(11+ 索引类型) |
| 列式 Segment 存储 | 不利于行级操作,但利于 SIMD 和压缩,Segment 不可变简化并发 |
竞品格局与定位
竞品对比矩阵
| 维度 | Milvus | Qdrant | ChromaDB | Weaviate | pgvector |
|---|---|---|---|---|---|
| Star | 43,442 | 29,759 | 26,757 | 15,849 | ~12,000 |
| 语言 | Go + C++ | Rust | Python + Rust | Go | C |
| 架构 | 存算分离/微服务 | 单体/Raft 集群 | 嵌入式/单机 | 分片复制 | PG 扩展 |
| 向量规模 | 十亿级 | 百万~十亿级 | 百万级 | 亿级 | 百万级 |
| 索引类型 | 11+ 种 | HNSW 为主 | HNSW | HNSW | IVFFlat/HNSW |
| 运维复杂度 | 高 | 低 | 极低 | 中 | 极低 |
| 商业化 | Zilliz Cloud ($132M) | Qdrant Cloud | Chroma Cloud | Weaviate Cloud | 各 PG 云 |
差异化护城河
- 扩展性护城河:存算分离架构是唯一真正支持十亿级向量独立弹性扩缩的开源方案
- 索引深度护城河:Knowhere C++ 引擎集成 11+ 种索引(含 GPU 加速),竞品难以短期追平
- 生态护城河:LangChain/LlamaIndex/OpenAI 等深度集成 + LF AI 基金会中立治理
- 商业化护城河:Zilliz 融资 $132M,NVIDIA/Salesforce/eBay 等企业客户基础
竞争风险
- Qdrant 以 Rust 高性能 + 简洁运维蚕食中高端市场,增速最快
- pgvector 以零迁移成本切入已有 PostgreSQL 用户,Elastic CEO 公开称”向量数据库不是独立业务”
- Pinecone 虽闭源但纯托管零运维体验好,不过正面临收购传闻($750M 估值)
- 长期看,大型云厂商(AWS/GCP/Azure)可能推出原生向量数据库服务
生态定位
在 AI 基础设施栈中,Milvus 占据”生产级向量存储与检索”核心位置。与 LLM 框架(LangChain/LlamaIndex)、Embedding 服务(OpenAI/HuggingFace)、数据管道(Spark/Kafka)形成上下游互补关系。Milvus Lite 模式是对 ChromaDB 轻量市场的直接回应,试图覆盖从开发到生产的全链路。
套利机会分析
- 信息差: 无,项目已被充分发现(43k Star),赛道本身是 VC 热点
- 技术借鉴: 存算分离架构设计、Coordinator-Worker 模式、MQ 抽象层、CGO 双语言桥接、Segment 管理模式——每一项都是分布式系统设计的优质教材
- 生态位: 向量数据库赛道的”重量级冠军”——功能最全、规模最大、但也最复杂
- 趋势判断: 持续增长,RAG/AI Agent 趋势推动向量数据库成为必备基础设施。Milvus 正从”纯向量数据库”向”全能型 AI 数据库”演进(全文搜索 BM25、聚合查询、RESTful API)
风险与不足
- 部署复杂度高:多组件依赖(etcd + MinIO + MQ),运维门槛远高于 Qdrant/ChromaDB
- 开发者上手门槛:相比 ChromaDB 的
pip install体验,Milvus 的学习曲线陡峭(Milvus Lite 在缓解但功能受限) - CGO 双语言代价:Go-C++ 桥接增加调试难度和构建复杂度,新贡献者门槛高
- 注释偏少:134 万行代码,代码/注释比 9.6:1,对于这种复杂度的系统偏低
- 赛道整合风险:如果传统数据库(PostgreSQL、Elasticsearch)的向量能力持续提升,专用向量数据库的市场空间可能被压缩
- Woodpecker 成熟度:自研 WAL 仍有性能问题(Issue #46067),需要时间验证生产可靠性
行动建议
- 如果你要用它: 十亿级向量 + 需要弹性扩缩 + 企业级特性(RBAC/多租户/CDC)→ 选 Milvus;百万级 + 快速上手 → 选 Qdrant 或 ChromaDB;已有 PostgreSQL → 先试 pgvector。建议从 Milvus Lite 开始原型,生产环境用 K8s 部署或直接上 Zilliz Cloud
- 如果你要学它: 重点关注
internal/proxy/(API 层)、internal/datacoord/(数据调度)、internal/core/src/segcore/(C++ 核心引擎)、pkg/mq/(MQ 抽象层)、docs/目录下的系统设计文档(9 章 + 附录) - 如果你要 fork 它: 可改进方向:(1) 进一步简化单机部署体验;(2) 提升 Woodpecker 性能和稳定性;(3) 增加更多索引算法的 GPU 加速;(4) 改善代码注释覆盖率
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | deepwiki.com/milvus-io/milvus |
| Zread.ai | zread.ai/repo/milvus-io/milvus |
| 关联论文 | Milvus: A Purpose-Built Vector Data Management System(SIGMOD 2021) |
| 关联论文 | Manu: A Cloud Native Vector Database Management System(VLDB 2022) |
| 综述论文 | Survey of Vector Database Management Systems(arXiv) |
| 官方文档 | milvus.io/docs |
| 在线 Demo | milvus.io/milvus-demos |
| Bootcamp | github.com/milvus-io/bootcamp(2,397 Star) |