microsoft/VibeVoice 深度分析报告
一句话总结
Microsoft Research 亚洲研究院出品的全栈语音 AI 框架——通过 7.5 Hz 超低帧率连续语音分词器 + Next-Token Diffusion 架构,统一覆盖 TTS(90 分钟长对话合成)、ASR(60 分钟单次识别+说话人分离)和 Realtime(200ms 首音延迟流式 TTS),7 个月 24K star。
值得关注的理由
- 7.5 Hz 超低帧率是关键突破:比 EnCodec(75 Hz)低 10 倍的连续 VAE 分词器,3200:1 压缩比使同等上下文窗口可处理 10 倍长的音频——这直接支撑了 60-90 分钟的长音频处理能力,是其他语音模型无法做到的
- Next-Token Diffusion 范式创新:LLM 做全局上下文建模 + 轻量扩散头(仅 4 层 FFN)做声学细节精修,兼顾自回归的长序列建模能力和扩散模型的高保真音质。扩散头的 AdaLN-Zero 调制设计可迁移到任何”LLM + 连续信号生成”场景
- 三合一模型家族的实用价值:TTS-1.5B / ASR-7B / Realtime-0.5B 共享核心分词器和架构,是目前少数同时覆盖语音合成与识别的开源项目,已集成 HuggingFace Transformers v5.3.0
项目展示
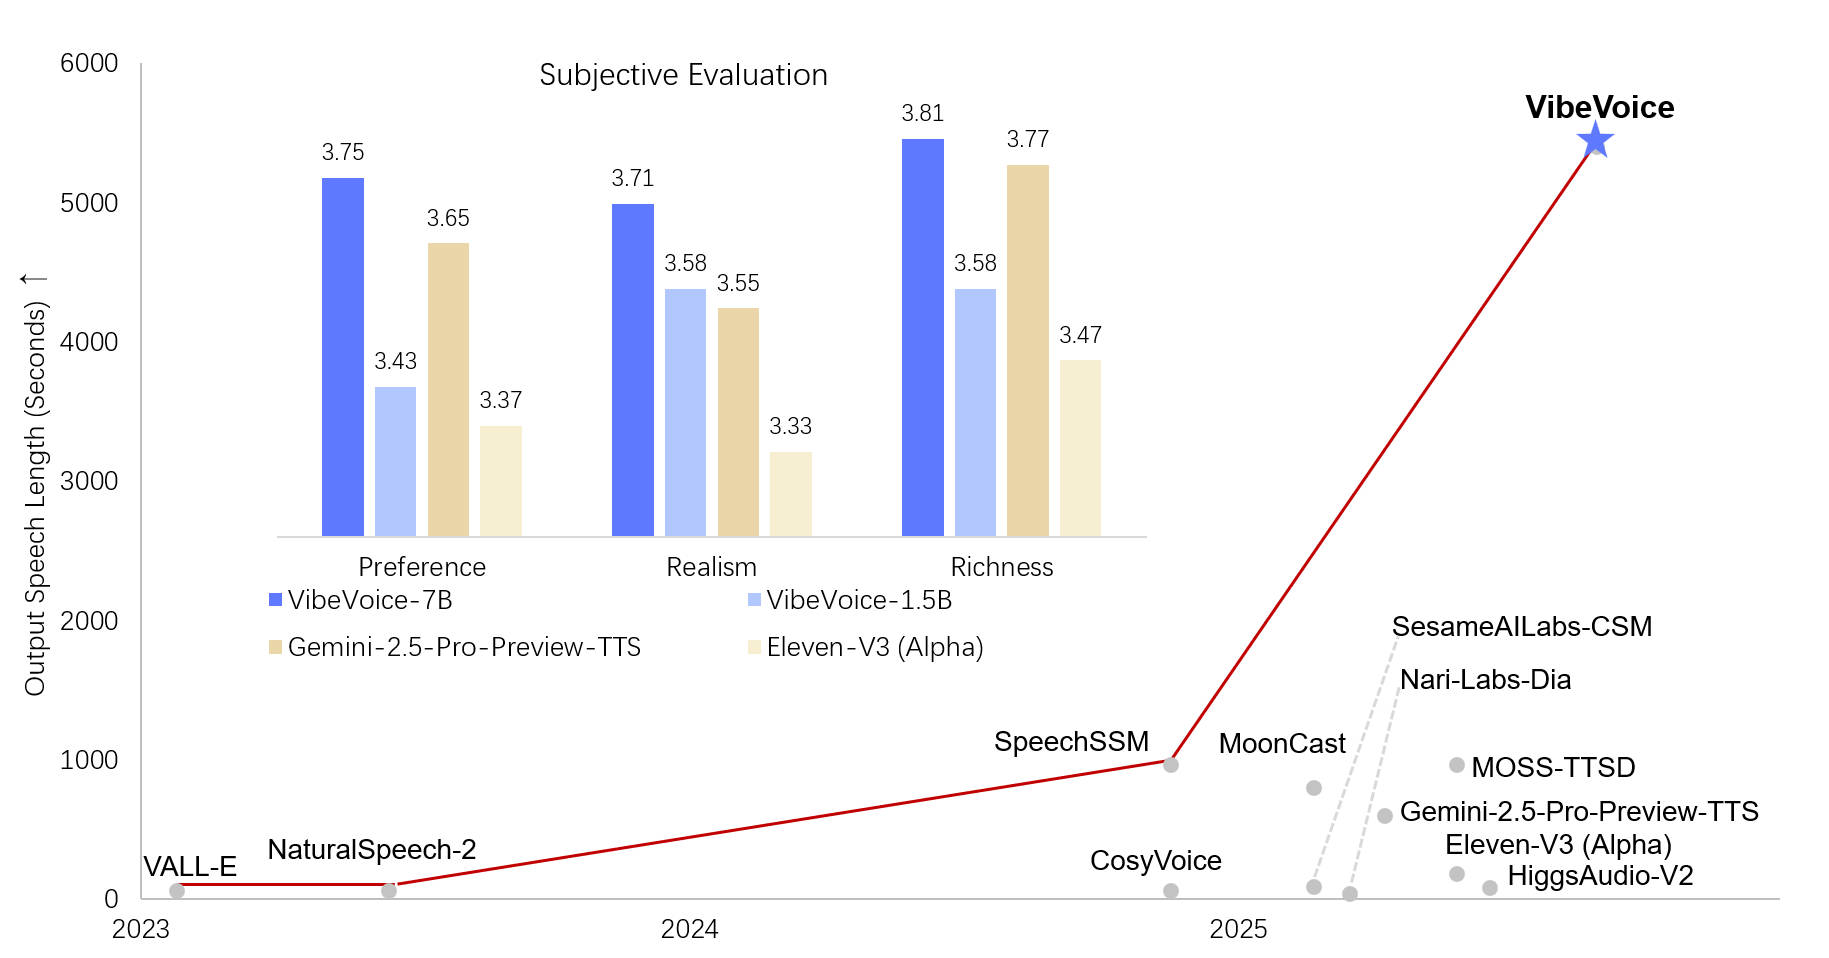
TTS 生成质量基准评测:在长对话场景下的各项指标对比
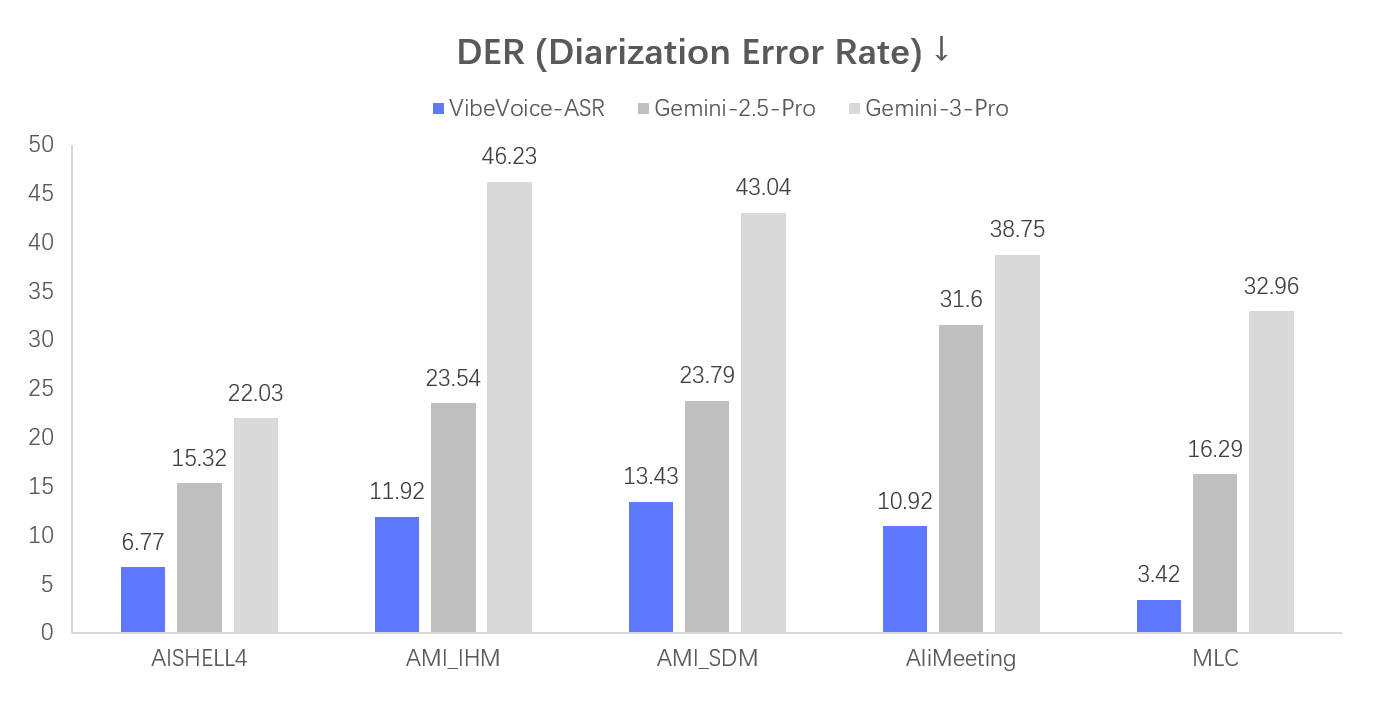
ASR 说话人分离错误率(DER)基准对比
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/microsoft/VibeVoice |
| Star / Fork | 23,942 / 2,643 |
| 代码行数 | 13,184 (Python 88%, JSON 3%, HTML/CSS/JS 7%) |
| 项目年龄 | 7 个月(2025-08-25 创建) |
| 开发阶段 | 早期快速迭代(无正式版本发布,2026-01 为功能集中上线月) |
| 贡献模式 | 小团队(10 人,核心 4 人,MSRA 内部驱动) |
| 热度定位 | 大众热门(7 个月 24K star,日均 110) |
| 质量评级 | 代码[B] 文档[B+] 测试[D] |
作者视角:为什么存在这个项目
创始人/作者背景
Microsoft Research 亚洲研究院(北京/深圳)语音 AI 团队。核心开发者 YaoyaoChang (41 commits, 47.7%)、Jianwei Yu (MSLDCherryPick, 高级研究员)、YingboHAO (博士生,LLM 压缩/AI Infra 方向)、Zhiliang Peng (研究员)。合并审批由 Li Dong 和 Zhiliang Peng 等高级研究员负责。团队以语音 AI 和大模型压缩领域研究员为主,commit 时间集中在亚洲时区工作时间。
问题判断
团队识别了语音 AI 的三个核心瓶颈:
- 长音频处理差:多数 ASR 需将音频切片(Whisper 仅支持 30 秒),丢失全局上下文(说话人信息、跨段语义)
- 帧率过高:传统语音分词器 50-75 Hz,1 分钟音频产生 3000-4500 个 token,LLM 上下文窗口很快耗尽
- 生态碎片化:TTS/ASR/Realtime 各自为政,缺乏统一的分词器和架构
时机关键:LLM 自回归框架已成熟(Qwen2.5 系列可直接复用),扩散模型在图像领域已验证,将两者结合应用到语音是自然的研究方向。
解法哲学
“LLM 做上下文,扩散做保真”——核心设计原则:
- 极致压缩:7.5 Hz 连续分词,将音频视为”低帧率连续信号”而非”高帧率离散 token”
- 双分词器:声学(保真度)+ 语义(可理解性)双路编码,ASR 和 TTS 各取所需
- 轻量扩散头:仅 4 层 FFN,让 LLM 承担主要建模,扩散头只做”最后一公里”的声学精修
- 安全优先:TTS 代码因滥用风险被移除,Realtime 模型不支持 zero-shot 声音克隆,改用预设声音 + 自动水印
战略意图
- 学术产出:Next-Token Diffusion 范式的两篇技术报告(TTS + ASR),为 MSRA 在语音 AI 领域建立学术影响力
- 生态卡位:集成 HuggingFace Transformers v5.3.0 + vLLM 插件,争取开源语音 AI 的标准接口地位
- Azure 商业化:ASR 模型已进入 Azure AI Foundry 模型目录,是微软云语音服务的潜在技术储备
- 安全示范:TTS 代码移除事件本身是 AI 安全的典型案例,后续设计体现了”功能降级换安全”的负责任 AI 实践
核心价值提炼
创新之处
-
7.5 Hz 连续语音分词器(新颖度 5/5 × 实用性 5/5) 6 级卷积下采样(ratios=[8,5,5,4,2,2])实现 3200:1 压缩,24kHz 音频变为 7.5 Hz 连续 VAE 潜表示(非离散 token)。AcousticTokenizer(dim=64, 高斯采样保真度)+ SemanticTokenizer(dim=128, 无噪声保语义)双路设计。比 EnCodec 低 10 倍帧率,直接支撑 60-90 分钟长音频处理
-
Next-Token Diffusion 架构(新颖度 5/5 × 实用性 4/5) 在 LLM 自回归框架上增加轻量扩散头(仅 4 层 FFN + AdaLN-Zero 调制),LLM 产出条件向量,扩散头在条件指导下用 20 步 DPM-Solver 生成高保真声学细节。兼顾自回归的长序列建模和扩散的音质优势
-
60 分钟单次 ASR 处理(新颖度 4/5 × 实用性 5/5) 流式编码器缓存(
VibeVoiceTokenizerStreamingCache)+ 64K token 上下文 + Qwen2.5-7B 骨干,一次性处理超长音频,同时输出说话人分离、精确时间戳和结构化 JSON -
Streaming TTS 分层 Transformer(新颖度 4/5 × 实用性 4/5) 将 Qwen2.5 显式拆分为文本编码层(低层)和语音生成层(高层 20 层),配合窗口化交错调度(text window=5, speech window=6),实现 ~200ms 首音延迟
-
Dual Tokenizer 声学/语义分离(新颖度 3/5 × 实用性 4/5) 声学分词器保真度(高斯采样),语义分词器保语义(无噪声),两路通过各自 Connector 投影后相加融合。ASR 同时使用两路信息,比单路编码更鲁棒
可复用的模式与技巧
- 轻量扩散头模式:仅 4 层 FFN + AdaLN-Zero,以 LLM hidden states 为条件生成连续信号。可迁移到图像、音乐等任何”LLM + 连续信号生成”场景
- 流式卷积缓存模式:
(layer_id, sample_idx)键值管理每层卷积上下文缓存,支持分段编码后无缝拼接。适用于任何流式音频/信号处理的卷积编码器 - vLLM 插件注册模式:通过
pyproject.tomlentry-point 注册自定义多模态模型到 vLLM,含 Config/Tokenizer/Processor/Model 四件套 + AudioMediaIO 猴子补丁 - SpeechConnector 投影桥:
fc1 → RMSNorm → fc2简单投影,连接不同维度空间(分词器输出 → LLM 隐藏空间),在 TTS/ASR/Streaming 三个模型中复用 - Transformers 版本兼容层:
MockCacheLayer+_ensure_cache_has_layers处理 Transformers 4.57+ 缓存系统重构,任何跨版本自定义模型可参考
关键设计决策
| 决策 | 牺牲了什么 | 换来了什么 |
|---|---|---|
| 连续 VAE 而非离散 VQ | 需要扩散头解码(多步采样) | 避免码本崩塌 + 64 维连续向量比 VQ 码本承载更丰富信息 |
| 扩散头仅 4 层 FFN | 声学建模深度有限 | 参数极少 + 仅 20 步采样即可,推理快 |
| TTS 代码移除 | 社区无法复现训练 | 避免深伪滥用,负责任 AI |
| Realtime 不支持声音克隆 | 功能受限 | 安全可控(预设声音 + 水印) |
| 7B 参数的 ASR 模型 | 部署成本高(需 GPU) | 60 分钟长音频 + 说话人分离 + 时间戳 |
竞品格局与定位
竞品对比矩阵
| 维度 | VibeVoice | Whisper V3 | CosyVoice2 | Orpheus TTS | Qwen3-ASR |
|---|---|---|---|---|---|
| 覆盖能力 | TTS+ASR+Realtime | 仅 ASR | 仅 TTS | 仅 TTS | 仅 ASR |
| 最长音频 | 60-90 min | 30 秒分段 | ~30 秒 | ~30 秒 | 未公开 |
| 帧率 | 7.5 Hz | 50 Hz | 25 Hz | 50 Hz | - |
| 说话人分离 | 内置 | 无 | 无 | 无 | 无 |
| 声音克隆 | 已移除/预设 | N/A | Zero-shot | Zero-shot | N/A |
| 模型大小 | 0.5B-7B | 1.5B | 0.5B | 3B | 未公开 |
| 部署成本 | 高 | 低 | 中 | 中 | - |
差异化护城河
- 长音频处理护城河:7.5 Hz 分词器 + 64K 上下文窗口的组合,使 60 分钟单次处理成为可能。竞品要复制需要从分词器架构重新设计
- 全栈覆盖护城河:TTS/ASR/Realtime 共享分词器和架构,三个模型互相验证和增强,是单一模型项目难以企及的系统性优势
- 微软背书护城河:MSRA 团队 + Azure AI Foundry 商业化路径 + Transformers 官方集成
竞争风险
- Qwen3-ASR 在纯转写精度上可能超越 VibeVoice-ASR,阿里的资源投入可能更持久
- CosyVoice2 在中文 TTS 生态中更成熟,且支持 zero-shot 声音克隆
- TTS 代码被移除是重大竞争劣势——用户无法训练或微调 TTS 模型
- 核心团队仅 4-5 人,如果 MSRA 调整研究方向,项目可能失去动力
生态定位
在语音 AI 开源领域占据”长音频全栈处理”的独特位置。与 Whisper(短音频 ASR 标准)、CosyVoice2(中文 TTS 标准)互补。填补了”60 分钟音频一次性处理 + 说话人分离 + 时间戳”的能力空白,是会议转录、播客处理等场景的首选开源方案。
套利机会分析
- 信息差: 7.5 Hz 连续分词器的技术思路尚未被广泛复制——将”极致压缩帧率”的理念应用到其他模态(视频、传感器数据)是真正的信息差
- 技术借鉴: (1) 轻量扩散头模式(4 层 FFN + AdaLN-Zero)可迁移到图像/音乐生成;(2) 流式卷积缓存的分段编码模式;(3) vLLM 插件注册机制;(4) Dual Tokenizer 声学/语义分离设计
- 生态位: 填补了”长音频全栈语音 AI”的空白,特别是 60 分钟会议/播客的一次性处理
- 趋势判断: 语音 AI 是 2025-2026 年最活跃的 AI 子领域之一。VibeVoice 增长强劲(日均 110 star),已进入 Azure AI Foundry,商业化路径清晰
风险与不足
- TTS 代码被移除:因安全考虑移除了 TTS 训练和推理代码(仅保留模型权重),用户无法完整复现或微调 TTS 模型。这是最大的实用性损失
- 测试几乎为零(评级 D):核心模型代码无任何单元测试,仅 vLLM 插件有 2 个手动测试脚本。无 CI/CD 流水线
- 无正式版本发布:没有 Git tag 或 GitHub Release,API 可能随时变更
- 明确标注”仅供研究用途”:不建议生产使用,法律和安全责任未明确
- 核心团队极小(4-5 人):bus factor 风险高,近 90 天 commit 节奏放缓(仅 15 次)
- 部署成本高:ASR-7B 需要 GPU + vLLM,相比 Whisper 的 CPU 推理门槛高得多
- 中文质量曾有问题:Issue #21(发音错误)、#16(汉字不发声),虽已修复但暴露了多语言鲁棒性风险
行动建议
- 如果你要用它: ASR 场景首选——60 分钟会议/播客的一次性转录 + 说话人分离 + 时间戳,这是 Whisper 做不到的。Realtime TTS 可用于 LLM 语音对话场景(0.5B 参数轻量)。TTS 长对话生成目前因代码移除而受限。对比竞品:短音频 ASR → Whisper,中文 TTS → CosyVoice2,长音频全栈 → VibeVoice
- 如果你要学它: 重点关注以下文件:
vibevoice/modular/modular_vibevoice_tokenizer.py(1206 行) — 7.5 Hz 双分词器核心,AcousticTokenizer + SemanticTokenizervibevoice/modular/modular_vibevoice_diffusion_head.py(286 行) — 轻量扩散头的 AdaLN-Zero 实现vibevoice/modular/modular_vibevoice_streaming.py— 分层 Transformer + 窗口化交错调度vllm_plugin/model.py— vLLM 插件集成模式- 技术报告: arxiv/2508.19205 (TTS)、arxiv/2601.18184 (ASR)
- 如果你要 fork 它: 可改进方向:
- 补充单元测试和 CI/CD(当前测试覆盖几乎为零)
- 重构
modular_vibevoice_tokenizer.py(1206 行可拆分为 Encoder/Decoder/Block 独立模块) - 替换
print()调试输出为logger - 添加正式版本发布流程
- 探索更多语言的 ASR 微调(社区 #115 强烈需求)
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | deepwiki.com/microsoft/VibeVoice |
| Zread.ai | zread.ai/microsoft/VibeVoice |
| 官方项目页 | microsoft.github.io/VibeVoice |
| HuggingFace 模型集合 | huggingface.co/collections/microsoft/vibevoice |
| TTS 技术报告 | arxiv/2508.19205 |
| ASR 技术报告 | arxiv/2601.18184 |
| Azure AI Foundry 博客 | Introducing VibeVoice ASR |
| ASR Playground | aka.ms/vibevoice-asr |
| Colab (Realtime) | Colab Notebook |