Open Notebook 深度分析报告
一句话总结
开源版 Google NotebookLM 的领跑者(21K Stars),通过自研 Esperanto 多模型抽象层实现 16+ AI 供应商自由切换,是隐私优先 + 多模型 + 播客生成三合一的个人 AI 研究助手。
值得关注的理由
- “组合优于构建”的生态策略:作者将核心能力拆分为 4 个独立 PyPI 包(esperanto、content-core、podcast-creator、surreal-commands),每个都可独立使用,这种架构分离策略值得所有 AI 应用开发者学习
- 多阶段策略式 RAG:
ask.py实现了”LLM 制定搜索策略 → 并行向量搜索 → 子答案生成 → 综合”的高级检索模式,比标准 RAG 更适合复杂研究问题 - NotebookLM 替代赛道的领先者:21K Stars,多家权威媒体(KDnuggets、The New Stack、XDA)专题报道,在自托管 AI 研究工具领域建立了强势品牌
项目展示
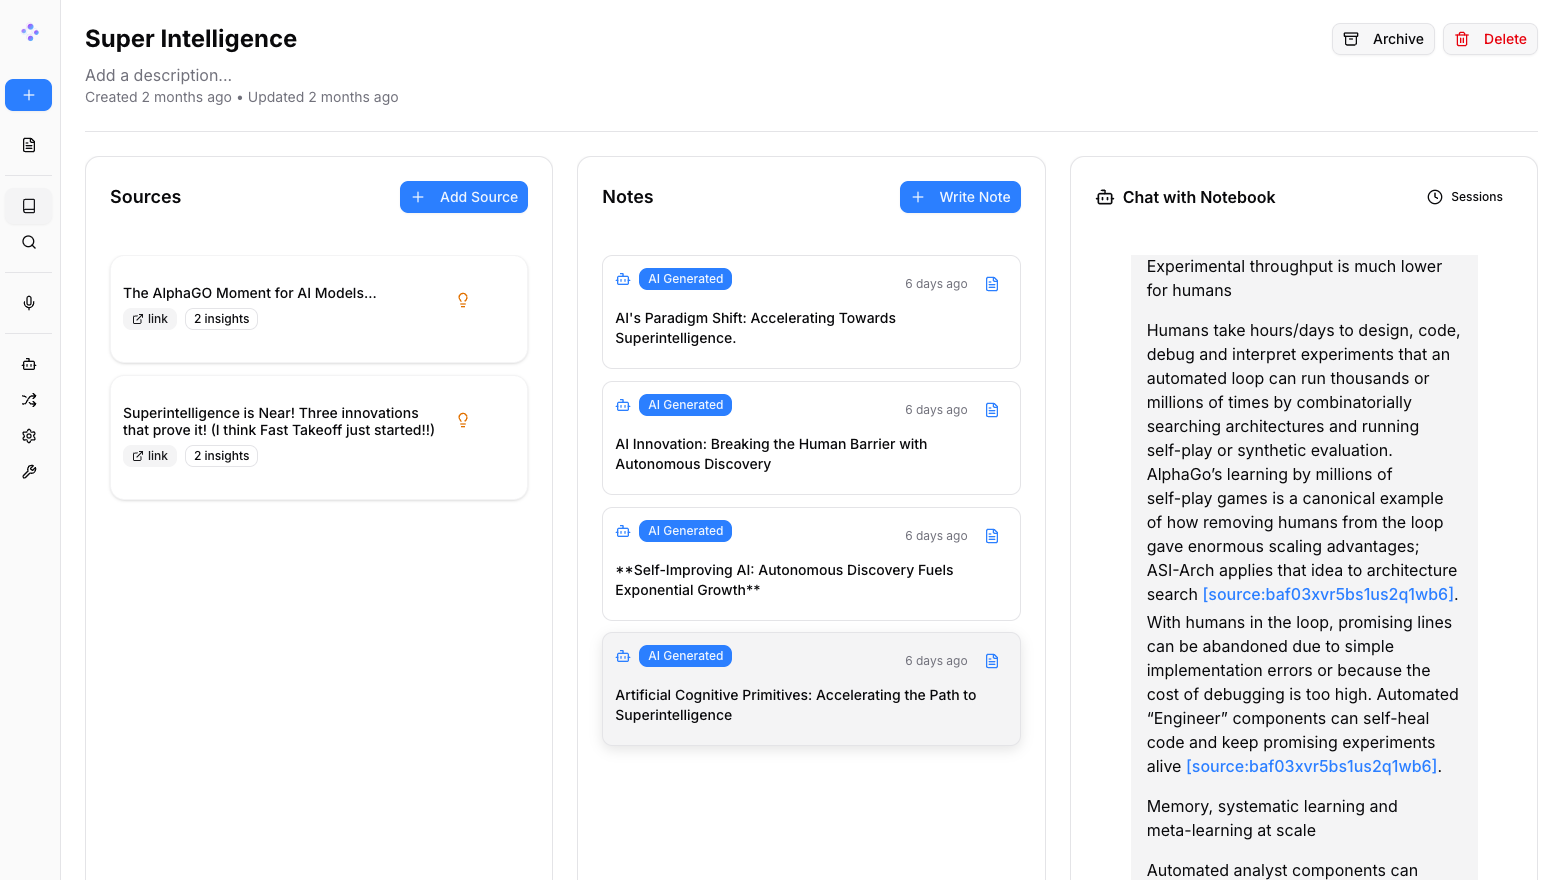
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/lfnovo/open-notebook |
| Star / Fork | 21,257 / 2,420 |
| 代码行数 | 48,255(Python 35%, TSX 35%, TypeScript 27%) |
| 项目年龄 | 17 个月(2024-10-21 创建) |
| 开发阶段 | 成熟活跃期(v1.8.1,每 1-2 周发版) |
| 贡献模式 | 独立开发(Luis Novo 贡献 87.6%,36 位贡献者) |
| 热度定位 | 大众热门(GitHub Trending 入选) |
| 质量评级 | 代码[良好] 文档[优秀] 测试[不足] |
| License | MIT |
作者视角:为什么存在这个项目
创始人/作者背景
Luis Novo(lfnovo),巴西圣保罗独立开发者,Supernova Labs。GitHub 15 年老号,931 粉丝。围绕 open-notebook 构建了完整技术生态栈:esperanto(159★,多模型抽象)、content-core(138★,内容处理)、podcast-creator(109★,播客生成)。
问题判断
发现 AI 研究工具的三重锁定:供应商锁定(NotebookLM 仅支持 Google 模型)、数据锁定(敏感数据只能在 Google 云端)、功能锁定(播客仅 2 人、处理不可定制)。用户 Issue 确认了这些痛点的真实性:安装/连接问题频发(#179, #159),离线需求被标记为高优先级(#264)。
解法哲学
- “组合优于构建”:不重新发明轮子,将内部能力拆分为独立 PyPI 包(esperanto、content-core、podcast-creator、surreal-commands),每个独立维护、版本化、测试
- 隐私即架构:所有数据存在用户自己的 SurrealDB 实例中,API 密钥用 Fernet 加密
- 选择不做:不做多用户(保持简洁的个人工具定位)、不做云托管版本
战略意图
从底层库到上层应用的完整生态栈。每个库独立有价值(esperanto 可被其他项目使用),扩大影响力。Kubernetes Helm Chart PR(#363)暗示下一步可能走向企业级部署。
核心价值提炼
创新之处
-
多阶段策略式 RAG(新颖度 4/5,实用性 5/5,可迁移性 4/5)
ask.py:用户问题 → LLM 制定搜索策略(最多 5 个搜索项)→ 并行向量搜索 → 子答案生成 → 综合最终答案,用 LangGraphSend实现扇出并行
-
内容类型感知的智能分块(新颖度 3/5,实用性 4/5,可迁移性 5/5)
- 自动检测内容类型(HTML/Markdown/纯文本),按语义结构分割而非简单字符数切割
-
播客 Episode/Speaker Profile 系统(新颖度 4/5,实用性 4/5,可迁移性 3/5)
- 1-4 位发言人,每人独立的声音/性格/背景故事,per-speaker TTS 模型覆盖
-
LLM 错误分类器(新颖度 2/5,实用性 5/5,可迁移性 5/5)
- 将 AI 供应商的原始异常映射为用户友好的错误类型和消息,避免重复编写错误处理
-
ContextBuilder 优先级截断(新颖度 3/5,实用性 4/5,可迁移性 5/5)
- 按 source:100 > insight:75 > note:50 排序,从低优先级开始截断以适应 token 限制
可复用的模式与技巧
| 模式 | 简述 | 适用场景 |
|---|---|---|
| Esperanto 式多供应商抽象 | ModelManager + AIFactory + Credential 统一接口 | 需要支持多 AI 供应商的项目 |
| Command 装饰器模式 | @command("name", retry={...}) 解耦后台任务 | 任何异步任务队列 |
| ContextBuilder 优先级截断 | 多源信息按优先级排序并截断 | LLM 上下文窗口管理 |
| ObjectModel 声明式 ORM | Pydantic + ClassVar table_name + 反射查找 | SurrealDB 或类似 NoSQL 项目 |
| 异步迁移管理器 | 版本追踪表 + 顺序执行 .surrealql | 轻量级数据库迁移 |
关键设计决策
- SurrealDB 图数据库:原生图关系 + 内置向量搜索,但事务冲突导致激进重试(15 次),生态成熟度风险是最大赌注
- Esperanto 统一模型层:三层智能选择(大上下文自动切换 → 显式指定 → 类型默认),牺牲了直接调用 SDK 的灵活性换来供应商无关性
- LangGraph 状态机编排:6 个核心工作流用 StateGraph 实现,但同步节点限制导致 async/sync 桥接代码复杂
竞品格局与定位
竞品对比矩阵
| 维度 | Open Notebook | SurfSense (13.4K★) | Google NotebookLM |
|---|---|---|---|
| Stars | 21,257 | 13,415 | N/A(商业) |
| AI 模型 | 16+ 供应商 + Ollama 本地 | 多供应商 | 仅 Google 模型 |
| 部署方式 | 完全自托管 | 云/自托管混合 | 纯云端 |
| 播客能力 | 1-4 发言人,完全可定制 | 无 | 2 人固定 |
| 目标用户 | 个人研究者/学生 | 团队协作 | 普通用户 |
| 引用系统 | 基础(承认待改进) | 中等 | 完善 |
| 多用户 | 不支持 | 支持 | 支持 |
差异化护城河
- 模型自由度:唯一支持 16+ 供应商 + 完全本地 Ollama 的方案
- 播客生成深度:Episode/Speaker Profile 系统远超任何竞品
- Transformation 系统:可定制的内容处理管道是独有功能
- 底层库生态:esperanto、content-core 等独立库构成技术护城河
竞争风险
- SurfSense 在团队协作方向发力,可能吸引企业用户
- Google NotebookLM 的产品成熟度和引用系统远超本项目
- SurrealDB 生态风险——如发展不及预期,迁移成本巨大
生态定位
“隐私优先的个人 AI 认知伙伴”,填补了 NotebookLM 无法自托管、无法选择模型的空白。与 SurfSense 形成错位竞争(个人 vs 团队)。
套利机会分析
- 信息差: 低。21K Stars + 多家权威媒体报道,已充分曝光
- 技术借鉴: Esperanto 多供应商抽象模式、多阶段策略式 RAG(ask.py)、LLM 错误分类器、ContextBuilder 优先级截断——这些模式可直接迁移到任何 AI 应用
- 生态位: 在”自托管 NotebookLM 替代”这一明确品类中占据第一位置
- 趋势判断: 上升趋势。NotebookLM 替代需求持续增长,隐私和数据主权意识增强。但单人开发模式的可持续性是长期风险
风险与不足
- Bus Factor = 1:87.6% commit 来自作者一人,核心开发完全依赖个人
- SurrealDB 生态风险:选用了不成熟的数据库,事务冲突导致激进重试(15 次),迁移成本高
- 测试覆盖不足:约 13% 覆盖率,无集成测试和 E2E 测试
- async/sync 桥接问题:chat.py 中 ThreadPoolExecutor 模式存在资源泄漏风险
- 无连接池:每次 SurrealDB 操作都创建新连接
- 安装痛点:安装/连接问题是用户最大痛点(#179, #159, #316 等),Docker 部署门槛较高
- 单用户架构:不支持多用户,限制企业采用
- 引用系统基础:README 明确承认”will improve”,对比 NotebookLM 差距明显
行动建议
- 如果你要用它: 作为个人 AI 研究助手的首选开源方案。建议用 Docker Compose 快速启动,优先配置 OpenAI 或 Anthropic 模型。如果需要完全离线,可配置 Ollama。注意 SurrealDB 的运维复杂度,遇到连接问题参考 docs/6-TROUBLESHOOTING/
- 如果你要学它: 重点关注 (1)
open_notebook/graphs/ask.py— 多阶段策略式 RAG 的完整实现;(2)open_notebook/ai/provision.py— 三层智能模型选择;(3)commands/— surreal-commands 的 fire-and-forget + 差异化重试模式 - 如果你要 fork 它: 改进方向:(1) 用连接池替代每次操作创建新连接;(2) 解决 chat.py 的 sync/async 桥接问题;(3) 增加集成测试覆盖;(4) 考虑提供 SQLite/PostgreSQL 作为 SurrealDB 的替代选项,降低部署门槛
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 已收录 |
| Zread.ai | 已收录 |
| 关联论文 | 无 |
| 在线 Demo | 无(需自托管) |
| 官网 | open-notebook.ai |
| KDnuggets 评测 | 专题文章 |
| XDA Developers | 评测文章 |