OpenRAG 深度分析报告
一句话总结
IBM/DataStax 旗下 Langflow 团队(146K stars)推出的一站式 RAG 平台——将 Langflow 可视化编排 + OpenSearch 向量搜索 + Docling 文档解析打包为单一部署包,uvx openrag 一条命令启动完整 RAG 栈,解决的不是「如何构建 RAG」而是「如何 5 分钟拥有生产级 RAG」。
值得关注的理由
- 「三驾马车」预集成策略:不自研解析引擎和编排框架,而是将三个成熟开源项目深度组合——这是 RAG 赛道中独特的「站在巨人肩膀上」策略,与 RAGFlow(全自研)和 Dify(自研编排)形成鲜明对比
- IBM 企业级背景:IBM 2025 年收购 DataStax 后的战略级开源项目,Docling 来自 IBM Research,watsonx/COS/AMS 深度集成。这不只是一个开源 RAG 工具,而是 IBM 云生态的 RAG 入口
- TUI 安装向导 + 一命令部署:基于 Textual 框架的终端 UI 实现配置→启动→监控全流程,
uvx openrag把四容器微服务编排简化为一条命令——DevOps 门槛降到极低
项目展示
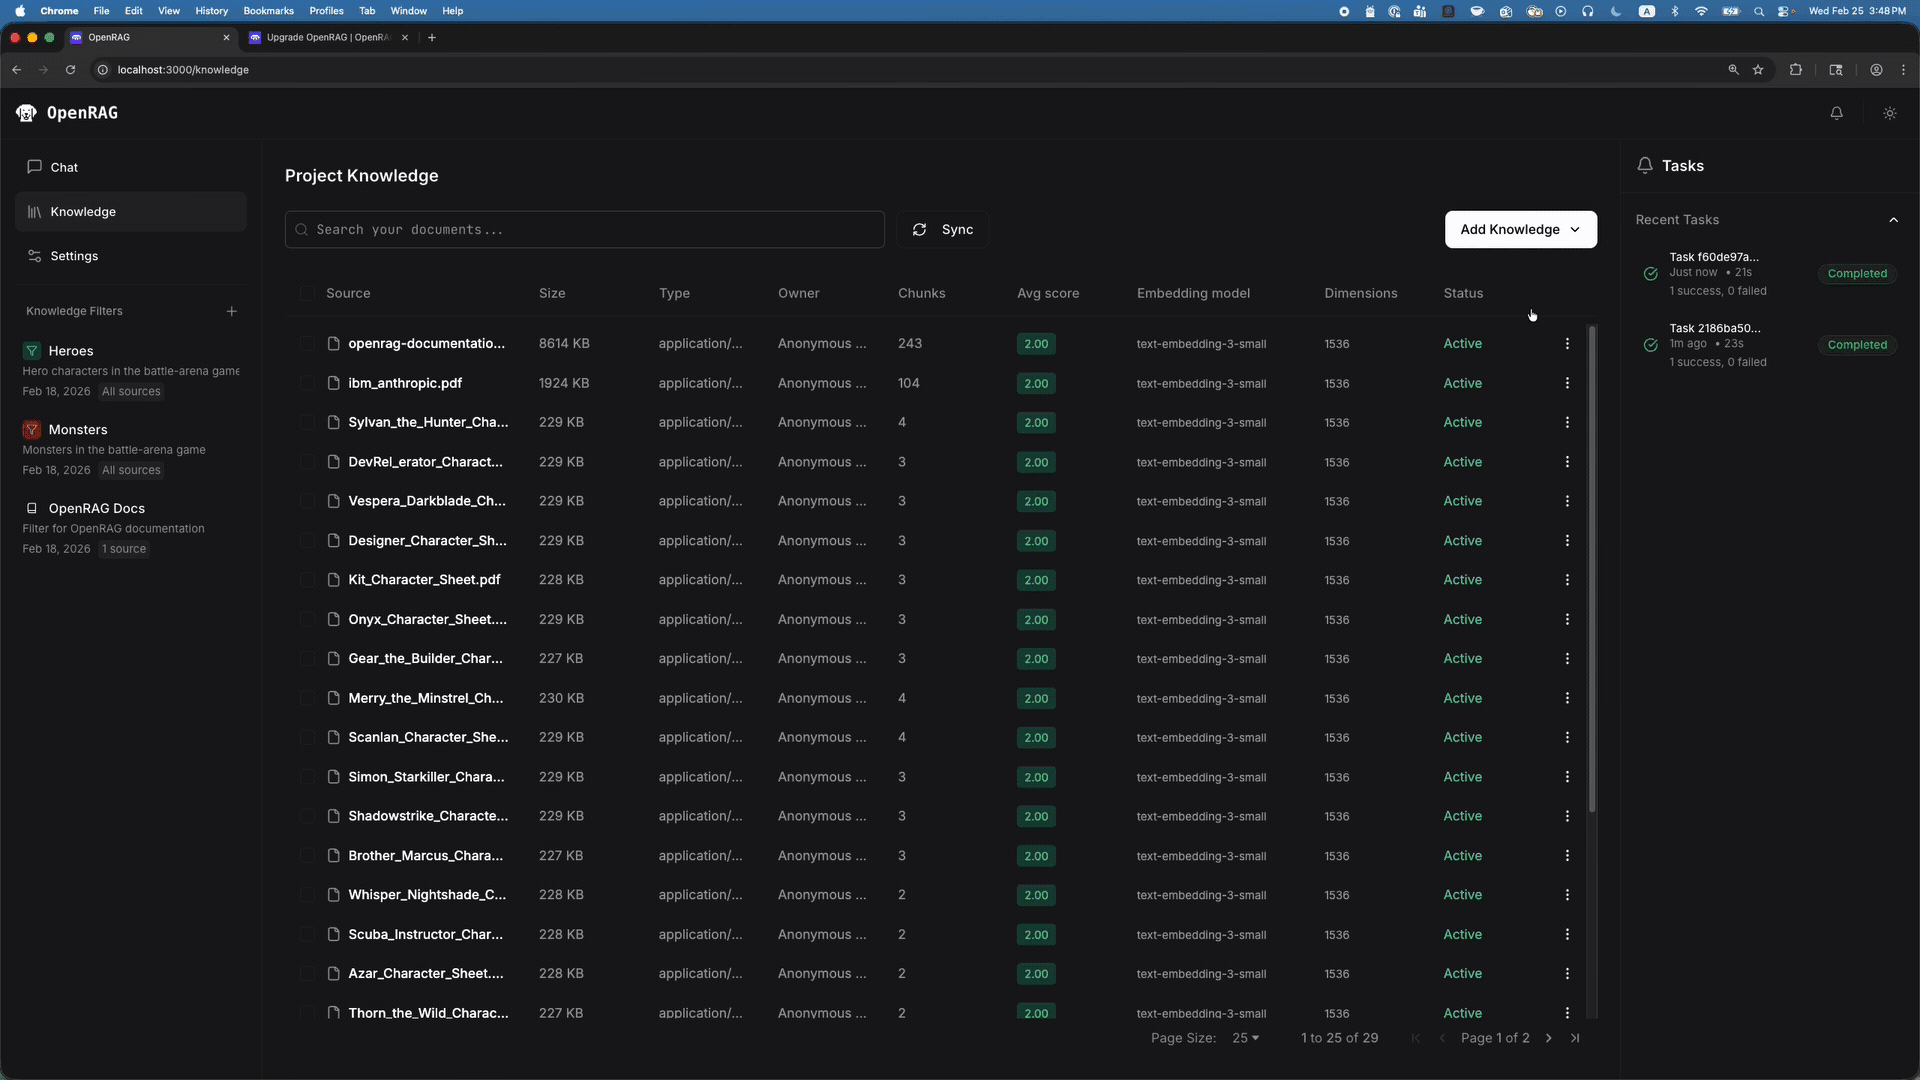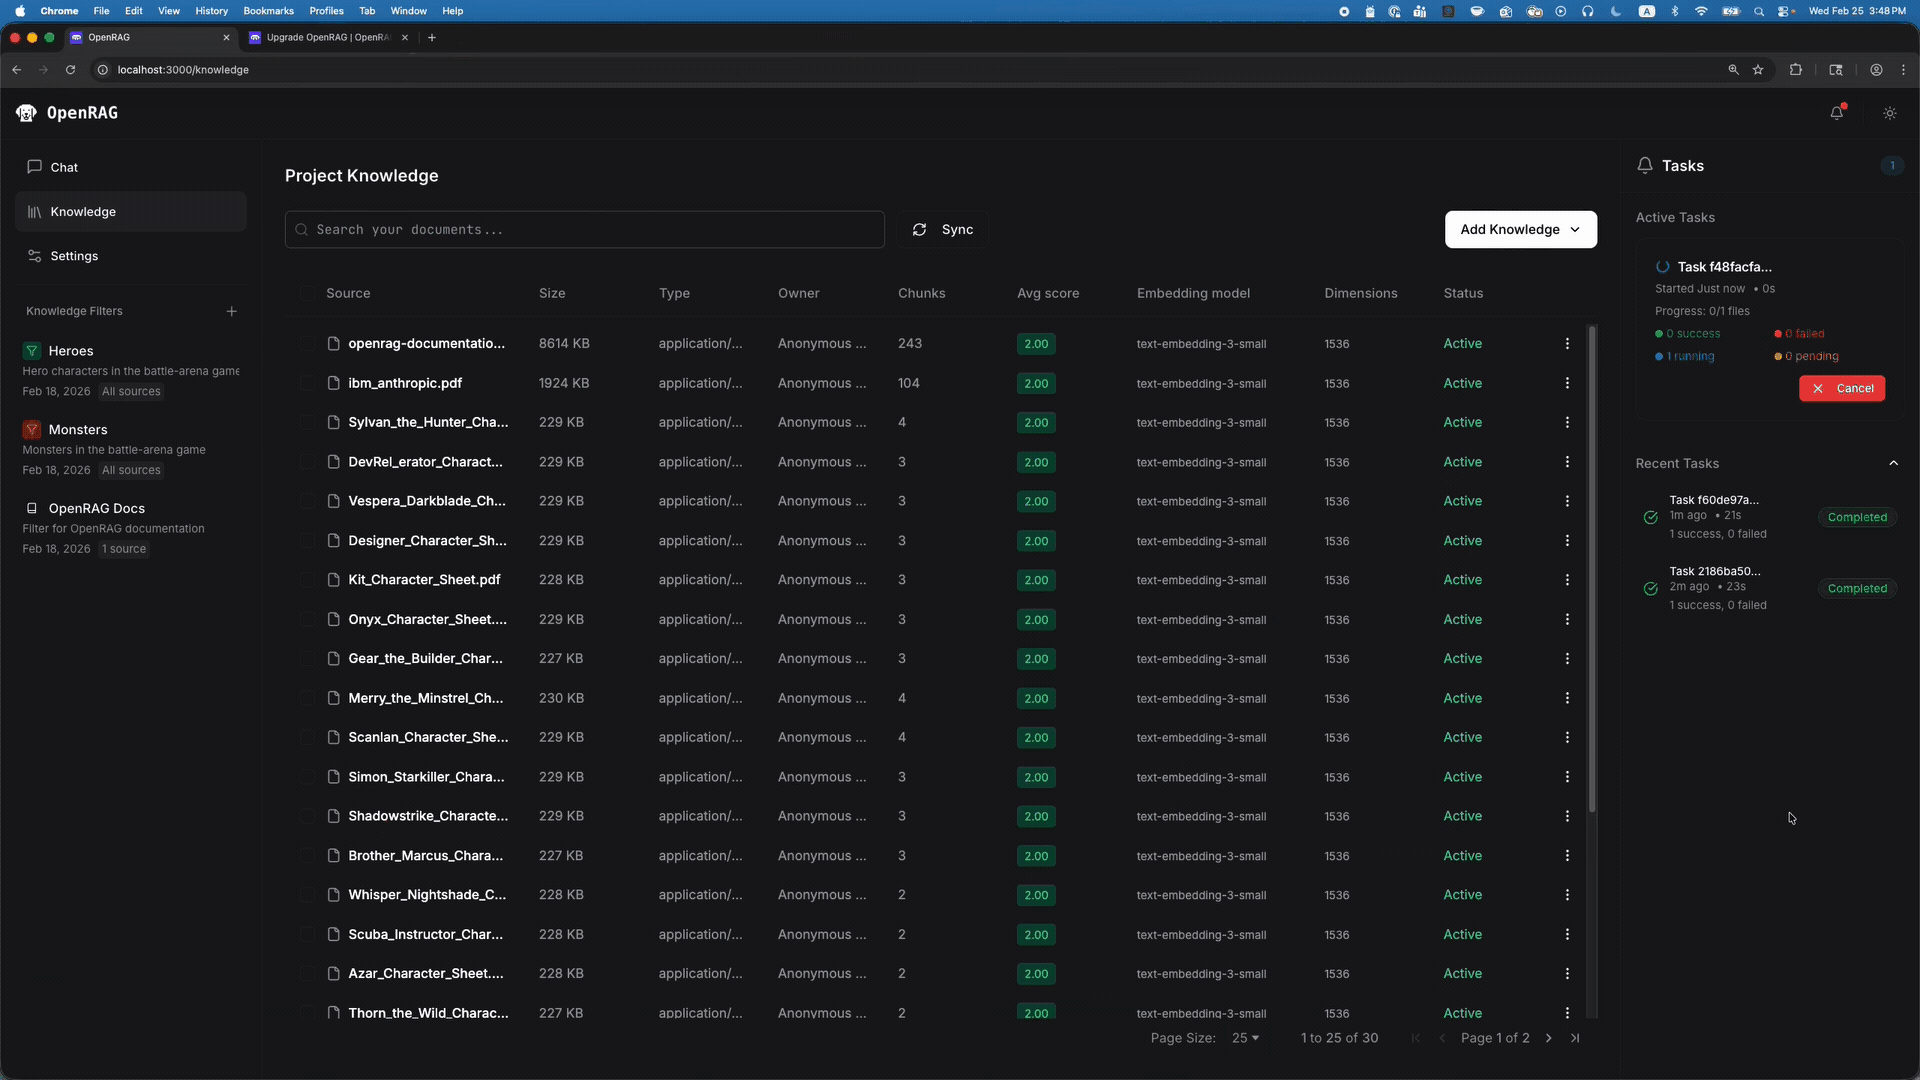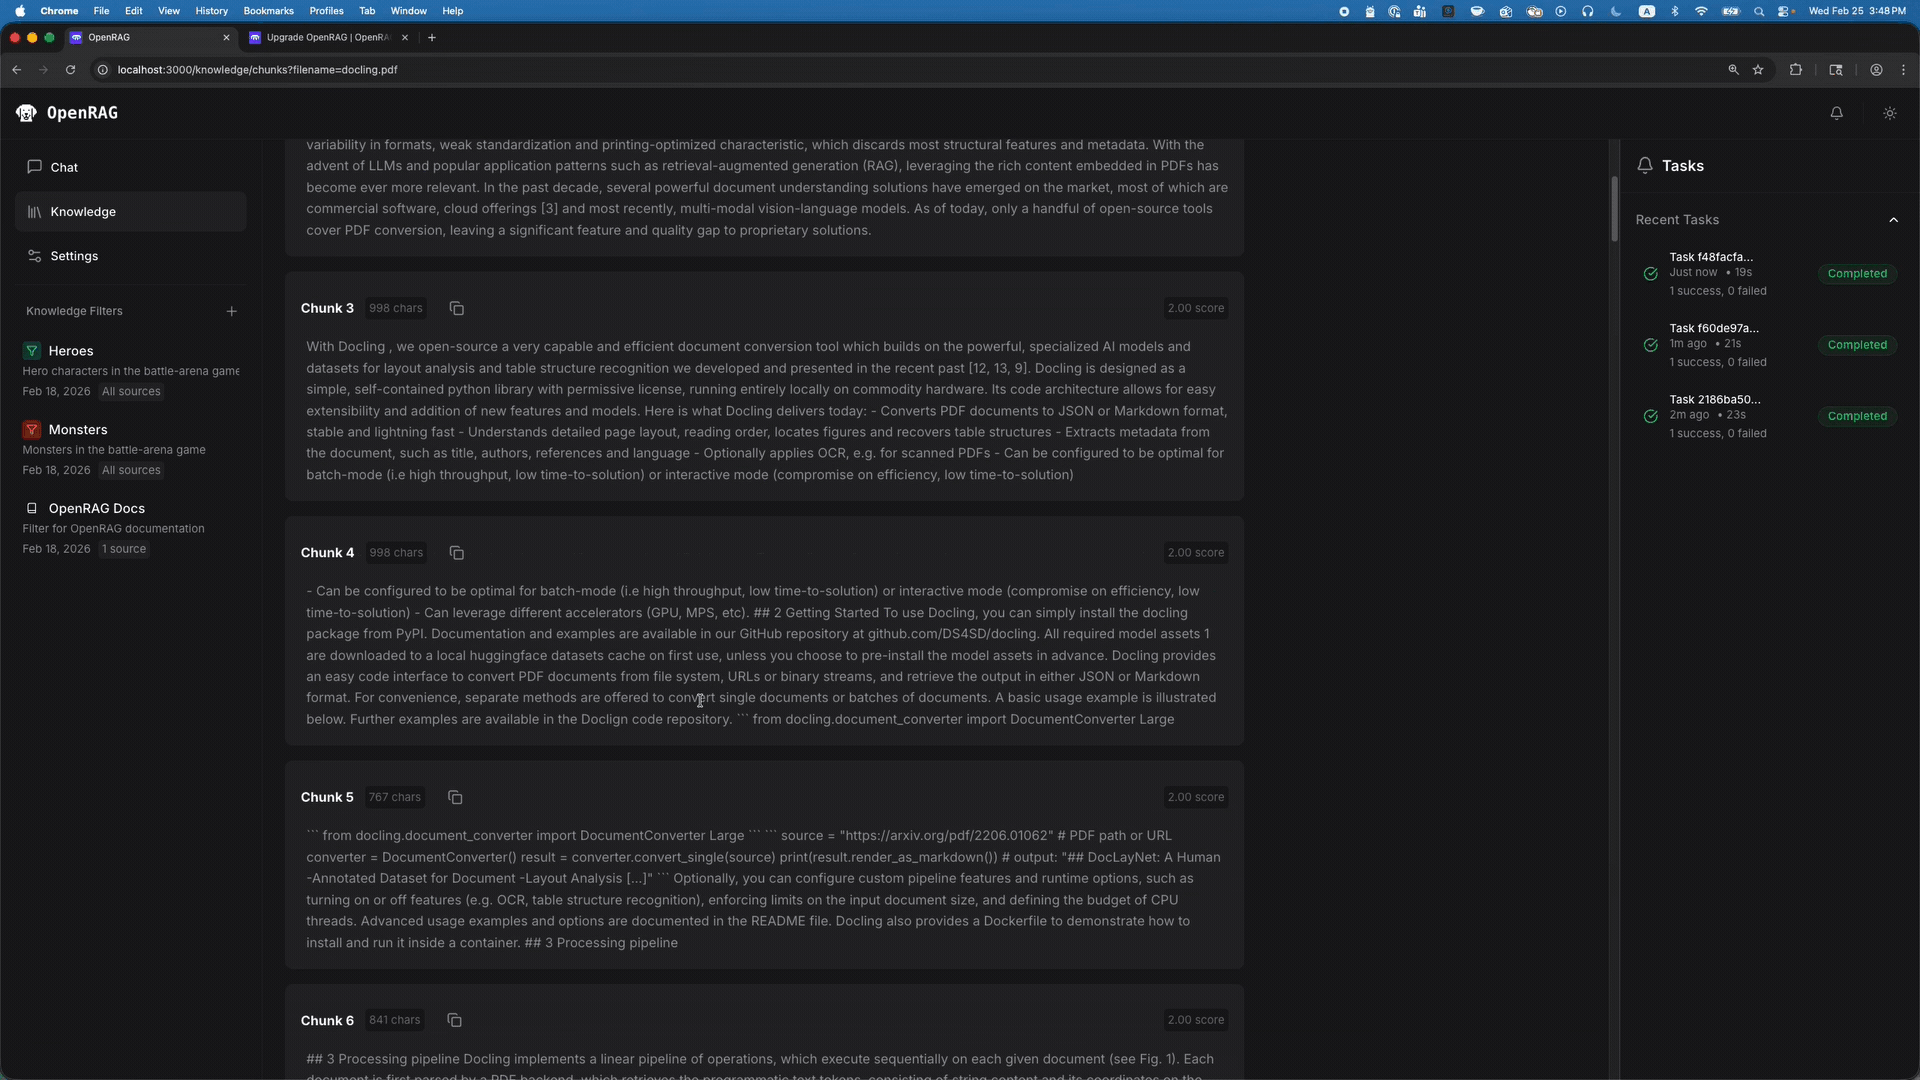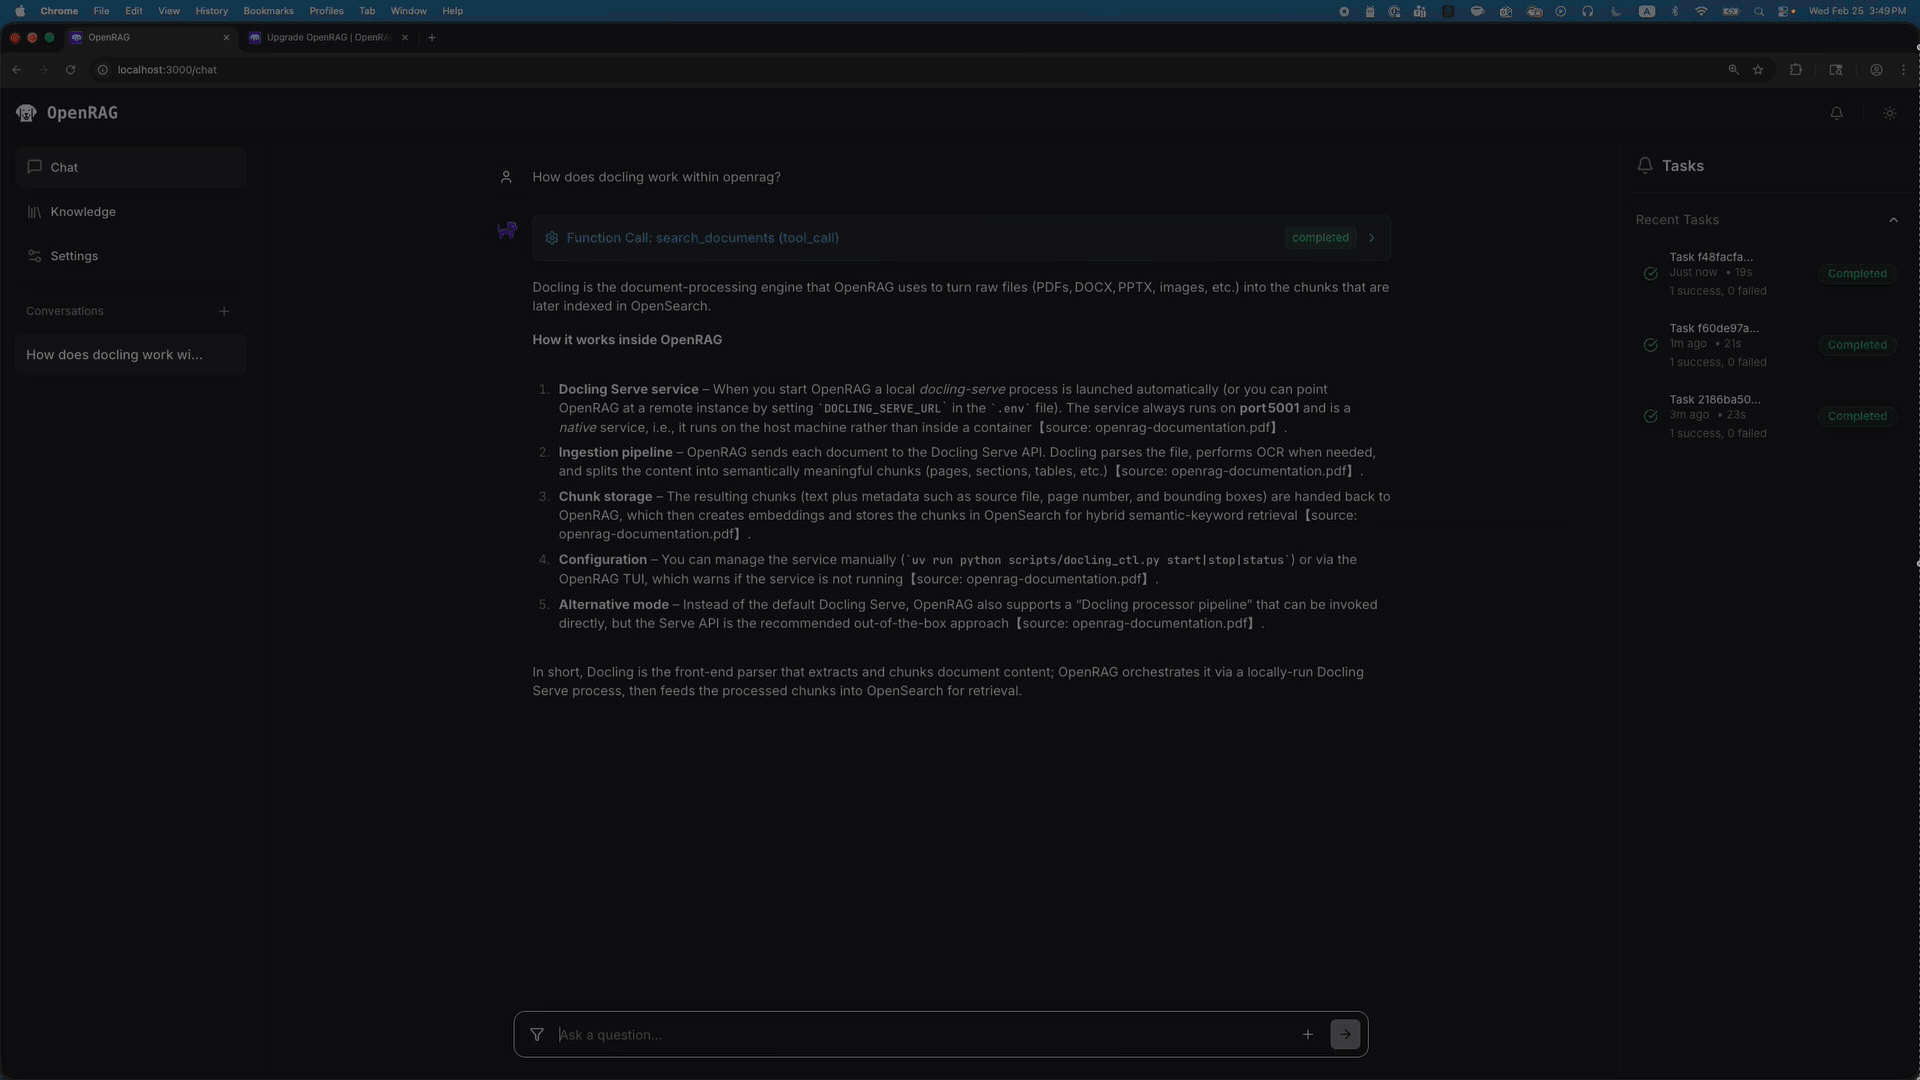
OpenRAG 完整产品演示——从文档上传到对话检索的全流程
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/langflow-ai/openrag |
| Star / Fork | 3,669 / 338 |
| 代码行数 | ~74,800 行(Python 后端 19K + Next.js 前端 5K + 测试 3.4K + 配置/文档) |
| 项目年龄 | 9 个月(2025-07-11 创建) |
| 开发阶段 | 快速迭代期(3,616 commits,55 个 Release,v0.4.0) |
| 贡献模式 | 企业团队主导(~10 人核心,50+ 贡献者) |
| 热度定位 | 中等热度 / 爆发型增长(3 月单月 +3,375 stars,占总量 92%) |
| 质量评级 | 代码[良好] 文档[优秀] 测试[基本] |
作者视角:为什么存在这个项目
创始人/作者背景
隶属于 Langflow 组织(146,594 stars 旗舰项目),DataStax 出品(2025 年被 IBM 收购)。核心开发者 phact(Sebastián Estévez,968 commits)是 DataStax 工程师,团队约 10 人的企业主导开源模式。ogabrielluiz(Langflow 核心成员)也有 67 次提交参与。
问题判断
核心洞察:LangChain 是框架,LlamaIndex 是索引库,RAGFlow 自研一切——它们都需要开发者做大量组装工作。企业用户不想从零构建 RAG 系统,他们想要「装一个就能用」的产品。
OpenRAG 解决的是「最后一公里」问题:Langflow 作为编排引擎虽然强大,但用户仍需自行搭建搜索引擎和文档解析。将三个成熟组件预集成为一键部署包,降低了从零到生产的复杂度。
解法哲学
「站在巨人肩膀上」的组合策略——不重新发明轮子:
- Langflow(146K stars):可视化工作流编排,已有完善生态
- OpenSearch:生产级向量搜索引擎,企业用户信任 AWS 生态兼容性
- Docling(IBM Research):处理「脏数据」(扫描 PDF、复杂表格)的能力是企业场景刚需
这与 RAGFlow(自研 DeepDoc 解析引擎)和 Dify(自研可视化编排)形成鲜明对比。
战略意图
OpenRAG 是 IBM 收购 DataStax 后的战略延伸——将 Langflow 从「通用 AI 编排工具」延伸到「企业文档智能搜索」。代码中大量 IBM 特有集成(watsonx、IBM COS、IBM AMS 认证、IBM Secrets Manager)表明开源版是获客入口,IBM 云服务是商业化路径。
核心价值提炼
创新之处
-
「三驾马车」预集成架构(新颖度 4/5 | 实用性 5/5 | 可迁移性 3/5):业界首个将 Langflow + OpenSearch + Docling 深度集成的开箱即用 RAG 平台。四容器微服务通过 Docker Compose 编排,TUI 安装向导实现一命令部署
-
动态 Embedding 维度探测(新颖度 3/5 | 实用性 5/5 | 可迁移性 5/5):
_probe_ollama_embedding_dimension()向 Ollama 发送测试文本自动获取模型维度,无需硬编码——多模型场景下极为实用 -
ContextVar 驱动的异步认证传播(新颖度 3/5 | 实用性 4/5 | 可迁移性 5/5):27 行代码用 Python
contextvars在异步调用链中透传用户身份,避免每个函数签名传递 auth 参数——优雅的多租户方案 -
Nudges 主动推荐机制(新颖度 4/5 | 实用性 4/5 | 可迁移性 4/5):通过 Langflow 工作流自动生成「知识推荐」,根据已索引内容和对话历史主动向用户推送相关问题——超越被动问答的传统 RAG 模式
-
双路径 Chat 架构(新颖度 3/5 | 实用性 4/5 | 可迁移性 4/5):直连 LLM(低延迟简单对话)vs Langflow 路由(带工具调用的 Agentic RAG),让简单问题快、复杂检索准
-
TUI 终端安装向导(新颖度 3/5 | 实用性 5/5 | 可迁移性 4/5):基于 Textual 框架实现配置→启动→监控→诊断全流程,把四容器编排简化为交互式体验
可复用的模式与技巧
| 模式 | 描述 | 适用场景 |
|---|---|---|
| ContextVar 认证传播 | 27 行代码在 FastAPI 异步链中透传上下文 | 任何多租户 FastAPI 应用 |
| Connector 插件架构 | BaseConnector 抽象类 + 注册表 + 加密凭证 | 多数据源对接 |
| MCP Tool 注册表 | 37 行全局工具注册+发现+分发 | 构建 MCP Server |
| 动态 Embedding 探测 | 向本地模型发送测试请求获取维度 | 多 Embedding 模型场景 |
| OpenSearch 健康检查 | 带 jitter 的指数退避 + 磁盘空间检测 | 生产级服务依赖检查 |
| Langflow 环境变量桥接 | 批量注入宿主环境变量到 Langflow 工作流 | 外部系统 + Langflow 集成 |
关键设计决策
| 决策 | Trade-off |
|---|---|
| 三驾马车组合而非自研 | 快速上线+复用成熟生态,但引入了外部依赖管理复杂度 |
| Langflow 作为外部服务调用 | 保持 Langflow 独立可升级,但每次 Chat 需经 HTTP 调用,增加延迟 |
| OpenSearch 而非 Chroma/Milvus | 企业用户信任度高+AWS 兼容,但资源开销大(1G+ JVM 堆内存) |
| Python 3.13 最低要求 | 使用最新语言特性,但限制了用户基础 |
| 四容器微服务 | 职责清晰+独立扩展,但资源开销远高于单体方案 |
竞品格局与定位
竞品对比矩阵
| 维度 | OpenRAG | RAGFlow | Dify | LangChain |
|---|---|---|---|---|
| Stars | 3,669 | 70K | 114K | 125K |
| 定位 | 预集成 RAG 平台 | 深度文档理解 RAG | 通用 AI 应用平台 | AI 开发框架 |
| 文档解析 | Docling(IBM Research) | 自研 DeepDoc | 内置基础解析 | 需自行集成 |
| 工作流引擎 | Langflow(外部) | 自研 RAG 管道 | 自研可视化编排 | LangGraph |
| 部署复杂度 | uvx openrag 一命令 | Docker Compose | Docker Compose | 代码级集成 |
| 企业集成 | IBM watsonx/COS 深度 | 有限 | Salesforce 等 | 自行开发 |
| MCP/SDK | Python/TS SDK + MCP | 无 | 有 API | 内置 |
差异化护城河
「预装机」模式——三个成熟项目的深度集成降低了用户的组件选择疲劳。IBM 企业生态(watsonx、COS、AMS)提供了竞品难以复制的企业级集成深度。TUI 安装向导是同类产品中独有的极低门槛部署体验。
竞争风险
- RAGFlow(70K stars)在深度文档理解上更成熟,自研引擎的控制力更强
- Dify(114K stars)生态更完善,社区更大,功能范围更广
- 对 Langflow 的强依赖意味着:Langflow 出问题 = OpenRAG 出问题
- 四容器资源开销高,小团队/个人用户可能望而却步
- IBM 企业战略调整可能影响开源投入
生态定位
IBM 云生态的 RAG 入口——开源版获客,IBM 云服务变现。在 RAG 赛道的定位是「企业级一站式方案」,与 RAGFlow(开发者优先)和 Dify(通用平台)形成三角竞争。
套利机会分析
- 信息差: 「三驾马车」预集成策略(组合 vs 自研)的技术路线对比在中文社区讨论不多。可以写一篇「RAG 平台:自研一切 vs 站在巨人肩膀上」——从 OpenRAG vs RAGFlow 的架构选择看开源 RAG 的两条路径
- 技术借鉴: ContextVar 认证传播(27 行代码)可直接用于任何 FastAPI 多租户应用;动态 Embedding 维度探测可用于多模型 RAG 系统;MCP Tool 注册表模式(37 行)是构建 MCP Server 的最简实践
- 生态位: 填补了「Langflow 强大但需自行搭配搜索引擎和解析器」的空白,是 Langflow 从框架走向产品的桥梁
- 趋势判断: 企业级 RAG 需求真实存在。IBM 背书提供了长期投入保障,但 3 月单月 3,375 stars 的爆发增长(占总量 92%)是否可持续需要观察
风险与不足
- 增长模式存疑:3 月单月占总 stars 92%,属于「一波流」爆发,4 月前 6 天日均仅 7.5——后续增长可持续性待验证
- 稳定性问题:多个 open bug 涉及核心功能——长时间运行 Docling 失效(#1139)、OpenSearch 503(#1170)、AWS 连接失败(#1217)
- 四容器资源开销高:OpenSearch 需 1G+ JVM 堆内存,整体最低配置远高于 RAGFlow/Dify 的单体或轻量方案
- Langflow 强依赖:每次 Chat 需经 Langflow HTTP 调用,引入额外延迟和故障点
- Python 3.13 最低要求:过于激进,限制了大量仍在使用 3.10/3.11 的企业用户
- main.py 职责过重:~500 行承担启动初始化、索引创建、JWT 密钥生成等多种职责
- 社区深度有限:企业团队主导,外部社区参与仍处早期
行动建议
- 如果你要用它: 最适合需要快速搭建企业 RAG 系统且已在 IBM 云生态中的团队。
uvx openrag或 Docker Compose 部署。如果更关注文档解析质量选 RAGFlow,如果需要更广泛的 AI 应用能力选 Dify,如果只要一个 RAG 框架选 LangChain/LlamaIndex - 如果你要学它: 重点关注三个核心设计——(1)
src/utils/auth_context.py(27 行 ContextVar 认证传播),(2)src/services/opensearch_service.py(动态 Embedding 维度探测 + 混合搜索),(3)src/tui/(基于 Textual 的终端安装向导)。flows/目录下的 4 个 Langflow 工作流 JSON 是理解 Agentic RAG 管道的好材料 - 如果你要 fork 它: 最有价值的方向:(1) 支持 Chroma/Milvus 等轻量向量数据库降低资源门槛;(2) 降低 Python 版本要求到 3.10;(3) 拆分 main.py 职责;(4) 增加 Connector 层集成测试
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | deepwiki.com/langflow-ai/openrag |
| Zread.ai | zread.ai/langflow-ai/openrag |
| 官网 | openr.ag |
| 官方文档 | docs.openr.ag |
| YouTube | youtube.com/@OpenRAG |
| 关联论文 | 无 |
| 在线 Demo | 无(需自部署) |