Vane 深度分析报告
一句话总结
Perplexity AI 的开源替代品——隐私优先的 AI 问答引擎,支持本地 LLM 和多云端提供商,通过 SearxNG 元搜索生成带引用来源的结构化回答,33K+ stars 领跑开源 AI 搜索赛道。
值得关注的理由
- 赛道绝对领导者:33.3K stars,是第二名 farfalle(3.5K)的 9.5 倍,在开源 AI 搜索引擎中定义了产品标准
- 架构设计有独到之处:自建 LLM 抽象层取代 LangChain(4 方法接口)、Block + JSON Patch 流式协议、Action Registry 插件化、三模式 Prompt 驱动差异化搜索深度
- 精准的市场定位:在 AI 搜索商业化浪潮中占据”隐私 + 自托管”的差异化生态位,持续有机增长
项目展示
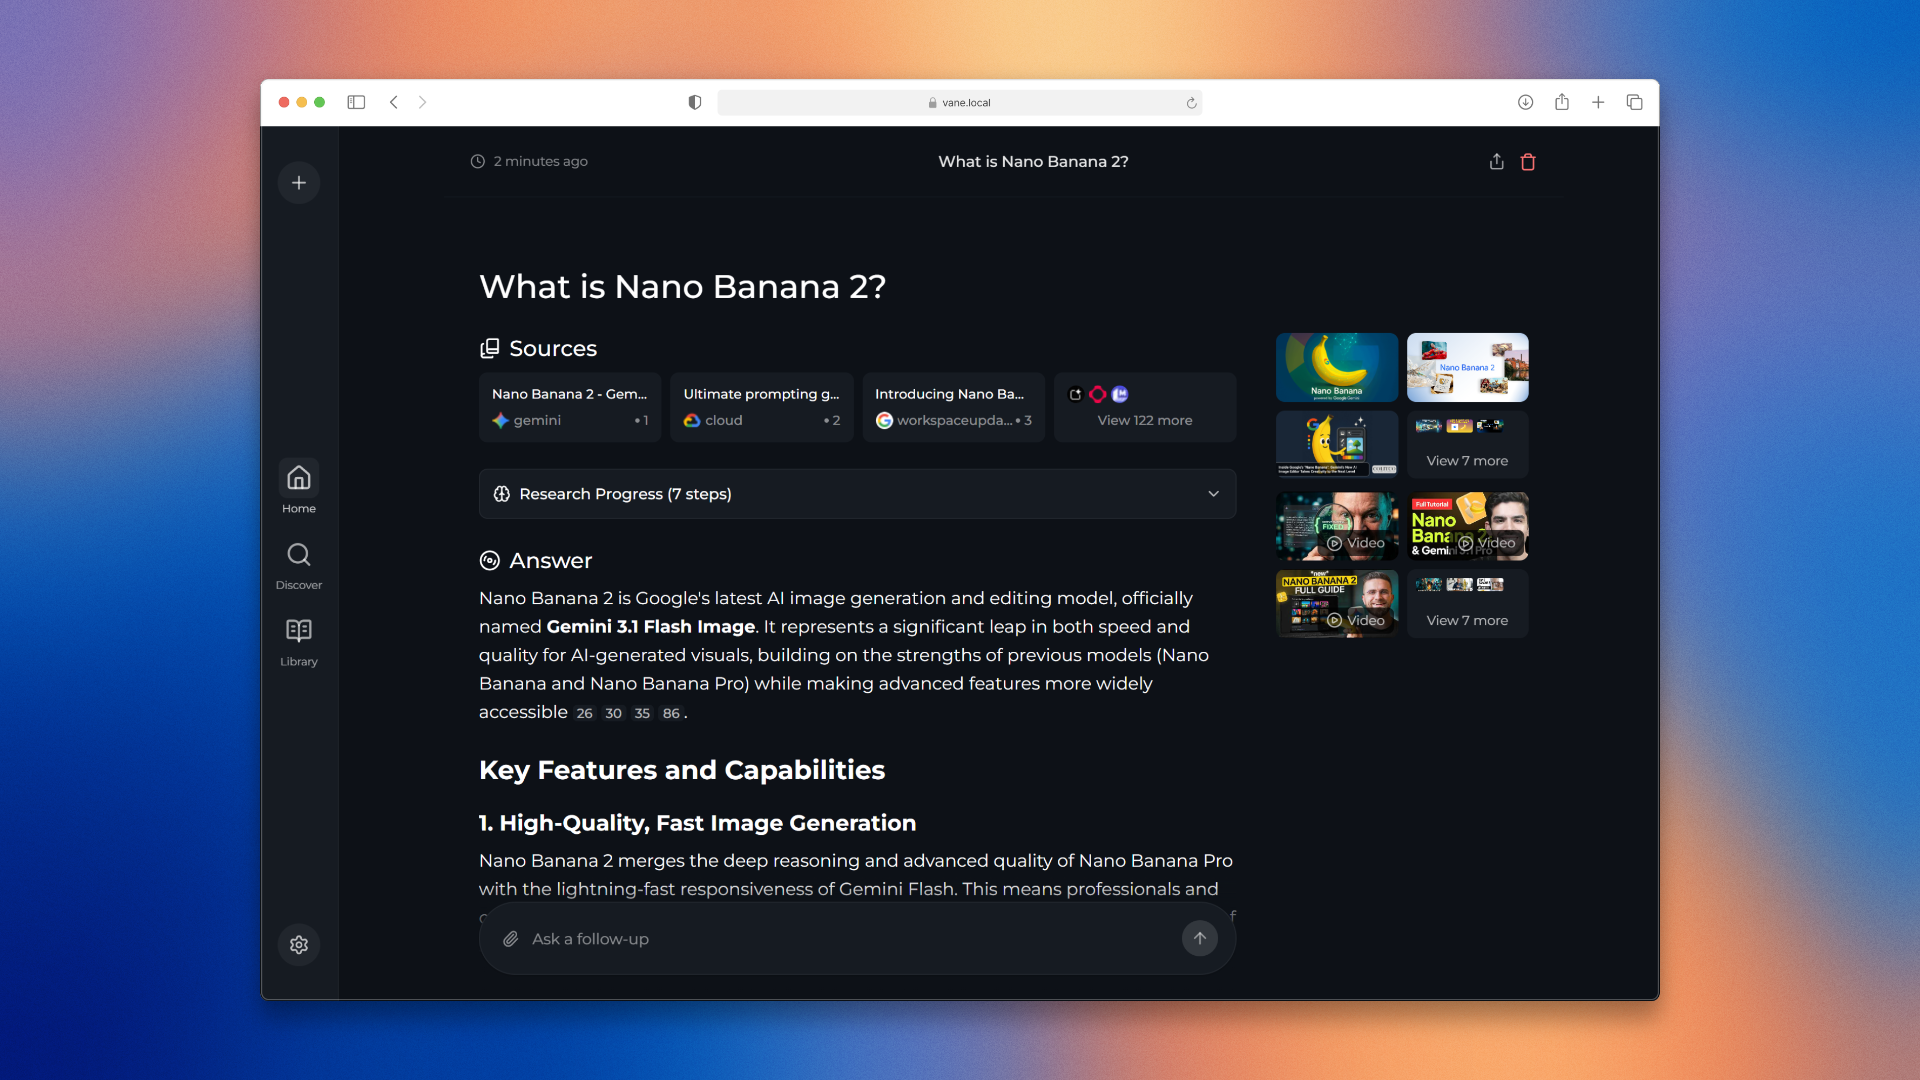 Vane 主界面——简洁的搜索对话界面,支持引用来源展示
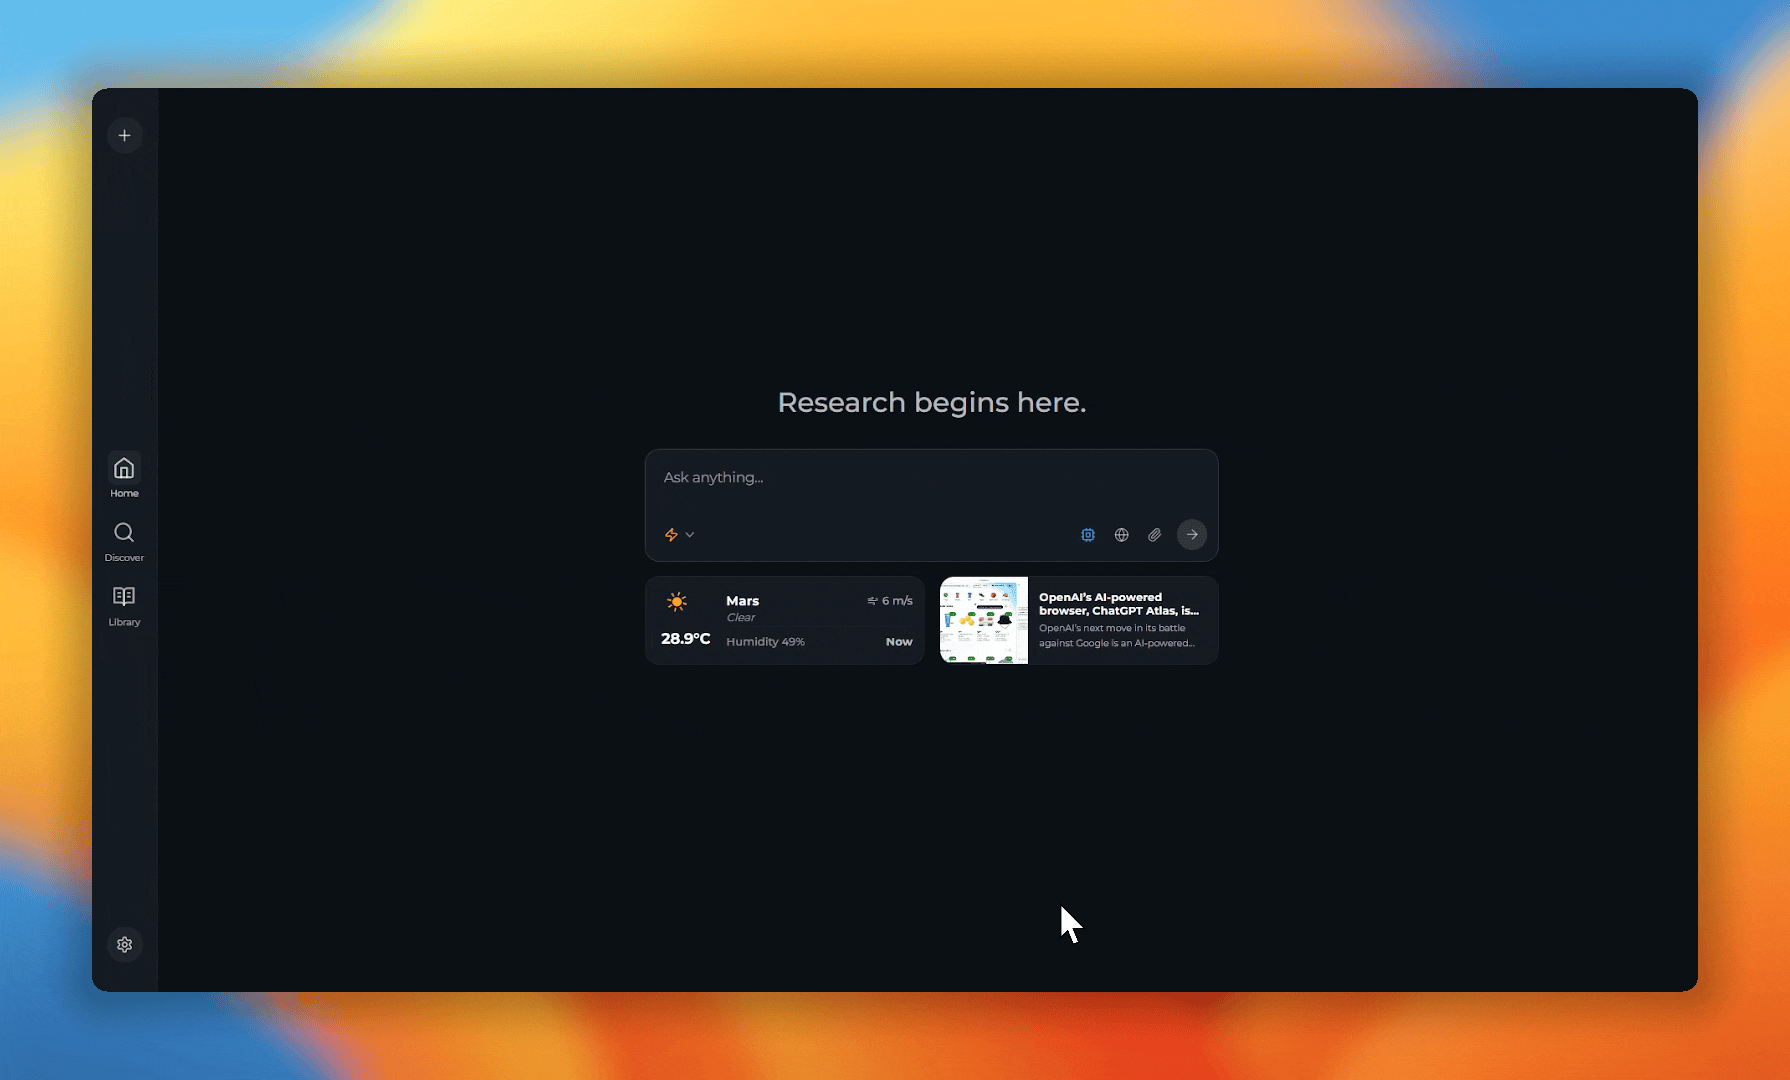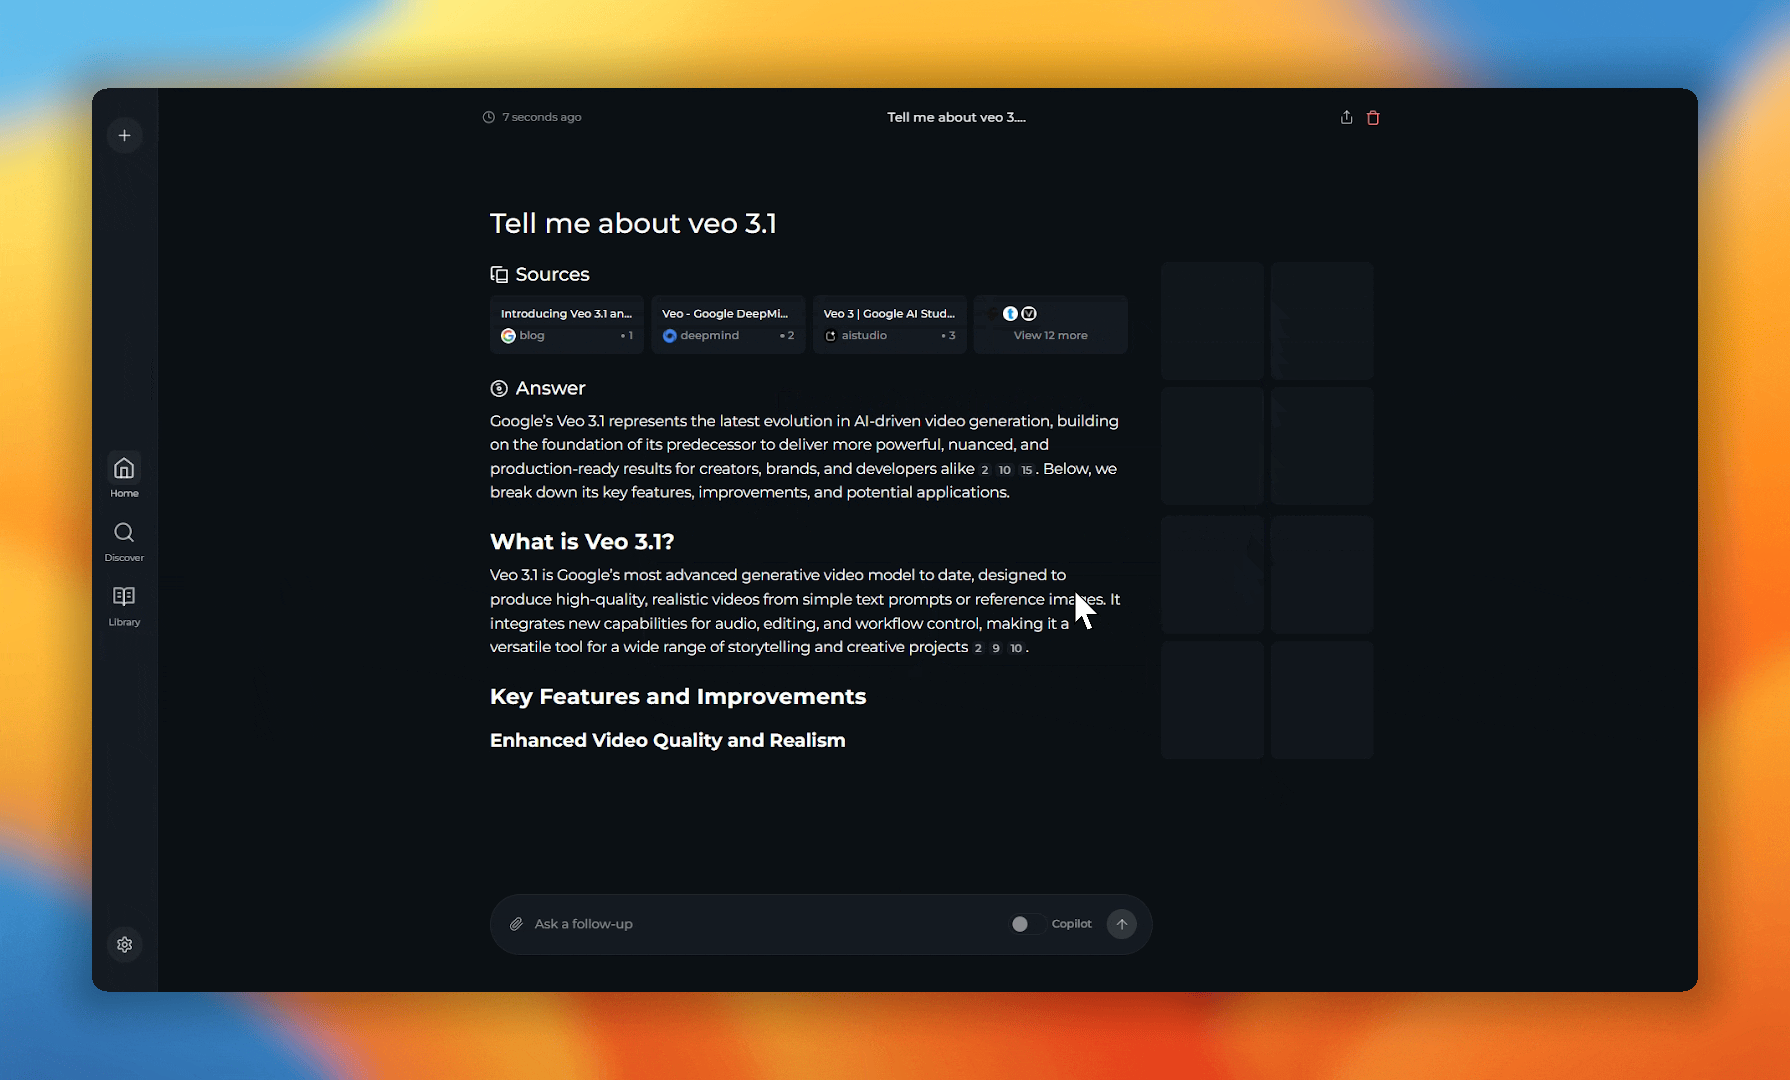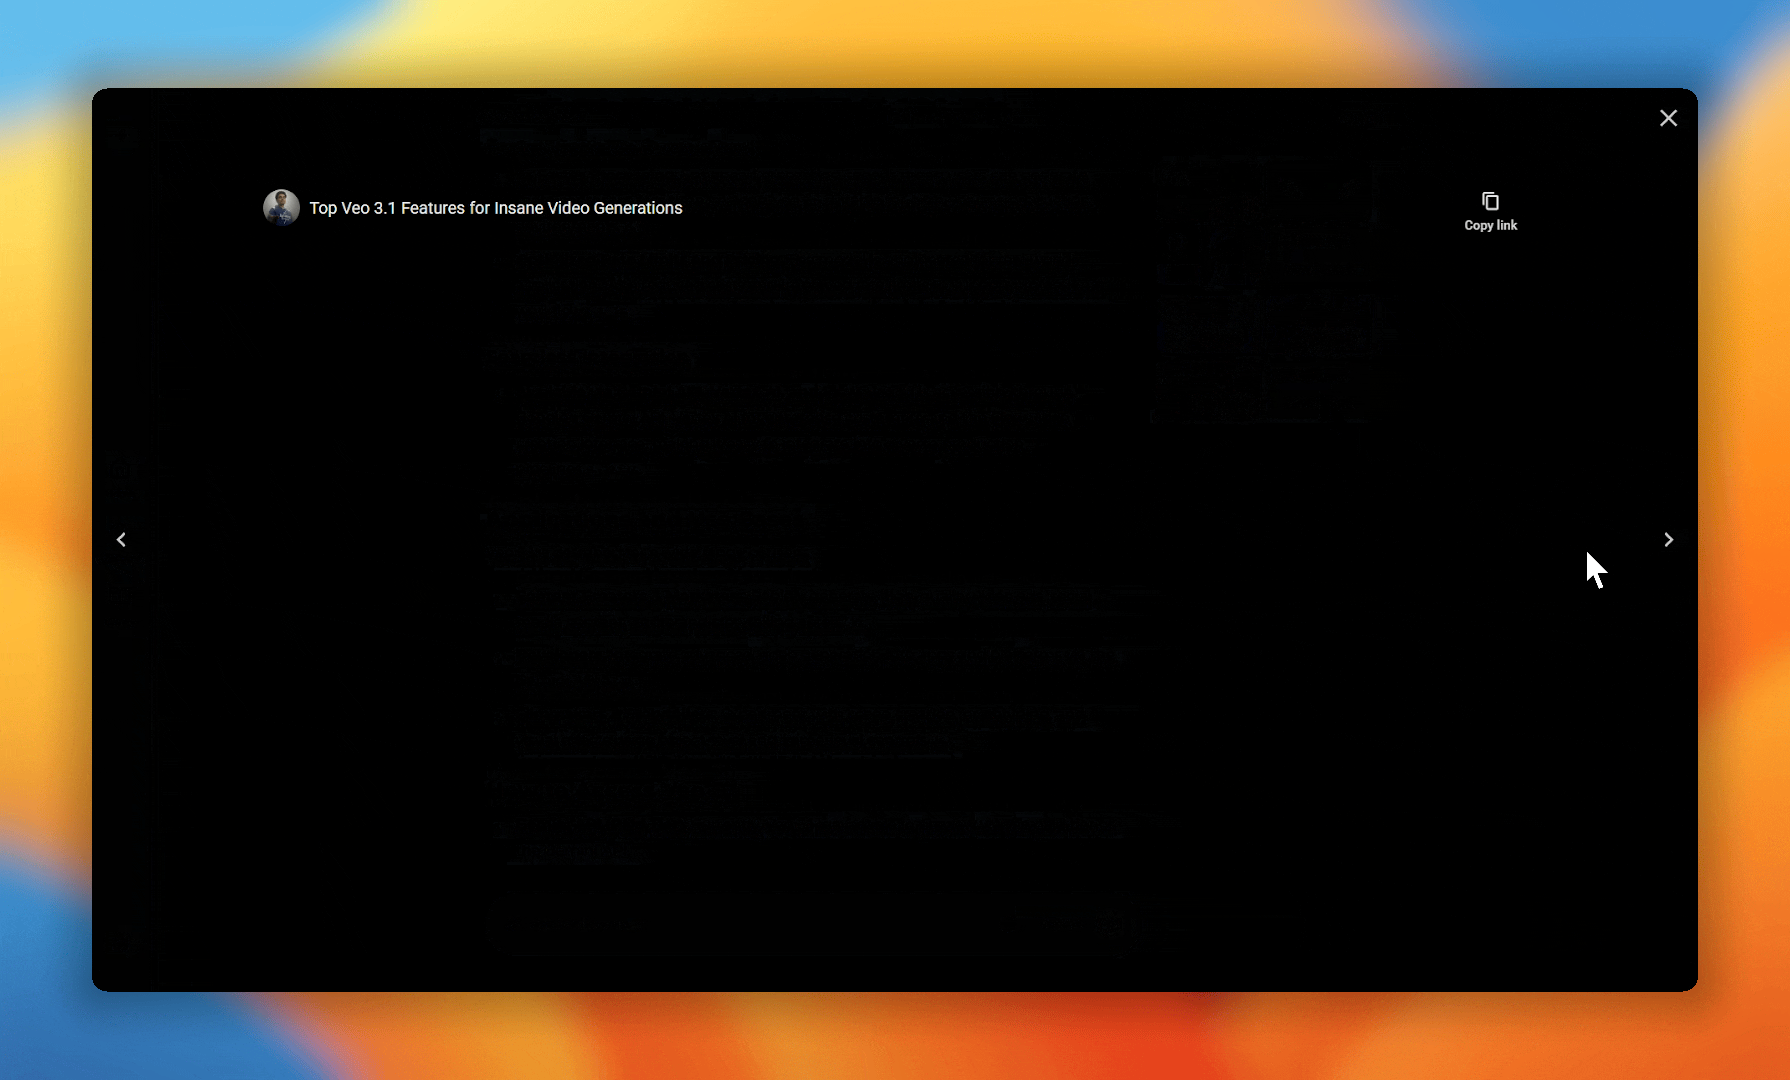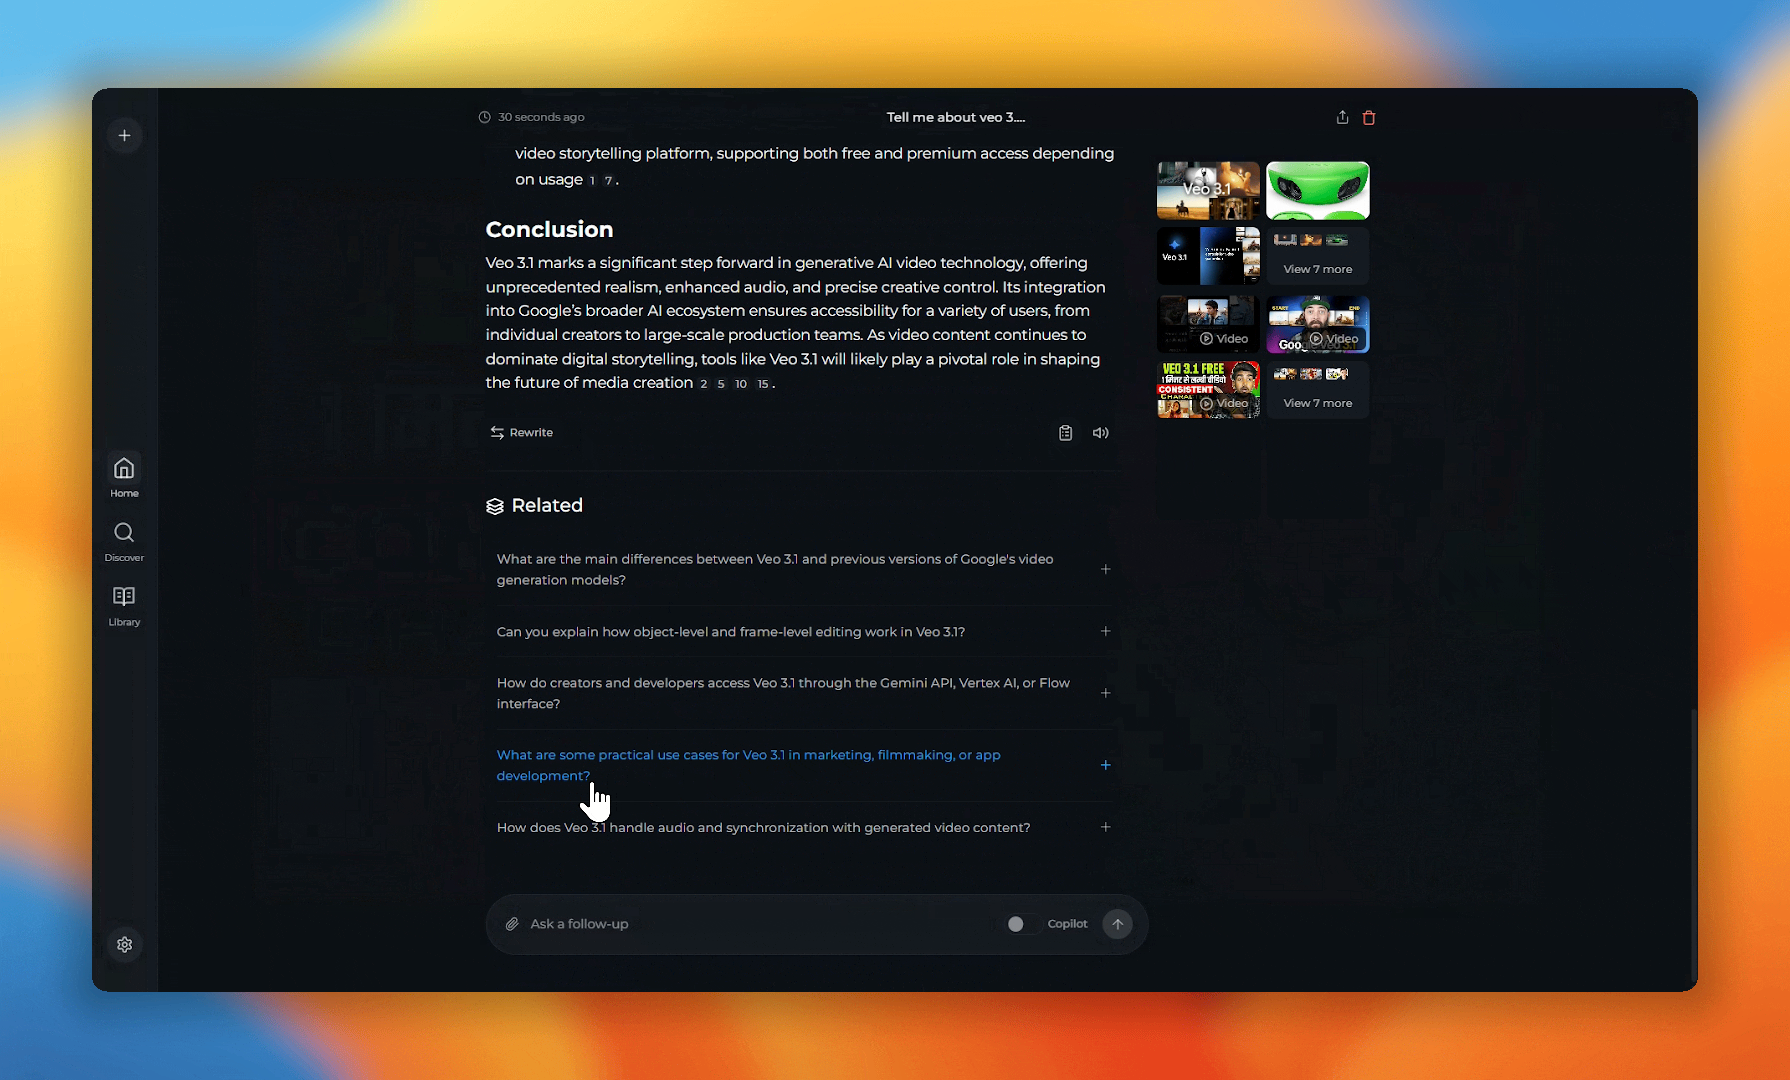 功能演示 GIF——展示搜索、引用、Widget 交互全流程
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/ItzCrazyKns/Vane |
| Star / Fork | 33,277 / 3,599 |
| 代码行数 | 21,477 行(TypeScript 70.6%,TSX、SVG、JSON 等) |
| 项目年龄 | 23 个月(首次提交 2024-04-09) |
| 开发阶段 | 稳定维护(2025 Q4 密集开发后,2026 Q1 明显减速) |
| 贡献模式 | 单人主导(ItzCrazyKns 占 90.4% commits,Bus Factor = 1) |
| 热度定位 | 大众热门(33K stars,开源 AI 搜索赛道绝对第一) |
| 质量评级 | 代码[良好] 文档[良好] 测试[无] |
作者视角:为什么存在这个项目
创始人/作者背景
Kushagra Srivastava(ItzCrazyKns),独立开发者,GitHub 注册约 4 年,760 粉丝,25 个公开仓库。Vane 是其唯一旗舰项目(33.3K stars),其余项目(Epoch、Deep-Research、KnowledgeFlow)均为 AI/LLM 方向,显示出对 AI 应用层的持续深耕。从 Perplexity AI 的使用体验中发现了”AI 搜索 + 隐私”的市场缺口。
问题判断
作者观察到三个关键洞察:(1) 搜索查询是最敏感的个人数据之一,Perplexity 等商业服务默认收集;(2) 搜索+LLM 的核心逻辑并不复杂,关键在于 orchestration 而非底层模型;(3) 自托管需求真实存在。时机恰好——2024 年 LLM API 成熟且成本下降,SearxNG 提供了现成的隐私搜索后端,Ollama 让本地 LLM 部署变得简单。
解法哲学
“功能完整 + 隐私优先 + 模型无关”:
- 选择功能对标 Perplexity(三种搜索模式、Widget、文件上传),而非极简方案
- 通过 SearxNG 隔离搜索身份,支持 Ollama 实现完全本地运行
- 自建 LLM 抽象层(移除 LangChain),4 方法接口支持 8 个提供商
- 明确不做:不做实时搜索索引、不做企业级权限管理、不做 SaaS
战略意图
纯粹的开源项目,MIT 协议,无商业化迹象。作者通过 GitHub Sponsors 接受赞助(Warp Terminal、Exa 为赞助商)。项目定位是”AI 搜索的开源标准实现”,战略路径是先做好搜索体验基本盘,再通过 Agent 化和插件化构建生态。
核心价值提炼
创新之处
-
__reasoning_preamble伪工具实现思维链可视化(新颖度 4/5 | 实用性 4/5 | 可迁移性 5/5) 将 Agent 推理步骤注册为伪工具调用,LLM 在每次操作前先调用此工具说明计划,推理过程通过工具调用流式传输到前端。Speed 模式下完全禁用此工具实现零开销。 -
Widget 双通道输出(新颖度 3/5 | 实用性 5/5 | 可迁移性 4/5) 每个 Widget 返回
data(渲染给用户的结构化数据)和llmContext(注入给 Writer 的文本摘要),避免 LLM 重复 Widget 已展示的信息。 -
Block + JSON Patch 流式协议(新颖度 3/5 | 实用性 5/5 | 可迁移性 5/5) 使用 NDJSON over SSE 替代 WebSocket,通过
rfc6902JSON Patch 增量更新已有 Block,解决了 WebSocket 在反代/Docker 环境下的部署困难。 -
自实现 RRF 语义搜索(新颖度 2/5 | 实用性 4/5 | 可迁移性 4/5) 嵌入向量存为 JSON 文件,多查询结果使用 Reciprocal Rank Fusion(k=60)融合排序,无需向量数据库依赖。
-
Token-aware 文本分割(新颖度 2/5 | 实用性 4/5 | 可迁移性 5/5) 使用
js-tiktoken(cl100k_base)精确计算 token 数量进行分割,支持句子边界重叠。
可复用的模式与技巧
- Action Registry 插件模式:每个 Action 独立注册,支持
enabled(config)条件启用 +getDescription(mode)模式感知描述 +execute()执行,零耦合添加新能力 - 4 方法 LLM 抽象:
generateText/streamText/generateObject/streamObject四方法接口,比 LangChain 轻量 10x,Anthropic/Gemini 继承 OpenAI 仅一行代码 - 分类-研究-撰写三阶段管道:意图分类→Agent 循环收集信息→LLM 生成带引用回答,Widget 与研究并行执行
- Mode-driven Prompt:Speed(2轮)/Balanced(6轮)/Quality(25轮) 通过完全不同的 Prompt 驱动,而非简单调参
- 配置自动发现:启动时扫描环境变量自动创建提供商实例,同时支持 Web UI 动态配置
- 会话事件回放:
SessionManager缓存所有已发射事件,断线重连时先回放历史再注册实时监听,30 分钟 TTL
关键设计决策
- 移除 LangChain(PR #950):自建 4 方法 LLM 抽象层,避免框架版本绑定和 breaking changes。牺牲了 LangChain 生态的现成工具,换来架构独立性和更精细的控制。
- NDJSON over SSE 替代 WebSocket:解决了反代/Docker 环境下 WebSocket 连接不稳定的部署痛点(Issue #572/#357),牺牲了双向通信能力,换来了零配置的部署兼容性。
- SearxNG 作为搜索后端:元搜索引擎聚合多个搜索引擎结果且不暴露用户身份。牺牲了搜索质量的一致性(依赖上游引擎可用性),换来了隐私保护。
- SQLite 嵌入式数据库:Drizzle ORM + 手写迁移,零外部依赖。牺牲了多实例共享数据的能力,换来了单容器部署的简洁性。
竞品格局与定位
竞品对比矩阵
| 维度 | Vane | Perplexity AI | farfalle | Morphic | Scira |
|---|---|---|---|---|---|
| 部署模式 | 自托管 | SaaS | 自托管 | 自托管 | 自托管 |
| 搜索后端 | SearxNG | 自建 | Tavily/SearxNG | Tavily | |
| LLM 支持 | 8 个提供商 | 自建 | 有限 | 有限 | 有限 |
| 搜索深度 | 2-25 轮 Agent 循环 | Speed/Pro | 单轮 | 单轮 | 单轮 |
| Widget | 天气/股票/计算 | 全品类 | 无 | 动态 UI | 无 |
| 文件上传 | PDF/DOCX/TXT | Pro 功能 | 无 | 无 | 无 |
| Stars | 33.3K | N/A | 3.5K | ~5K | ~3K |
差异化护城河
- 品牌护城河:原名 Perplexica 直接关联 Perplexity,已建立”开源 AI 搜索 = Vane”的心智认知
- 功能完整度:三模式搜索 + Widget + 文件上传 + 8 个 LLM 提供商,是最接近 Perplexity 功能集的开源方案
- 社区规模:33K stars + Discord 社区,远超所有开源竞品
竞争风险
- Perplexity 降价/开放 API:如果 Perplexity 推出免费层或开放 API,自托管的动机会减弱
- Open WebUI 生态扩展:Open WebUI 通过插件机制逐步覆盖搜索场景,可能蚕食通用 AI 搜索需求
- Bus Factor = 1:单人维护的 33K star 项目,如果作者倦怠或转向其他项目,社区可能快速衰退
生态定位
在 AI 搜索生态中扮演”自托管隐私替代品”角色,填补了 Perplexity(商业 SaaS)和通用 LLM 前端(Open WebUI)之间的空白——既有专业的搜索体验,又保持了数据主权。
套利机会分析
- 信息差: 无。33K stars 已广为人知,但项目 2026 Q1 开发节奏骤降(月提交从 157 降到 9),关注其可持续性。
- 技术借鉴: Action Registry 插件模式、4 方法 LLM 抽象、Block + JSON Patch 流式协议、
__reasoning_preamble伪工具思维链可视化——这些模式可直接用于构建任何 AI Agent 应用。 - 生态位: “隐私 AI 搜索”需求持续存在,但市场天花板有限。真正的机会在于将 Vane 的架构模式提取并应用到更广阔的 AI Agent 场景。
- 趋势判断: AI 搜索赛道竞争加剧,但自托管/隐私需求是长期趋势。项目面临的最大风险不是竞品,而是维护者倦怠。
风险与不足
- 零测试覆盖:没有任何测试文件(.test.ts/.spec.ts),没有 Jest/Vitest 配置,重构风险极高
- Bus Factor = 1:单人贡献 90.4% 代码,2026 Q1 活跃度骤降至个位数,可持续性存疑
- CI 仅含 Docker 构建:无 lint、无测试、无类型检查步骤,代码质量无门禁保障
- 搜索质量不稳定:依赖 SearxNG 元搜索,结果质量取决于上游引擎可用性
- 无向量数据库:文件搜索使用 JSON 存储嵌入向量,大规模文档场景存在性能瓶颈
- 部分代码质量问题:stockWidget 434 行含大量重复代码,注释率仅 2.0%
行动建议
- 如果你要用它: Docker 一键部署体验最优,适合个人/小团队自托管 AI 搜索。配置 Ollama 可实现完全本地运行。注意 SearxNG 搜索质量不如直连 Google/Bing,如果搜索质量是硬需求,考虑替换为 Tavily/Exa API。
- 如果你要学它: 重点关注
src/lib/agents/search/下的三阶段管道架构、src/lib/models/base/的 LLM 抽象设计、src/lib/session.ts的 Block 流式协议。架构文档在docs/architecture/README.md。 - 如果你要 fork 它: (1) 添加测试覆盖(至少核心 Agent 循环和 Block 序列化);(2) 引入向量数据库替换 JSON 存储;(3) 消除 Widget 代码中的重复(stockWidget 可抽象出通用金融数据 Widget 基类);(4) 添加 i18n 支持。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/ItzCrazyKns/Vane |
| Zread.ai | https://zread.ai/ItzCrazyKns/Vane |
| 关联论文 | 无 |
| 在线 Demo | 无(需自托管部署) |