ColPali 深度分析报告
一句话总结
用视觉语言模型 + ColBERT late interaction 替代 OCR pipeline,直接从文档图像生成多向量表示进行检索——视觉文档检索赛道的开创者和事实标准(ICLR 2025)。
值得关注的理由
- 范式创新:彻底绕过 OCR/版面解析,用 VLM 直接理解文档图像进行检索,在 ViDoRe 基准上超越所有传统文本检索方法
- 学术+工程双重价值:ICLR 2025 顶会论文,同时是可 pip 安装的生产级 Python 库,10+ 模型变体持续迭代
- 生态领先:下游项目丰富(ColiVara/Byaldi/Morphik/VARAG),Qdrant/Milvus/Weaviate 均已集成,定义了 ViDoRe 评估基准
项目展示
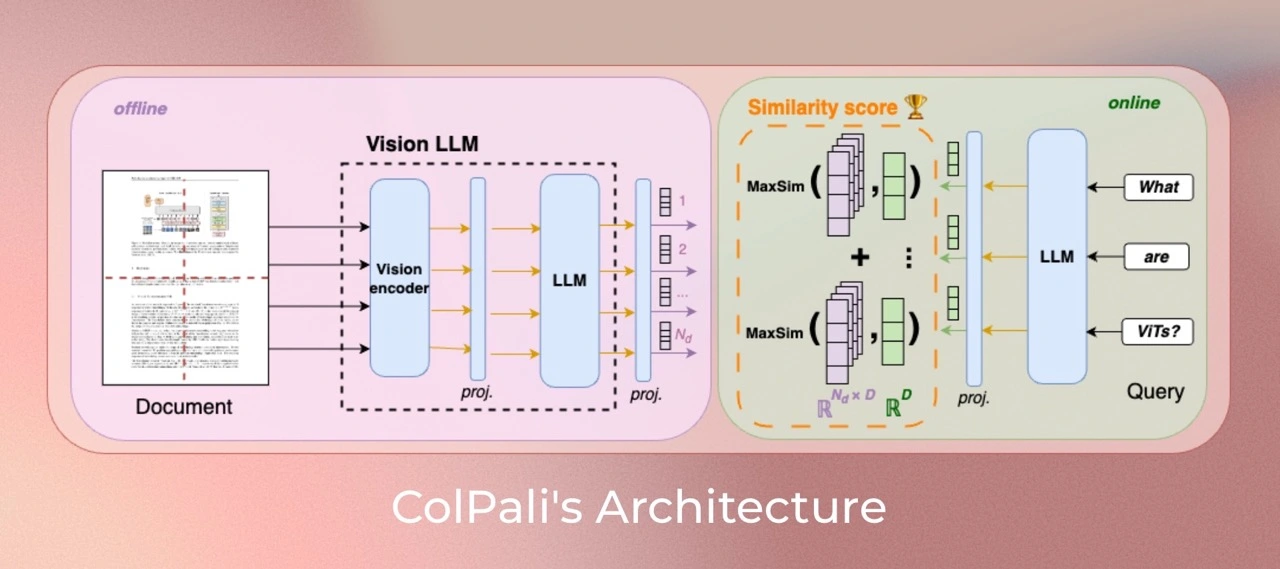 ColPali 核心架构:VLM 处理文档图像生成 patch 嵌入,通过 late interaction (MaxSim) 与查询匹配
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/illuin-tech/colpali |
| Star / Fork | 2,564 / 242 |
| 代码行数 | 11,690 (Python 90%, YAML 8.5%) |
| 项目年龄 | 21 个月 |
| 开发阶段 | 成熟稳定期(v0.3.x,20 个版本发布) |
| 贡献模式 | 小团队主导(2 名核心贡献者 + 29 名社区贡献者) |
| 热度定位 | 中等热度(2,564 Stars,细分领域标杆) |
| 质量评级 | 代码[优秀] 文档[优秀] 测试[充分] |
作者视角:为什么存在这个项目
创始人/作者背景
ILLUIN Technology 是巴黎的 AI 技术公司(2017 年成立),专注企业文档智能处理。核心贡献者 Tony Wu(CentraleSupelec/剑桥 MLMI)和 Manuel Faysse(NLP PhD)具有扎实的学术背景。团队在企业文档处理场景中深刻体会到 OCR pipeline 的痛点:脆弱、复杂,且丢失视觉信息。
问题判断
传统文档检索依赖 OCR + 版面分析的多阶段 pipeline,将文档转为文本后再检索。这条链路有三个根本问题:(1) OCR 错误会级联传播;(2) 表格、图表、排版等视觉信息完全丢失;(3) pipeline 复杂度高,难以维护。时机精准:2024 年 VLM(PaliGemma、Qwen2-VL 等)能力成熟,使得”直接从图像理解文档”成为技术可行。
解法哲学
“视觉优先,极简设计”:
- 选择了 late interaction:在 VLM 骨干上仅加一个
nn.Linear(hidden_size, 128)投影层,通过 MaxSim 实现 ColBERT 式检索。极简到令人惊讶——核心创新不在代码复杂度,而在将 ColBERT 的 late interaction 思想迁移到视觉空间 - 选择了多模型支持:不绑定单一 VLM,支持 9 种骨干(PaliGemma/Qwen2/2.5/3/3.5/Omni/Gemma3/Idefics3/ModernVBERT)
- 明确不做:不做端到端 RAG pipeline(交给 Byaldi/ColiVara 等下游),不做向量数据库(交给 Qdrant/Milvus),专注做检索模型层
战略意图
ColPali 是 ILLUIN Technology 在视觉文档检索领域的学术品牌和技术护城河。通过 ICLR 2025 论文建立学术声望,通过 ViDoRe 基准掌握评估话语权,通过 PyPI 包和 HuggingFace 集成获取开发者用户。商业化路径可能通过 ILLUIN 的企业文档智能产品实现。
核心价值提炼
创新之处
-
ColBERT Late Interaction 的视觉空间迁移 — 新颖度 5/5 | 实用性 5/5 | 可迁移性 4/5 将 ColBERT 的 late interaction(MaxSim:查询 token 与文档 token 逐一计算最大相似度后求和)从文本空间迁移到视觉 patch 空间。VLM 输出的每个 patch embedding 成为一个”视觉 token”,与查询的文本 token 进行 late interaction。这是论文的核心贡献。
-
12 种损失函数的训练工具箱 — 新颖度 4/5 | 实用性 5/5 | 可迁移性 5/5 6 种 Late Interaction 损失 + 6 种 Bi-encoder 损失:in-batch negative、hard negative、center loss、contrastive softmax、distillation loss、scored hard negative 等。每种都支持 LI 和 Bi 两种变体,构成完整的对比学习训练工具箱。
-
相似度热力图可解释性 — 新颖度 4/5 | 实用性 4/5 | 可迁移性 3/5 利用 late interaction 的逐 token 相似度矩阵,将查询与文档 patch 的匹配关系可视化为热力图,直观展示模型”在看哪里”。这是 late interaction 架构的独有优势。
-
层次聚类 Token 池化压缩 — 新颖度 4/5 | 实用性 4/5 | 可迁移性 4/5 通过层次聚类(hierarchical clustering)将文档 patch tokens 池化到更少的”聚类中心”,减少 66.7% 存储,保留 97.8% 检索性能。解决了多向量表示的存储成本问题。
可复用的模式与技巧
- “骨干 + 投影层” 极简微调模式:在预训练 VLM 上仅加
nn.Linear投影层,冻结或轻量微调骨干。对任何需要将预训练模型适配到特定表示空间的场景都适用 - 多骨干注册表模式:通过抽象基类
BaseColModel+ 具体实现(ColPali/ColQwen2/ColIdefics3 等)+ 类名注册,实现运行时动态选择模型骨干。9 种骨干共享训练和推理逻辑 - Loss 的 LI/Bi 双变体工厂:每种对比学习损失函数同时支持 Late Interaction 和 Bi-encoder 两种评分方式,通过
score_type参数切换,代码复用度极高 - HuggingFace 生态深度集成:模型权重托管在 HuggingFace Hub(vidore 组织),支持
from_pretrained()加载,Processor 兼容 HuggingFace 标准接口
关键设计决策
- Late Interaction vs Bi-encoder:选择 ColBERT 式 late interaction 而非单向量 bi-encoder,获得了更细粒度的匹配能力(每个 patch 独立参与匹配),代价是索引存储更大(每个文档存 1024 个 128 维向量)。项目同时提供 Bi 变体作为轻量替代
- 不自建训练框架:训练逻辑直接继承 HuggingFace Trainer,仅覆写
compute_loss。简洁但灵活性受限 - 文档作为图像而非文本:核心设计决策——放弃 OCR 的信息提取,以”图像理解”替代”文本解析”。trade-off 是对纯文本文档可能不如传统方法
竞品格局与定位
竞品对比矩阵
| 维度 | ColPali | VisRAG (OpenBMB) | ViDoRAG (Alibaba) | ColiVara | Byaldi |
|---|---|---|---|---|---|
| 定位 | 检索模型库 | 无解析 RAG | 视觉文档 RAG | SaaS 搜索服务 | 简化 API |
| Stars | 2,564 | 939 | 646 | 1,476 | 845 |
| 论文 | ICLR 2025 | EMNLP 2025 | EMNLP 2025 | 无 | 无 |
| 模型数 | 10+ 变体 | 单模型 | 单模型 | 基于 ColPali | 基于 ColPali |
| 基准 | 定义 ViDoRe | 使用 ViDoRe | 使用 ViDoRe | — | — |
| 关系 | 原点 | 竞品 | 竞品 | 下游 | 下游 |
差异化护城河
- 评估基准定义权:ViDoRe 基准由 ColPali 团队创建和维护,竞品都在其上评测
- 模型矩阵广度:9 种 VLM 骨干 × 2 种变体(Col/Bi),竞品只有单一模型
- 生态原点效应:ColiVara、Byaldi、Morphik 等都是基于 ColPali 构建的下游项目
- 学术信任:ICLR 2025 顶会论文,被 300+ 论文引用
竞争风险
- VisRAG/ViDoRAG 在特定数据集上可能超越 ColPali 的某些变体,但目前未能撼动 ColPali 的生态地位
- 大公司(Google/OpenAI)可能推出集成视觉检索的商业 API,降低开源方案的竞争力
- 传统 OCR pipeline 在纯文本文档上仍有优势
生态定位
ColPali 在视觉文档检索生态中占据”模型层”的核心位置:上游是 VLM 骨干(PaliGemma/Qwen2-VL),下游是应用封装(ColiVara/Byaldi)和向量数据库集成(Qdrant/Milvus/Weaviate)。类比 sentence-transformers 之于文本检索的地位。
套利机会分析
- 信息差: 中等——2,564 Stars 在 AI 领域不算高,但在视觉文档检索这个快速增长的细分赛道中已是标杆。了解 late interaction 机制的人远少于了解 bi-encoder 的人
- 技术借鉴: ColBERT late interaction 的视觉迁移思路、分层奖励损失设计、层次聚类压缩可直接用于其他多模态检索场景
- 生态位: 填补了”无 OCR 的视觉文档检索”空白,处于 VLM 和 RAG 应用之间的关键中间层
- 趋势判断: 稳步增长(月均 50-80 新 Star),符合”视觉优先 RAG”的技术趋势。随着 VLM 能力提升,ColPali 的价值会进一步放大
风险与不足
- 多向量存储成本:每个文档页面需存储 1024 个 128 维向量,相比单向量方案存储成本高约 1000 倍(虽有池化压缩可降至 1/3)
- 推理延迟:VLM 处理文档图像的推理成本高于文本 embedding,不适合实时高并发场景
- 纯文本文档劣势:对于无视觉元素的纯文本文档,传统文本检索方法可能更优
- 代码注释稀少:代码/注释比 14.7:1,新贡献者理解核心逻辑需要参考论文
- 单一公司主导:虽有社区贡献者,但核心架构决策由 ILLUIN Technology 2 名研究者主导
行动建议
- 如果你要用它: 首选方案——当你的文档包含大量表格、图表、扫描件时,ColPali 显著优于传统 OCR pipeline。通过
pip install colpali-engine快速开始,推荐 ColQwen2.5 作为默认模型。如果存储敏感,使用 token 池化压缩。纯文本场景考虑传统方案 - 如果你要学它: 重点关注
colpali_engine/models/下的基类BaseColModel和具体实现(理解多骨干架构)、colpali_engine/loss/下的 12 种损失函数(理解对比学习变体)、colpali_engine/interpretability/下的热力图模块(理解 late interaction 可解释性) - 如果你要 fork 它: 可改进方向——(1) 添加混合检索模式(视觉 + 文本双路检索);(2) 优化多向量压缩(PQ/SQ 量化);(3) 支持视频帧检索场景;(4) 增加代码注释和架构文档
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 已收录 |
| Zread.ai | 已收录 |
| 关联论文 | ColPali: Efficient Document Retrieval with Vision Language Models (ICLR 2025) |
| 在线 Demo | HuggingFace Space |
| 官方博客 | HuggingFace Blog |
| ViDoRe 排行榜 | HuggingFace Space |