为什么 1.7 万行代码能拿 2 万 star?RAG-Anything 只补了多模态这一层
一句话总结
RAG-Anything 是港大数据智能实验室(HKUDS)的「All-in-One 多模态 RAG 框架」——让 RAG 不只读文本,还能读懂文档里的图片、表格、公式。它的精妙在于站在两个巨人肩上:把文档解析整段外包给 MinerU(66.8K star),把图谱检索整段外包给自家 LightRAG(36K star),自己只写夹在中间最薄但最关键的「模态 → 实体 → 双图谱融合」那一层抽象。结果是仅 16.8K 行代码却撬动 21K star,由 LightRAG 原班人马(zrguo = Zirui Guo + PI Chao Huang)打造、arXiv 2510.12323 背书、DocBench benchmark 63.4%(比基座 LightRAG +5pp)。MIT、PyPI raganything、持续活跃迭代。
值得关注的理由
- 一个「工程经济学」的范本——不发明轮子,只缝接缝:RAG-Anything 自己几乎不写解析、不写图索引、不写向量库、不写检索。
modalprocessors.py里BaseModalProcessor直接抓取 LightRAG 的存储句柄(text_chunks/chunks_vdb/entities_vdb/relationships_vdb/chunk_entity_relation_graph)并from lightrag.operate import extract_entities, merge_nodes_and_edges;解析则通过ParserABC + 运行时注册表把 MinerU/Docling/PaddleOCR 抹平成统一content_list契约。它真正自研的只有「把一张图/一张表/一个公式变成可索引知识实体」的那层桥接——这正是 1.7 万行撬动 2 万 star 的答案。 - 几个可直接抠走的工程范式:① 非文本资产 → LLM 结构化卡片 → 当文本实体索引——图走 VLM+base64、表/公式走 LLM,统一返回
{detailed_description, entity_info}JSON,写成 chunk 进向量库 + 写成节点进图谱;② 资产作 hub + 反向归属边构图——把模态描述再喂extract_entities抽二级实体,用高权重belongs_to边回挂,把「图里画了什么」与「正文讲了什么」缝成一张图;③ 4 级 JSON 鲁棒解析 + thinking 标签剥离(_robust_json_parse代码块→括号配平→渐进引号修复→正则抽字段,处理 R1/Qwen 推理前言污染);④ 检索返回引用 → 运行期 hydrate 成多模态 prompt(先文本检索拿图片路径,再读盘 base64 重组问 VLM)。 - 客观看待「卖点 vs 现实」:多模态 RAG 是热门叙事,但 benchmark 绝对值 DocBench 63.4% / MMLongBench 42.8% 说明这条赛道本身尚未成熟——离生产级「可靠回答」仍有距离。热门 Issue 全是「图片分析不准」(#70)、「DocBench 63.4% 怎么复现」(#235)、「文档处理卡住 / DocProcessingStatus TypeError」(#49/#73/#91)——既印证它被严肃使用,也暴露多模态解析可靠性、强依赖 MinerU、对 LightRAG 内部 API 强耦合漂移的真实成本。
项目展示
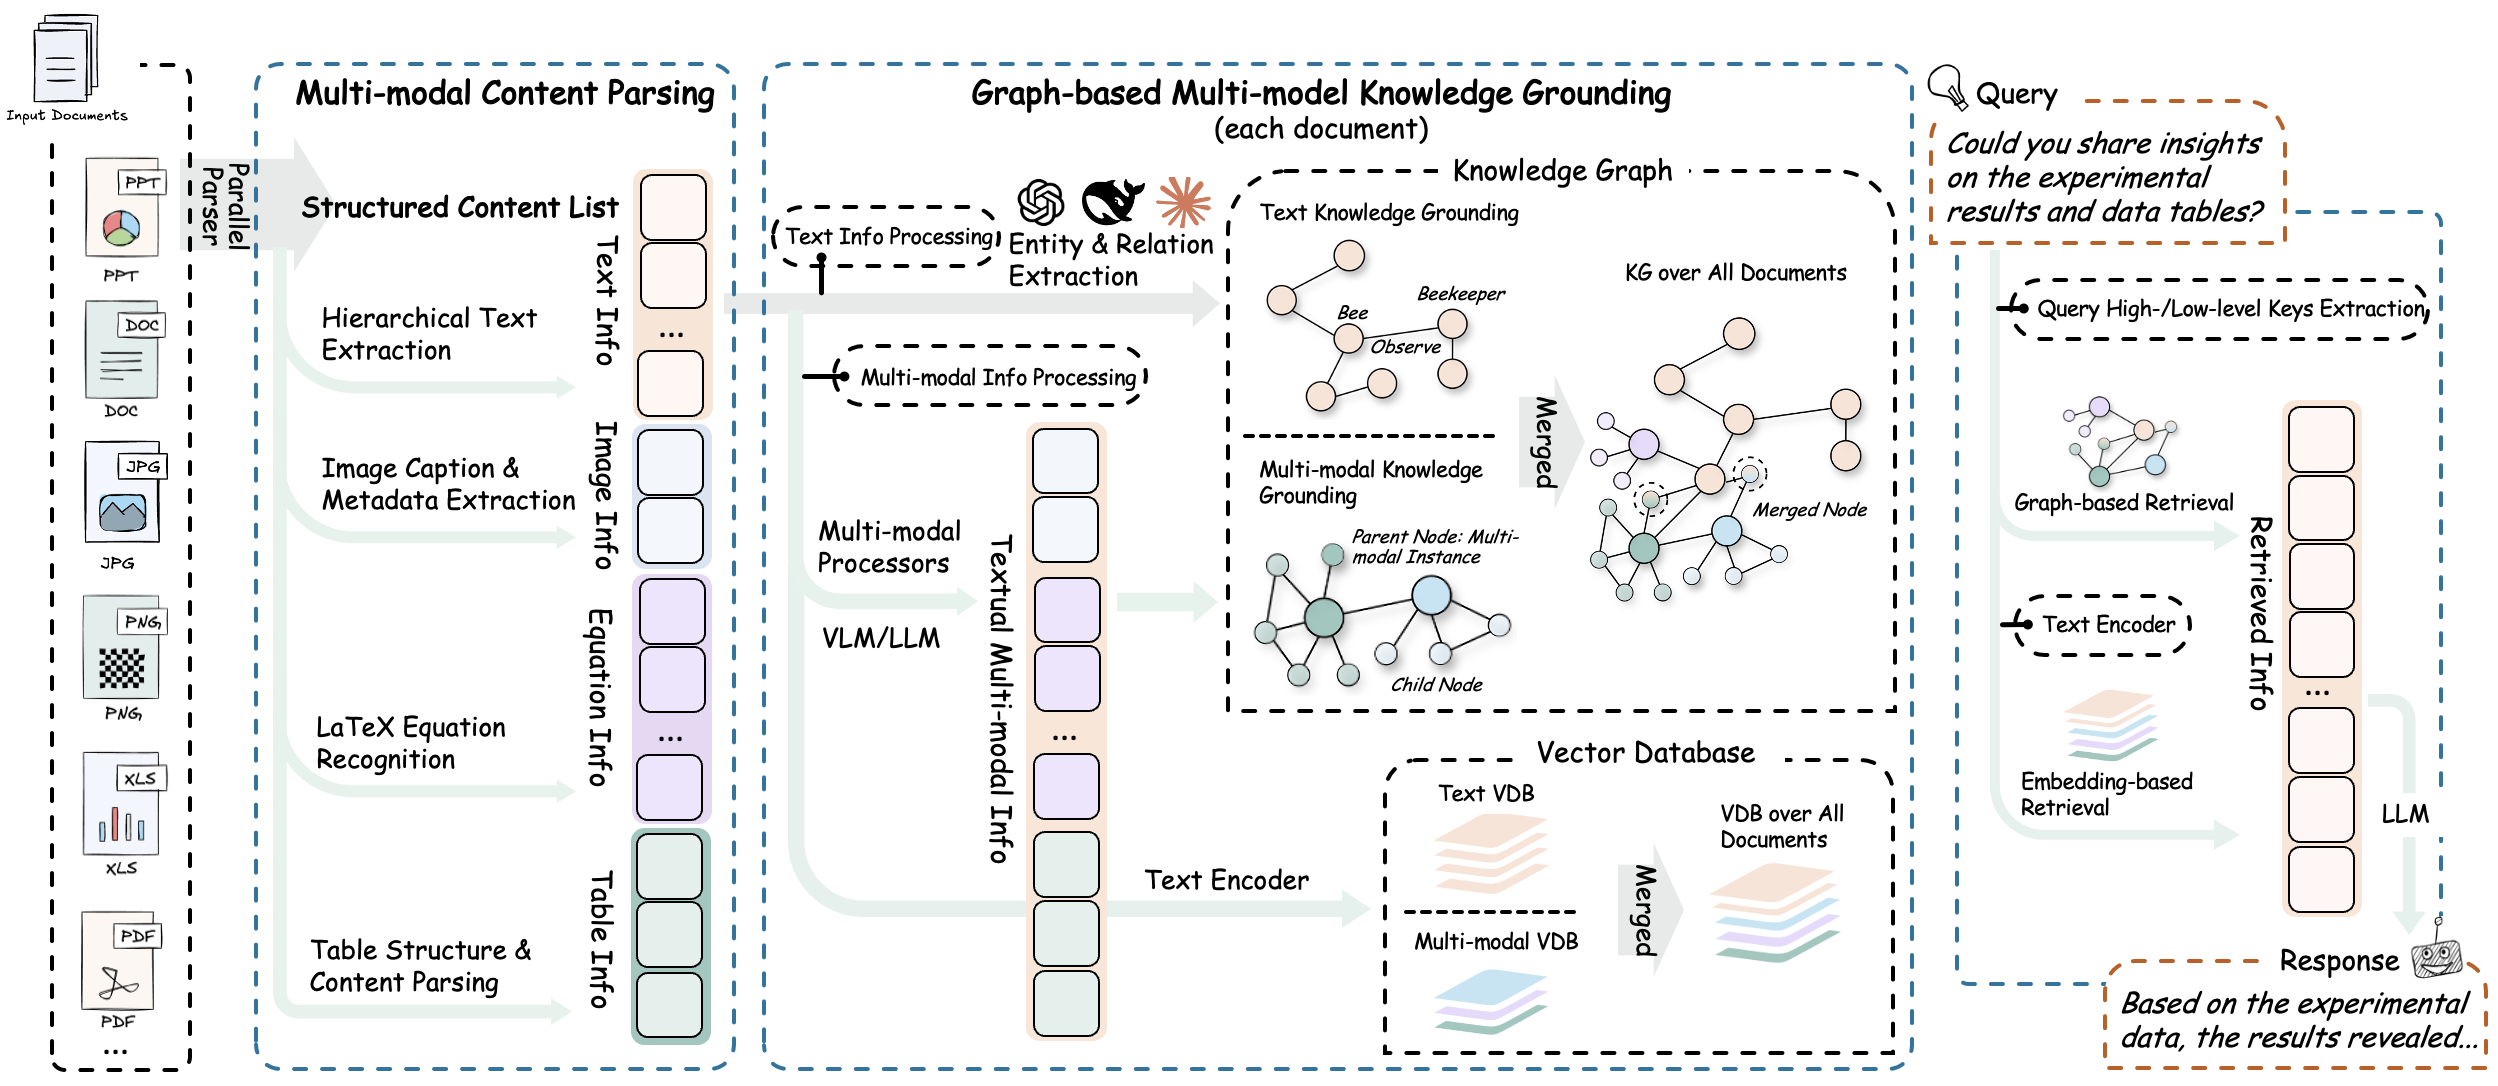
架构图一图说清「站在 LightRAG 肩上做多模态」的五阶段管线:文档 → 解析(MinerU/Docling)→ 模态分离 → 双图谱构建融合 → 跨模态混合检索 → VLM 合成答案。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/HKUDS/RAG-Anything |
| Star / Fork | 21,019 / 2,448(fork/star ≈11.6%,远高于纯演示项目,说明被当生产组件集成) |
| 代码行数 | 16,850 行(Python 99.5%);仅 51 文件;行内注释比 0.073 但 docstring 充分(整体 ≈0.167) |
| 项目年龄 | 12 个月(2025-06-06 起,最后提交 2026-06-02,持续活跃无停滞) |
| 开发阶段 | 密集开发(近 90 天 116 commit;三段式曲线:开局猛冲 → 长尾打磨 → 2026 春季二次发力) |
| 贡献模式 | 学术实验室团队 + 社区(48 贡献者,zrguo=LightRAG 作者占 ~48%;PI chaohuang-ai 亲自提交;有 copilot-swe-agent bot;周末 16%/深夜 17% = 白天职业作息) |
| 热度定位 | 大众热门 · 爆发型(被 Milvus 官博/36Kr 等列为默认推荐多模态 RAG 框架) |
| 版本 | v1.3.1(19 tag/release,月均 1.5 版,SemVer,PyPI raganything、uv ready) |
| License | MIT |
| 质量评级 | 代码组织/文档/CI/错误处理「★★★★☆」· 测试「★★★☆☆(22 测试文件 ~4.3K 行,但核心算法深度单测偏薄)」 |
作者视角:为什么存在这个项目
创始人/作者背景
HKUDS(港大数据智能实验室,PI Chao Huang)——「Anything 系列」明星学术厂牌:nanobot 43.8K、CLI-Anything 42.3K、LightRAG 36.3K、RAG-Anything 21K、AI-Trader 19.4K。关键血缘信号:git 头号贡献者 zrguo(Zirui Guo,~48% 提交)正是 LightRAG 的作者,PI Chao Huang(chaohuang-ai)亲自下场提交,论文作者署名与仓库 Top 贡献者高度重合——这不是营销号攒的项目,是 LightRAG 原班人马的多模态延续作。协作健康(核心少数 + 社区 PR + copilot bot)。
问题判断
现代文档(论文、财报、技术手册)是图文表式混排——文字之外还有图表、公式、流程图。传统纯文本 RAG(含基座 LightRAG)在解析阶段就把这些非文本模态丢弃或降级成 OCR 噪声,导致「文档里最关键的那张实验结果图 / 性能对比表 / 核心公式」在检索和回答时彻底缺席。作者是在把 LightRAG 推向真实文档时撞上这个天花板:图索引/双层检索做得再好,解析层一旦把图表公式扔掉,下游再强也无米下炊。RAG-Anything 本质是「为 LightRAG 补上多模态前端」的产物。
解法哲学(薄抽象层 + 站在 LightRAG 肩上)
核心哲学是「重活外包给巨人,自己只做接缝处的薄抽象」:向上游把文档高保真抽取整段委托给 MinerU/Docling/PaddleOCR(自己只定义统一 content_list 契约);向下游把图索引/向量库/检索整段复用 LightRAG 的存储实例与算子。raganything.py 主类 646 行里绝大部分是生命周期/配置/初始化,真正自研的只有夹在中间的「模态 → 实体」那一层。
战略意图
HKUDS 的「论文驱动开源」打法——LightRAG、VideoRAG、MiniRAG、RAG-Anything 成系列,每个配 arXiv,用学术信誉 + 厂牌为 star 背书。生态互喂:RAG-Anything 既是 LightRAG 的下游应用,又是其多模态特性的「孵化器」——孵化成熟的能力被反向合并回 LightRAG,二者协同演进。明确「不做什么」:不做 RAGFlow 式产品化平台(坚持做「库」)、不做 GraphRAG 式重型纯文本图谱(靠 LightRAG 基座保持轻量)。
核心价值提炼
创新之处
- 模态实体化 + 双图谱 belongs_to 融合(新颖度 4/5,实用性 4/5,可迁移性 4/5):把图/表/公式经 VLM/LLM 描述后建成图谱 hub 节点,再用
extract_entities在描述上抽二级实体并以高权重belongs_to边回挂(weight=10.0),实现 cross-modal KG 与 text KG 的轻量融合。适用任何要把非文本资产纳入知识图谱检索的系统。 - 可插拔解析后端 + BYO-Parser 注册表(新颖度 3/5,实用性 5/5,可迁移性 5/5):
ParserABC + 运行时register_parser/get_parser,统一content_list契约把 MinerU/Docling/PaddleOCR/自定义解析器抹平,配置层parser="mineru"一行切换。 - VLM 增强检索(检索后回读图像)(新颖度 4/5,实用性 4/5):先文本检索拿到图片路径,运行期再读盘 base64 重组多模态 prompt 问 VLM(含路径安全白名单
validate_image_file),按需付出视觉算力。 - LLM 输出鲁棒化(4 策略 JSON 解析 + thinking 标签剥离)(新颖度 2/5,实用性 5/5,可迁移性 5/5):
_robust_json_parse四级降级 +_strip_thinking_tags处理 R1/Qwen 推理前言污染图谱。适用任何依赖 LLM 返回结构化 JSON 的生产系统。 - OMML → LaTeX 抽取(新颖度 3/5,实用性 3/5):
omml_extractor.py递归把 DOCX 的 Office Math XML 转成可检索 LaTeX,补 MinerU 偏 PDF、DOCX 公式抽取的短板。
可复用的模式与技巧
- ABC + 字符串注册表 + 统一中间表示(IR):
Parser基类 +content_list契约——任何「一个接口多后端」场景(解析器/嵌入器/存储/LLM provider)。 - 非文本资产 → LLM 结构化卡片 → 当文本实体索引:
generate_description_only范式——把任意模态桥接进纯文本 RAG/图谱。 - 资产作 hub + 反向归属边构图:
belongs_to高权重边把派生实体挂回源资产——异构知识图谱轻量融合。 - 两阶段批处理(先纯生成、后攒批合并):
generate_description_only与merge_nodes_and_edges解耦、batch_mode开关——攒批昂贵的写/合并操作。 - retry/async_retry 装饰器(退避 + jitter + 可配异常):
resilience.py——可直接抠走用于任何外部 API 调用。 - 检索返回引用 → 运行期 hydrate 成多模态 prompt:
aquery_vlm_enhanced——agentic/多模态 RAG 通用招式。
关键设计决策
最值得记录的是 「模态 → 实体 → 双图谱融合」这层自研薄抽象——它是整个项目的护城河所在。BaseModalProcessor 及其 Image/Table/Equation/Generic 四子类,每个 generate_description_only 调 modal_caption_func(图走 VLM+base64,表/公式走 LLM),提示模型返回 detailed_description + entity_info{entity_name, entity_type, summary} 的 JSON;再 _create_entity_and_chunk 把描述写成 chunk(进向量库)、把实体卡片写成图谱节点。关键的融合一步在 _process_chunk_for_extraction:把模态描述再喂给 LightRAG 的 extract_entities 抽出二级文本实体,然后对每个二级实体 upsert_edge 一条指向模态实体的 belongs_to 关系(weight=10.0),最后 merge_nodes_and_edges 融合进主图——模态实体由此成为高权重 hub,把「图里画了什么」与「正文讲了什么」缝在一起。这个设计的 Trade-off 很诚实:融合靠固定高权重边而非真正的语义对齐/实体消歧,是工程实用主义;且模态价值被「VLM 一次性描述」压缩——描述不准则全链路失真(这正是 #70「图片分析不准」的根因),每个模态项至少 1 次 VLM + 1 次抽取 LLM 调用,成本/延迟随模态密度线性上升。
主类架构:
RAGAnything(QueryMixin, ProcessorMixin, BatchMixin)dataclass——Mixin 拆分四块职责并共享self.lightrag/config/modal_processors,主类只管生命周期(懒初始化 LightRAG + parse_cache、三场景事件循环清理 #135)。
竞品格局与定位
关键对照轴:纯文本 vs 多模态、单一解析 vs 端到端、KG-RAG vs 向量 RAG、库 vs 产品。
| 项目 | Stars | 定位 | 与 RAG-Anything 关系 |
|---|---|---|---|
| LightRAG | 36.3K | 轻量 KG-RAG 引擎(基座) | 同源父子非竞品:RAG-Anything 复用其图索引/双层检索/增量更新,只加多模态前端;成熟能力反向合并回 LightRAG,二者互喂 |
| GraphRAG (Microsoft) | 33.5K | 图谱 RAG 范式开创者 | 偏纯文本、社区摘要重、构建成本高、无原生多模态;微软背书、全局聚合推理更强 |
| RAGFlow (infiniflow) | 82.1K | 深度文档理解 RAG 引擎 | 最直接正面竞争(都主打文档密集):RAGFlow 是产品(UI/部署/租户,开箱即用),RAG-Anything 是库(要自己写 LLM/embedding/VLM 函数,77 依赖 + LibreOffice,上手摩擦大) |
| LlamaIndex / Haystack | 50K / 25.5K | 通用 RAG 框架 | 生态全但不专精;KG-RAG/多模态需自行拼装,非端到端多模态方案 |
| MinerU / Docling | 66.8K / 61.1K | 文档解析层 | 上游依赖非竞品(RAG-Anything 的解析后端) |
差异化护城河
①「模态 → 实体 → 双图谱融合」那一层自研薄抽象(别人很难简单复刻这层语义接缝);② LightRAG 血统 + 学术论文 + HKUDS 厂牌带来的信任与流量放大。在「多模态 KG-RAG」这个细分格里,它是学术血统最纯正、论文背书最硬的一个。
竞争风险
- 强依赖 MinerU 解析质量——是福(外包重活、站在巨人肩上)也是命门(解析烂则全链路烂)。
- 多模态 RAG 赛道本身未成熟——DocBench 63.4% 离生产级可靠仍有距离(#235 复现咨询印证「被严肃使用但有落差」)。
- 对 LightRAG 内部 API 强耦合——
pyproject.toml锁lightrag-hku<1.5,内部算子签名一变就漂移(#49/#73/#91 的 TypeError 即此类耦合代价)。 - RAGFlow 产品化体验对非开发者更友好;bus factor:zrguo 占 ~48% 提交。
生态定位
LightRAG 生态的「多模态特性孵化器 + 下游应用」,与基座互喂,而非独立赛道选手。工程成熟度/产品完整度不及 RAGFlow,通用性不及 LlamaIndex,但在「可编程嵌入 + 图谱式多模态 + 已用 LightRAG」的交叉点独占。
套利机会分析
- 信息差:RAG-Anything 具备稀缺的叙事张力——① 1.7 万行 vs 2 万 star 的反差(「为什么这么少代码这么多 star」);② 「站在巨人肩上做对的那层抽象」的工程哲学;③ 多模态 RAG「卖点 vs 现实」的客观张力。中文圈对「模态实体化双图谱融合」「可插拔解析」「站在 LightRAG 肩上的工程经济性」拆解稀缺。
- 技术借鉴:ABC+注册表多后端、非文本资产→LLM 卡片→文本实体、资产 hub+归属边构图、4 级 JSON 鲁棒解析、retry 装饰器、检索后 hydrate 多模态 prompt——这些可迁移到任何 RAG/知识图谱/LLM 结构化输出系统。
- 生态位:填补「多模态 KG-RAG 库」空白;与 LightRAG 互喂、与 RAGFlow 错位(库 vs 产品)。
- 趋势判断:踩在「多模态 RAG + 知识图谱 + 文档智能」趋势上;长期看「MinerU 解析质量提升 + 多模态准确率突破 + 与 LightRAG 解耦」决定其上限。
风险与不足
- MinerU 依赖即命门:解析质量决定全链路,非自身代码健壮性可消化。
- 多模态准确率现实:DocBench 63.4% 未达生产可靠,图理解准确率是头号痛点(#70)。
- 对 LightRAG 强耦合:锁
<1.5、直接调内部算子,API 漂移风险未隔离(#49/#73/#91)。 - 测试深度偏薄:虽有 22 测试文件 ~4.3K 行 + 多版本矩阵 CI,但核心抽取/merge/融合逻辑的确定性深度单测不足(强依赖外部 LLM/解析器难做确定性测试)。
- 依赖/配置摩擦:77 runtime 依赖 + LibreOffice 外部程序,上手「跑不通/卡住」高频。
- bus factor:zrguo 占 ~48% 提交,单点依赖明显。
行动建议
- 如果你要用它:适合处理富混排文档(学术研究/技术文档/财报/企业知识库)、要可编程嵌入图谱式多模态 RAG、或已用 LightRAG 想原地升级多模态的开发者(提供
load existing LightRAG instance路径)。注意先配好 MinerU、准备好 VLM 函数、容忍 63.4% 量级的多模态准确率现实。要开箱即用产品(UI/部署)的团队更适合 RAGFlow。 - 如果你要学它:直奔
raganything/modalprocessors.py(模态→实体→双图谱融合,护城河所在)+parser.py(可插拔 Parser ABC + 注册表)+query.py(VLM 增强检索 + 4 级 JSON 解析)+raganything.py(Mixin 薄编排器)+resilience.py(retry 装饰器)+ arXiv 2510.12323(双图谱方法 + benchmark)。体量小(16.8K 行),适合通读学习「如何站在巨人肩上做对一层抽象」。 - 如果你要 fork / 借鉴它:ABC+注册表多后端、非文本资产实体化、资产 hub+归属边、4 级 JSON 鲁棒解析、retry 装饰器是可直接迁移的设计。MIT 友好;但注意它与 LightRAG 内部 API 的强耦合,跨组织复用别人内部算子风险高。
知识入口
| 资源 | 链接 |
|---|---|
| arXiv 论文 | https://arxiv.org/abs/2510.12323 《RAG-Anything: All-in-One RAG Framework》(方法 + DocBench/MMLongBench benchmark 一手来源) |
| DeepWiki | https://deepwiki.com/HKUDS/RAG-Anything(已收录,覆盖三层架构/核心类/五阶段管线/多解析后端,代码级导读首选) |
| 基座项目 | LightRAG:https://github.com/HKUDS/LightRAG(理解图索引/双层检索/增量更新的底座能力) |
| 安装 | pip install raganything(PyPI;uv ready;另需 MinerU 解析后端 + 可选 LibreOffice) |
| 社区 | Discord:https://discord.gg/yF2MmDJyGJ |