Google Magika:用 1MB 深度学习模型取代 file 命令,文件类型识别 F1 从 88% 升到 99%
GitHub: https://github.com/google/magika
一句话总结
Magika 是 Google 安全研究团队出品的 AI 文件类型检测工具——用一个约 1MB 的 ONNX 小模型、单 CPU 毫秒级识别 200+ 内容类型,平均 F1 约 99%,全面超越用了几十年的 libmagic/file 命令(尤其在 C/JS/CSV 这类无字节签名的文本类型上),并已在 Gmail、Google Drive、VirusTotal 等每周处理数千亿份文件。
值得关注的理由
- 十余年缺乏范式革新的赛道被一次性改写:文件类型检测长期被
file/libmagic、TrID、exiftool 等「手写字节签名」工具占据,文本类型基本靠猜(F1 约 88% 量级)。Magika 用「内容驱动的深度学习分类」实现代差级精度领先(F1 约 99%),是「下一代 file 命令」。 - 真实超大规模生产背书:不是 demo 项目——已落地 Gmail / Drive / Safe Browsing(保护约 20 亿用户的附件扫描)、集成进 VirusTotal 与 abuse.ch/MalwareBazaar,且配有 ICSE 2025 论文(arXiv:2409.13768)。「先内部 battle-test 再开源」是其最强可信度信号。
- 工程拆解空间极大:恒定时间特征提取(只读文件头尾各 1KB,推理时间与文件大小无关)、per-content-type 阈值的保守降级、一份模型喂 4 种语言运行时、跨语言黄金测试集——这些是脱离文件检测场景也能直接复用的高质量工程模式。
项目展示
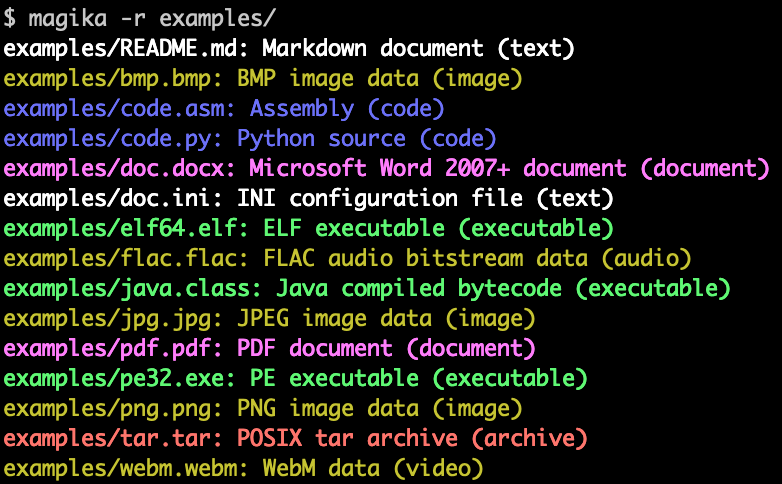 Magika CLI 输出:对各类文件给出类型、MIME、置信度。
浏览器本地运行的在线 Demo(JS/TF.js 实现):https://securityresearch.google/magika/demo/magika-demo/
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/google/magika |
| Star / Fork | 17,115 / 1,054 |
| 代码规模 | 真实约 1.25 万行四语言实现(Rust 4310 ≈ Python 4305 > TS 3179 > Go 681)+ 约 1MB ONNX/Keras 模型;JSON 占比 62.7% 是假象,98.7% 为 lock 文件 + 模型配置/权重 + 测试 fixtures,手写业务 JSON 近零 |
| 项目年龄 | 27.9 个月(2023-08 创建,2024-02 起外部高频开发) |
| 开发阶段 | 稳定维护(架构早已定型,近 30 天仅 2 commit,commit 以 chore/ci/deps 为主) |
| 贡献模式 | Google security research 团队(Yanick Fratantonio @reyammer 占 56.8%~64.9%,49 贡献者,核心少数+社区) |
| 热度定位 | 大众热门(高速增长,1.0 Rust 重写带来二次曝光) |
| 质量评级 | 代码[优] 文档[优] 测试[优·跨语言黄金向量] CI[优·19 workflow] |
作者视角:为什么存在这个项目
创始人/作者背景
项目由 Google 安全研究团队(securityresearch.google)主导,技术负责人是 Yanick Fratantonio(@reyammer)——Google 资深研究科学家,前 EURECOM 助理教授、Cisco Talos 安全研究员,30+ 篇同行评审论文,Black Hat / IEEE S&P 讲者;二号是 Luca Invernizzi。系统安全 + 深度学习交叉背景,是研究型而非纯工程团队主导。作者可信度极高(Google 官方 + 实名研究科学家 + ICSE 2025 论文 + 数千亿/周生产规模背书)。
问题判断
这是典型的「安全研究团队从生产痛点反推工具」:Gmail/Drive/Safe Browsing 每周要把数千亿文件路由到正确的安全/内容策略扫描器——路由错就意味着漏检或误杀。扩展名可伪造、magic number 覆盖不全且对文本类型几乎无能,于是把问题重构成「用一个分类器替代整套签名库」。代码里专设 current_missdetections/mitra(文件格式多态/混淆样本)目录,暴露作者真正关切的是对抗性、边界、易混淆样本。
解法哲学
四条强约束贯穿全代码:① 恒定推理时间——只读文件头尾各 4KB,绝不全量扫描(生产文件可能 GB 级,推理时间必须与大小解耦);② 小模型——约 1MB ONNX、单 CPU 约 2-5ms,可在关键链路同步跑、不需 GPU;③ 保守优先于激进(最能体现安全团队基因)——低置信时宁可返回 Generic text/Unknown binary 也不硬猜,因为误判一个具体类型在安全语境里比「诚实地说不知道」危险;④ 明确不做什么——不做内容抽取(让给 Tika),只判类型这一件事做到极致。
战略意图
开源策略清晰:论文(ICSE 2025)确立学术信誉 + 开源客户端确立事实标准 + 被 VirusTotal/Gmail 采用确立生产背书。但只开源了客户端和 4 语言绑定,模型训练管线未开源——护城河是「约 1 亿真实文件训练的模型」,这是 Google 独有的数据资产。2025-11 的 1.0 把 CLI 用 Rust 重写并通过 pip install magika 直接分发 Rust 二进制,是「卡位成为默认 file 替代品」的一步棋。
核心价值提炼
创新之处
- 恒定时间字节子采样特征化(新颖 4 / 实用 5 / 可迁移 5):从开头读 4KB、结尾读 4KB,对头部 lstrip、尾部 rstrip 去空白,各取 1024 字节,不足用
padding_token=256(刻意取在字节范围 0-255 之外,让 embedding 能区分真实字节与填充)补齐,最终恒为 2048 维定长向量。整个过程经Seekable抽象(只需size+read_at),绝不把整文件读进内存——推理时间与文件大小完全解耦。 - 保守降级:低置信回退粗粒度标签,且零额外 IO(新颖 4 / 实用 5 / 可迁移 5):利用「模型至少把二进制/文本这个大类分对了」的假设,低置信时不重读文件,
is_text→ 返回txt,否则unknown;并用overwrite_reason显式返回「为什么输出和模型原始预测不一致」。这是「安全优先」哲学的代码化。 - per-content-type 稀疏阈值 + 三档置信模式(新颖 3 / 实用 5 / 可迁移 5):只为约 12 个易混淆类型(latex 需 0.95、markdown 0.75 即可)配专属阈值,其余吃全局默认 0.5;three modes:best_guess(永远信模型)/ medium(≥0.5)/ high(≥类型专属阈值)。
- 约 1MB 模型达成 200+ 类、约 99% F1、单 CPU 毫秒级(新颖 4 / 实用 4 / 可迁移 2):证明「定制小模型 + 海量真实数据」可在精度和成本上同时碾压通用大模型与传统签名库(但强依赖 Google 约 1 亿文件数据资产,难复制)。
- 模型外化 + 4 语言异构消费(新颖 4 / 实用 4 / 可迁移 3):一份
assets/models/资产,Python 运行时加载(最灵活、可热切换模型)、Rust 用include_bytes!编译期嵌入(单文件零依赖分发)、JS 用 TF.js 从 CDN 加载、Go 用 cgo——每种策略贴合各自生态的分发惯例。 - 维护期代码生成(而非 build.rs)(新颖 4 / 实用 3 / 可迁移 3):Rust 端刻意避开构建脚本、在维护期把配置/KB 烘焙成编译期常量数组,以满足 Debian 等下游打包方的可信构建要求——安全意识渗透到工程细节。
可复用的模式与技巧
- 变长输入定长化模板:头尾子采样 + 越界 padding token + 边界去噪,可套用到日志/流量/协议分类。
- 廉价规则前置 + 昂贵模型兜底的分层短路:空/小/退化输入走规则,只有「内容充分」才进模型,控制推理成本。
- 置信度治理三件套:per-class 阈值 + 全局兜底阈值 + 低置信回退粗粒度标签,配
overwrite_reason做可解释输出。 - 稳定本体 + 易变模型词表 + 映射层:KB(353 类知识库,独立于模型)与模型标签空间(214 类)解耦,让模型可迭代而对外契约不变。
- 语言无关黄金向量 + 每语言对拍测试:
tests_data/reference/*.json.gz放特征/推理黄金值,4 种语言各有*_vs_reference测试对照同一夹具,用deny_unknown_fields防夹具漂移——多语言实现保持逐字节一致的最低成本机制。 - 模型即资产、各端按分发约束自选加载策略:运行时加载 vs 编译期嵌入 vs CDN。
- Seekable/SyncInput/AsyncInput 抽象:核心逻辑只依赖
size+read_at,文件/内存/流统一处理且天然不全量读入。
关键设计决策
- KB 与模型标签空间解耦:
content_types_kb.min.json是稳定的 353 类知识库(mime/group/描述/扩展名),独立于任何模型;每个模型 config 声明自己能输出的 214 类(含 randombytes/randomtxt 内部训练标签,经 overwrite_map 折叠成用户可见的 unknown/txt)。换模型时 KB 不动,只改模型目录。 - 跨语言一致性靠共享黄金测试集而非共享代码:4 套独立实现对照同一份压缩参考夹具断言,把 Python 参考实现设为「真值来源」——这是「同一规范多语言实现」(编解码器、协议栈、SDK)都应该抄的模式。
竞品格局与定位
竞品对比矩阵
| 维度 | Magika | file/libmagic | TrID | Apache Tika | guesslang |
|---|---|---|---|---|---|
| 路线 | 深度学习分类 | magic-number 签名 | 签名库 | 内容检测+抽取 | 深度学习(仅源码) |
| 平均 F1 | ~99% | ~88% 量级 | ~88% | — | ~77%(文本) |
| 文本类型 | 强 | 弱 | 弱 | 中 | 仅源码 |
| 推理时间 | 恒定(只读头尾) | 极快 | 快 | 重(JVM) | 较重 |
| 开源 | ✅ Apache2 | ✅ | ❌ 闭源 | ✅ | ✅ |
| 定位 | 类型判定 | 类型判定 | 类型判定 | 抽取为主 | 语言判定 |
差异化护城河
①约 1 亿真实文件训练数据(未开源,最深护城河);②「内容驱动 + 恒定时间 + 保守降级」的产品哲学组合;③Google 生产背书(Gmail/Drive/Safe Browsing/VT/abuse.ch)形成事实标准;④4 语言绑定 + 黄金向量一致性,降低任何语言栈的接入门槛。
竞争风险
- 模型训练管线闭源:社区无法独立改进模型,只能等官方放新版(#679 想当底层组件嵌入、#752 多平台打包等需求若响应慢会催生 fork)。
- 双运行时维护负担:TF.js(JS 端)与 ONNX(其余)并存增加长期维护成本。
- 结构性盲区:只读头尾的设计对「中段藏毒」对抗样本是结构性盲区,安全场景可能被针对(作者有意不读中段以保恒定时间)。
生态定位
定位为「下一代 file 命令」——传统签名工具的 ML 替代品 + 大规模安全管线的文件路由器。不与 Tika 等抽取工具直接竞争,而是站在它们上游做前置分流(Tika 可用 Magika 做前置路由)。
套利机会分析
- 信息差:项目已是 Google 官方光环 + 大规模采用,市面新闻稿式解读多。差异化要押在「ONNX 小模型 + 恒定时间特征工程 + per-type 阈值」这类一手技术拆解,而非复述「Google 又开源了个 AI 工具」。
- 技术借鉴:恒定时间特征化、保守降级、置信度治理三件套、跨语言黄金向量测试——这些脱离文件检测场景,对任何「变长输入分类」「多语言 SDK 共享模型」「分类器投产置信治理」都直接可抄。
- 生态位:填补「ML 驱动、生产级、跨语言的文件类型检测」空白,成为安全管线的事实标准前置组件。
- 趋势判断:稳定维护期、架构定型,作为「事实标准」的生命力强;增长靠 1.0 Rust 重写 + 持续生产采用。最大变数是社区对「模型闭源」的不满是否催生开源替代。
风险与不足
- 模型闭源:训练管线和数据不开源,社区只能消费不能改进模型。
- 结构性盲区:只读头尾,中段藏毒对抗样本是设计层面的盲区。
- 嵌入式场景仍偏向 libmagic:Magika 有约 1MB 模型 + 加载开销,极简/纳秒级场景下传统工具更优。
- 多平台打包复杂:CI 是头号热点(410 次改动),manylinux/跨语言分发是社区最高参与的工程痛点(#752)。
- 特征提取大量 assert + 魔法常数(min_file_size_for_dl=8 等),生产可被优化掉、可读性略受影响。
行动建议
- 如果你要用它:想要准确(尤其文本类型)、可量化置信度、可嵌入(4 语言绑定 + 约 1MB 模型)的文件类型检测——它是当前最佳选择,
pip install magika/brew install magika/cargo install magika-cli即可。极简/纳秒级/嵌入式场景仍可用 libmagic;要内容抽取请配 Tika。 - 如果你要学它:重点读
python/magika/magika.py(_extract_features_from_seekable恒定时间特征 +_get_output_label_from_dl_label_and_score阈值降级)、rust/lib/src/input.rs、rust/gen/(维护期代码生成)、tests_data/reference/(跨语言黄金向量)。这套「ML 工具投产工程」是脱离场景的通用财富。 - 如果你要 fork 它:方向不是重训模型(数据闭源难复制),而是把它的工程模式(恒定时间特征化、置信治理、黄金向量多语言对拍)搬到你自己的分类系统;或响应 #679 把它封成 C ABI 动态库供更多语言嵌入。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 已收录(四语言实现/架构/测试全套) |
| Zread.ai | 未确认(直连 HTTP 403) |
| 关联论文 | arXiv:2409.13768 — Magika: AI-Powered Content-Type Detection(ICSE 2025) |
| 在线 Demo | 浏览器本地运行 Demo |
| 包发布 | PyPI / npm / crates.io magika-cli / Homebrew |
| 官网 | https://securityresearch.google/magika/ |