LiteRT-LM:Google 把 Gemma 跑进手机和手表的端侧 LLM 引擎,NPU 加速超 llama.cpp
一句话总结
LiteRT-LM 是 Google AI Edge 团队(原 TensorFlow Lite / MediaPipe 班底)的生产级端侧 LLM 推理框架——建在 LiteRT(TFLite 2024 改名)之上,补齐 tokenizer、KV cache、采样、多轮会话、约束解码等 LLM 上层能力,把 Gemma/Gemini Nano 跑进 Chrome、Chromebook Plus、Pixel Watch 等真实产品;它最硬的技术在 NPU 多阶段加速与 .litertlm 单文件 mmap 格式。
值得关注的理由
- 端侧 LLM 的「工业派代表」,已真实出货:不是实验项目,而是 Google 把 Gemini Nano/Gemma 落地到 Chrome/Pixel Watch/AI Edge Gallery 的实战基础设施。官方称 Gemma 3 1B 在 Galaxy S25 Ultra 上 CPU/GPU 的 prefill+decode 均超 llama.cpp,NPU prefill 再快约 3x。
.litertlm单文件格式是优秀的模型分发工程:FlatBuffers 头 + 16KB 块对齐的 mmap section + 版本化 union 类型,把权重 + tokenizer + 配置打进一个文件,mmap 直接映射省内存、便于分发——「分发即一个文件」的产品化取舍。- 几个反直觉的工程决策值得学:用 cxx FFI 把 Rust 库(minijinja 模板引擎、llguidance 约束解码)内嵌进 C++ 内核(方向与直觉相反,能复用就不重写);Engine/Executor 分层 + 工厂注册表抽象 CPU/GPU/NPU 多后端;NPU 多阶段 executor 用跨阶段零拷贝 buffer 共享。
项目展示
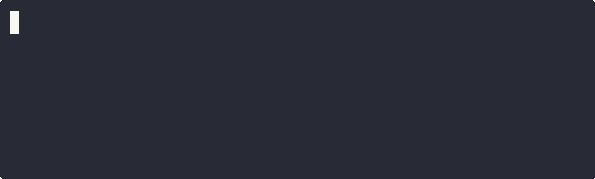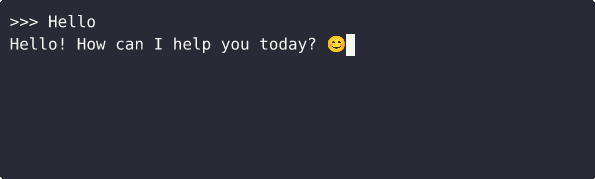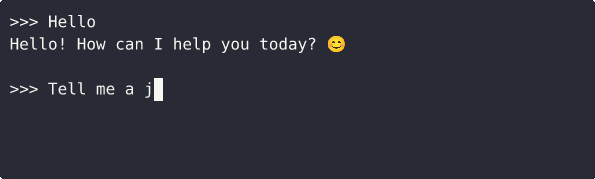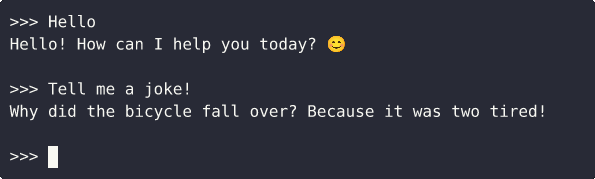
LiteRT-LM 在 Android(Kotlin)端运行 LLM 的演示。该项目以「跑在真机的产品」为主要展示形态(Chrome / Pixel Watch / AI Edge Gallery App)。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/google-ai-edge/LiteRT-LM(官网 https://ai.google.dev/edge/litert-lm) |
| Star / Fork | 5,487 / 564(Watcher 69、open issues 153、open PR 184) |
| 代码行数 | tokei 报 110 万行但严重失真——真正手写约 7.4 万行 C++(runtime/ 心脏)+ 多语言绑定约 2.4 万行;占比 97% 的「86 万行 GLSL」实为 tokei 对 testdata 下二进制模型/分词器 blob(.litertlm/.tflite/.spiece)的误分类,非代码非着色器 |
| 项目年龄 | 约 14 个月(2025-04-14 创建,最近提交 2026-06-07,持续活跃) |
| 开发阶段 | 密集开发(1722 commit,近 52 周 1529 占 89%、近 4 周 162,pre-1.0 高速迭代 v0.13.1) |
| 贡献模式 | Google 内部 monorepo → GitHub 镜像(约 34 贡献者,榜首 ai-edge-bot 662 是同步机器人,真人核心 whhone 等 6-8 名 Google 工程师) |
| 热度定位 | 大众热门(Google 官方旗舰 + 与 Gemma/Gemini Nano 强绑定) |
| 质量评级 | 代码[优] 文档[良] 测试[优] |
数据说明:本仓库 depth1 浅克隆,提交历史用 gh api 实采补正;代码行数 tokei 实测但经实地工作树核查重度拆解。
作者视角:为什么存在这个项目
创始人/作者背景
google-ai-edge 组织(Google AI Edge 团队,原 TensorFlow Lite / MediaPipe 班底,端侧推理领域最资深的工业玩家之一)。同组织维护 mediapipe(35.5k★)、AI Edge Gallery(23.6k★)、LiteRT、litert-torch、model-explorer 等完整端侧 AI 工具链。这是「自上而下的产品需求」驱动的框架——代码里甚至有 IsPixelTensorDevice() / GetPixelPerformanceCores() 把推理线程绑到 Pixel 大核的生产打磨痕迹。
问题判断
Google 的真实业务压力:Gemini Nano/Gemma 要落到 Chrome、Pixel、可穿戴等海量异构设备,要快、要省电、要能用厂商 NPU。裸 LiteRT 只是张量算子执行器,缺 LLM 必备的 tokenizer/KV cache/采样/多轮会话/流式/工具调用/约束解码——LiteRT-LM 正是补这一层的「生产级端侧 LLM 运行时」。
解法哲学
- 在 LiteRT 之上做专用栈,而非扩 MediaPipe:复用 TFLite 十年沉淀的 delegate(XNNPACK/GPU/NPU)与 CompiledModel,甩掉 MediaPipe graph 抽象的重量,换成可组合的 C++ 算子。
.litertlm单文件格式:权重 + tokenizer(SentencePiece 或 zlib 压缩的 HF)+ LlmMetadata proto + 配置全打进一个 FlatBuffers 头 + 块对齐 section 文件,mmap 直接映射省内存。- 宽接口 + 默认未实现:
LlmExecutorBase把几十个能力都设为 virtual 且默认返回UnimplementedError,各后端只实现自己支持的部分——牺牲接口纯粹性换后端独立演进。 - Rust 库反向嵌入 C++:用 cxx FFI 把成熟 Rust 库(minijinja 做 Jinja2 聊天模板、llguidance 做语法约束解码、tool_use 解析器)拉进 C++ 内核——能复用就不重写。
战略意图
LiteRT-LM 是 Google 端侧 AI 全家桶(Gemma 模型 + LiteRT 运行时 + AI Edge Gallery 展示 App + HuggingFace litert-community 模型仓)的运行时底座,与 Gemma 协同设计(MTP drafter、NPU 变体都是 Gemma 专供)。战略上对抗 llama.cpp 的社区通用性与 Meta ExecuTorch 的 PyTorch 生态,靠「第一方模型 + 厂商 NPU 通路 + 产品已验证」三件套建立差异。
核心价值提炼
创新之处
诚实评估:真创新在 NPU 多阶段编排 + MTP 落地 +
.litertlm格式工程化;多后端工厂、多语言绑定、mmap 是扎实的工程整合而非理论突破;CPU/GPU 推理大量复用 LiteRT/TFLite delegate,并非另起炉灶。
.litertlm单文件格式 — FlatBuffers 头描述SectionObject{begin/end_offset, data_type},section 按 16KB 块对齐以便 mmap;AnySectionDataTypeunion(TFLiteModel/TFLiteWeights/SP_Tokenizer/HF_Tokenizer_Zlib/LlmMetadataProto);显式 major/minor/patch 版本规则(纯加 section 升 minor,重排/删除升 major);跨平台MemoryMappedFile+ 并行 section 加载。新颖度 4/5、实用性 5/5、可迁移性 4/5。- Engine/Executor 分层 + EngineFactory 工厂注册表 —
LITERT_LM_REGISTER_ENGINE静态注册 Creator,preferred_engines_映射Backend → [引擎优先级],按后端(CPU/GPU/GPU_ARTISAN/NPU)自动选实现、只链接实际依赖的实现库,找不到时输出详尽诊断。新颖度 3/5、实用性 5/5、可迁移性 5/5。 - NPU 多阶段 executor + 跨阶段零拷贝 buffer 共享 + 可切换 HW 卸载 — NPU 不能跑整图,需把 embedder、per-layer embedder、mask、RoPE、KV cache update、transformer、MTP drafter 拆成多个预编译 CompiledModel 协同,用
CreateXxxContextWithBufferSharing让上游输出 buffer 直接做下游输入(零拷贝),NpuConfig开关在「模型内算」与「硬件算」间切换。新颖度 5/5、实用性 4/5(仅 Gemma + 特定 NPU)、可迁移性 2/5。 - MTP(Multi-Token Prediction)投机解码 — drafter/verifier/rejection sampling 跑上 NPU,称使 Gemma 4 推理快达 3x,
.litertlm文件头可探测HasSpeculativeDecodingSupport。新颖度 4/5、实用性 4/5、可迁移性 3/5。 - cxx FFI 反向内嵌 Rust 库到 C++ — 聊天模板(minijinja)、约束解码(llguidance)、工具调用解析 C++ 生态没有同等成熟的库,用
#[cxx::bridge]在 Rust 侧定义类型、生成 C++ 头让 C++ 直接调用 Rust 实现,统一全局分配器。新颖度 4/5、实用性 4/5、可迁移性 4/5。
可复用的模式与技巧
- 宽接口 + 默认 UnimplementedError(带后端名诊断):异构后端能力差异大时,统一基类 + 默认未实现、按需 override——多后端/插件能力快速膨胀的运行时。
- 单例工厂注册表 + 宏静态注册 + per-key 优先级回退:解耦创建、按需链接、找不到时详尽诊断(注释里特意用
std::unordered_map而非absl::flat_hash_map规避 Windows DLL 边界问题——生产细节)。 - FlatBuffers 头 + 块对齐 mmap section + 版本化 union 类型:单文件打包异构资产、低内存加载、清晰演进规则——模型/资产分发格式设计。
- 跨阶段 buffer 共享(上游输出即下游输入):多模型流水线零拷贝——内存/带宽敏感的多阶段推理。
- cxx 把 Rust 库桥进 C++ 内核:FFI 复用异生态成熟库——C++ 项目补生态短板。
- 会话 checkpoint/rewind/clone + KVCache Serialize/SelectAndCopyFrom/Broadcast:共享前缀 prefill 后分叉多分支、channel 内容选择性逐出 KV cache——多分支生成/思考内容隔离的会话系统。
absl::StatusOr全链路无异常错误传播 + Builder 模式:强健的 C++ 库 API。
关键设计决策
- 模板化
EngineT<SessionT>+ 默认别名Engine:标准用户用Engine(易用),高级用户(如 AICore)实例化EngineT<MyCustomSession>拿强类型自定义会话,避免 dynamic_cast——编译期类型安全换模板传染/ABI 复杂。 - 「一个 C++ 内核 + 多语言用户绑定 + C 稳定 ABI」分发:C(opaque 指针稳定 ABI)/Swift/Kotlin(JNI)/JS/Python/Flutter 全覆盖;注意用户绑定不含 Rust(Rust 只用于内嵌库),8 平台预编译,双构建系统 Bazel + CMake。
竞品格局与定位
竞品对比矩阵
| 维度 | LiteRT-LM | llama.cpp | MLC-LLM | ExecuTorch | MediaPipe LLM |
|---|---|---|---|---|---|
| 出品 | 社区 | TVM/社区 | Meta | Google(上一代) | |
| 移动 GPU/NPU 加速 | ✅ 强(NPU) | 弱 | GPU 广 | 多后端 | 中 |
| 模型覆盖 | Gemma 优先 | GGUF 海量 | 多 | 偏 Llama | 受限 |
| 多语言绑定 | ✅ 官方全 | 社区 | 部分 | PyTorch 系 | ✅ |
| 生产验证 | ✅ Chrome/Pixel | 桌面/极客 | 实验多 | 追赶中 | 已有 |
| 定位 | 工业派交钥匙 | 社区通用 | 编译式 | PyTorch 极小底座 | graph 高层 |
差异化护城河
① 与 Gemma/Gemini Nano 协同设计(MTP drafter、NPU 变体为 Gemma 专供);② 借 TFLite 十年 delegate 体系拿到厂商 GPU/NPU 通路,这是社区项目极难复制的;③ 生产已验证(Chrome/Pixel/Watch 真实出货);④ 第一方模型 + .litertlm 格式 + HuggingFace litert-community 仓的闭环分发。
竞争风险
① NPU 多芯片适配碎片化(每芯片要专门 executor/delegate,issue 痛点最集中处:联发科 MT6993、骁龙 8 Gen2 都踩 NPU dispatch 坑);② 预编译二进制分发摩擦(iOS arch 错、Android AAR dlopen 等);③ Google 内部 monorepo 镜像,外部贡献门槛高、节奏被内部主导;④ pre-1.0(v0.13)API 仍在变;⑤ llama.cpp 社区速度与模型广度持续施压。
生态定位
Google 端侧 AI 全家桶的「LLM 运行时底座」——不争通用极客市场,专吃「要把 Gemma 级模型稳定 ship 进消费级产品」的细分,靠第一方模型协同 + 厂商硬件通路立足。llama.cpp 赢在通用与社区,ExecuTorch 赢在 PyTorch 血统与极小底座,MLC-LLM 赢在编译式跨硬件;LiteRT-LM 是其自家 MediaPipe LLM Inference 的继任者(官方正引导迁移)。
套利机会分析
- 信息差:这是 Google 官方旗舰、媒体已大量报道,纯「挖冷门」价值低。套利空间在于讲清它在端侧 LLM 框架混战中的真实定位与取舍——以及 LiteRT/LiteRT-LM/TFLite/MediaPipe 的命名混乱(2024-09 改名但 .tflite 格式不变)这一开发者困惑点的厘清。
- 技术借鉴:「.litertlm 单文件 mmap 格式」「工厂注册表多后端抽象」「跨阶段零拷贝 buffer 共享」「cxx 内嵌 Rust 库」「宽接口 + 默认未实现」五项可迁移到任何推理框架/多后端运行时/跨语言项目。
- 生态位:填补「生产级 + 厂商 NPU 加速 + 与第一方模型一体化」的端侧 LLM 空白。
- 趋势判断:端侧 AI(隐私/低延迟/离线)是确定性大趋势,Google 全家桶 + Gemma 协同是强势位;但 NPU 碎片化与 llama.cpp 社区速度是变量。
风险与不足
- NPU 路径碎片化:每芯片要专门 executor/delegate,强绑 Gemma 算子拓扑,可移植性差(这也是 issue 痛点最集中处)。
- 预编译二进制分发摩擦:8 平台 prebuilt 但用户自定义场景需源码构建(Bazel 7.6.1 重链路);GPU 加速插件依赖预编译二进制,社区要求开源可从源码构建。
- pre-1.0 API 不稳:v0.13,Swift/JS/Flutter 仍 early preview/community,跨版本有兼容回归。
- 外部贡献门槛高:Google 内部 monorepo 镜像(ai-edge-bot 同步),主线由内部把控,外部 PR 节奏受限。
- 大模型端侧仍吃力:Gemma 4 12B 在 Android 加载/内存有报告失败。
行动建议
- 如果你要用它:要把 Gemma/Gemini Nano 级模型 ship 进消费级 Android/iOS/Web/桌面/可穿戴产品、且想要厂商 GPU/NPU 加速——LiteRT-LM 是工业派首选(直接用预编译 SDK,无需从源码构建)。要桌面/服务器通用推理、模型覆盖最广选 llama.cpp;PyTorch 生态选 ExecuTorch;要编译式极致跨硬件选 MLC-LLM。
- 如果你要学它:跳过 testdata,重点读
runtime/engine/engine.h(模板化 Engine)+engine_factory.h(工厂注册表);执行器看runtime/executor/llm_executor_base.h(宽接口)+llm_litert_npu_compiled_model_executor.h(NPU 多阶段,最复杂);格式看schema/core/litertlm_header_schema.fbs+litertlm_read.h+runtime/util/memory_mapped_file.h;会话看runtime/conversation/conversation.h;Rust 内嵌看runtime/components/rust/minijinja_template.rs;C API 看c/engine.h。 - 如果你要 fork 它:最有价值的可复用件是
.litertlm格式设计、工厂注册表、跨阶段 buffer 共享、cxx 内嵌 Rust;但要清楚 NPU 路径强绑 Gemma 与特定芯片,且 Google 内部主导,跟进上游需适应其镜像节奏。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/google-ai-edge/LiteRT-LM(已收录,五层栈架构解读:User APIs → Engine/EngineFactory → Executor → Backend 抽象 → 硬件后端) |
| 官方文档 | https://ai.google.dev/edge/litert-lm(Google Developers Blog「Blazing fast on-device GenAI with LiteRT-LM」为发布稿) |
| 在线 Demo | Google AI Edge Gallery App(gallery 仓库 23.6k★,手机实机体验 .litertlm 模型) |
| 关联论文 | 无官方配套论文(工程框架) |