5 年 10K stars:xformers 如何用「Bias 协议」重定义 Transformer 加速
一句话总结
Meta 开源的 Transformer 加速库 xformers,用一套「AttentionBias 协议 + 多后端调度器」让同一份 kernel 跑 23+ 种结构化 mask,并在 v0.0.35 主动放弃自研 FMHA、转为依赖上游 FlashAttention 3——从独立内核库收缩为「FAIR 训练栈的对外接口 + PyTorch 生态的 bias 协议标准制定者」。
值得关注的理由
- 战略分水岭已现:v0.0.35 标题「Rely on upstream FA3」标志 xformers 正式放弃独立内核叙事,公开仓库已退化为
from mslk.attention.fmha import ...的 re-export 薄层——读懂这次转身,就读懂了大厂基础设施「去自我中心化」的方向。 - PyTorch Stable ABI 迁移是给整个 C++ 扩展生态的范本:v0.0.34 切到
torch/csrc/stable/library.h,一次编译可跨 PyTorch 2.10+ 多个小版本,vLLM/TGI/HF optimum 都应抄这份作业。 - AttentionBias 是最值得复用的遗产:把「causal/local/block-diagonal」23+ 种结构化 mask 抽象为协议对象,让 kernel 不用回读 HBM 中的 dense mask——这套思路可平移到 MoE routing、Tree Attention、Sparse FFN。
项目展示
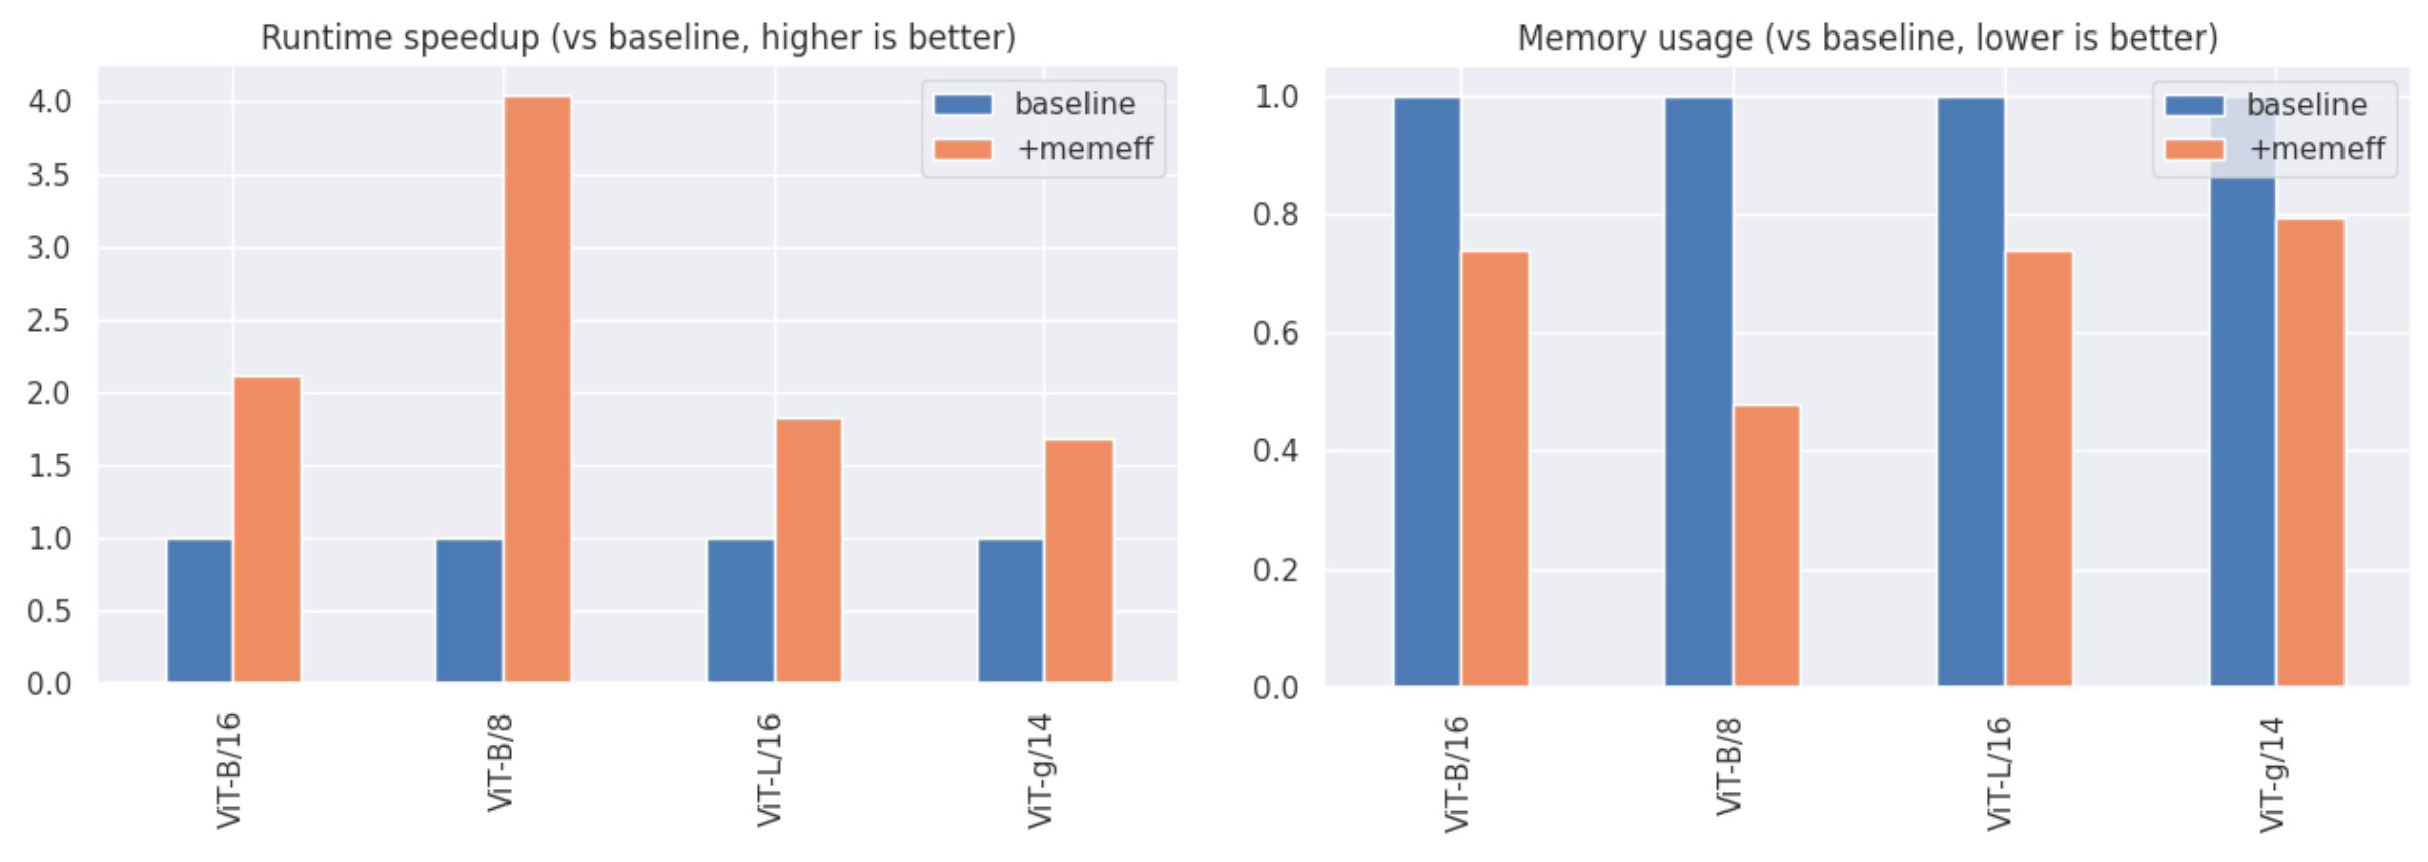
上图:xformers memory-efficient attention 在 ViT 类模型上的加速比,相比 PyTorch 原生 full attention 节省的显存与算力一目了然。
上图:xformers 官方 logo。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/facebookresearch/xformers |
| Star / Fork | 10K+ / 0.9K+(仓库基本数据,详见 Phase 1) |
| 代码行数 | 39,087(Python 51.2% / C Header 29.6% / C++ 17.8% / 其他 1.3%) |
| 项目年龄 | 55.7 个月(首次提交 2021-10-18) |
| 开发阶段 | 低维护(近 30 天 1 commit / 近 90 天 8 commit / 近 365 天 95 commit) |
| 开发模式 | 职业项目(周末占比 3.2% / 深夜占比 7.8%) |
| 贡献模式 | 小团队+社区(127 个贡献者,主作者 danthe3rd 占 19.0%) |
| 热度定位 | 大众热门,但月增 50+ 的”沉淀期”而非”爆发期” |
| 质量评级 | 代码 B+ / 文档 B / 测试 B+ / CI A- |
| 最新版本 | v0.0.35(60 个 tag,51 个 release) |
| 依赖 | 8 个 runtime 依赖(pyproject.toml) |
作者视角:为什么存在这个项目
创始人/作者背景
- xformers 由 Meta AI Research (FAIR) 官方组织账号
facebookresearch维护,主导者danthe3rd在 127 位贡献者中占 19.0% commit,是 Meta 内部 LLaMA、SAM、Multimodal 等大模型训练栈的对外切片。 - 作者群来自 CUTLASS 工程化、AMD ROCm 调优、FairScale/Megatron 分布式训练三条线的交叉训练——这种「既有 NVIDIA 内核经验、又有 AMD 调优经验、又有模型并行经验」的复合背景是 Meta 才能调出的配方。
问题判断
作者看到的是大模型时代的「三重墙」:
- 显存墙:标准 attention 的 O(N²) 复杂度在长序列下直接把 HBM 打爆;
- GPU 利用率墙:kernel 反复读 HBM 中的 dense mask,吞吐上不去;
- 生态割裂墙:同期 FlashAttention 虽然快,但以「单算子」思路提供,没暴露可组合的偏置体系,且绑定特定硬件抽象——研究者想做 ablation 时被迫 fork 内核。
时机的判断:2021 年 LLaMA/PaLM 还没出现、ChatGPT 还没点燃大模型潮,但 FAIR 内部已经在跑万亿参数实验,撞墙的痛感已经形成——xformers 是「先在内部解决、再开源」的项目。
解法哲学
- Block Zoo 元模型:把 Transformer 拆成 attention / FFN / positional encoding / multihead 等可独立替换的 block,研究者可快速做 ablation;
- Bias-as-a-First-Class-Citizen:用 23+ 个
AttentionBias子类把「哪些位置可以相互 attend」外置为 API,让 kernel 不用回看 HBM 里的 dense mask; - 后端调度解耦:用一个
dispatch机制在前向/后向上独立挑选 flash3 / flash2 / cutlass / ck / triton_splitk 中的最优算子——每个后端都暴露FwOp/BwOp的对称类。
作者明确选择了不做什么:
- 不做模型层(那是 HuggingFace 的活);
- 不做分布式框架(那是 DeepSpeed/Megatron 的活);
- 不做 AI 编译器(那是 Triton 的活);
- 纯算子库 + 调度器 + 训练生态组件——清晰的边界感。
战略意图
v0.0.35 的 “Rely on upstream FA3” + v0.0.34 的 PyTorch Stable ABI 迁移 + v0.0.34 “Removed most legacy components” + v0.0.29 “Removed conda support”——连串动作的合理解读是:Meta 把「独立分发」的包袱抛掉,融入 PyTorch 主分发,让 xformers 成为「FAIR 训练栈对外接口 + PyTorch 生态的 bias 协议标准制定者」。
这是收缩战略而非衰落:项目不再试图做「独立的高性能 attention 库」,而是用 AttentionBias 协议 + Stable ABI + 训练栈组件(2:4 稀疏/seqpar/profiler)占据不可替代的生态位。
核心价值提炼
创新之处
-
AttentionBias 协议化(新颖 4 / 实用 5 / 可迁移 5) 把「如何 mask attention」从数据形态(dense tensor)提升为协议(带
materialize/_split_queries的对象族),kernel 端按协议决定加载策略。23+ 子类覆盖 causal / lower triangular / block diagonal / paged / gappy 等所有主流结构化 mask。 -
FwOp / BwOp 独立 dispatch(新颖 3 / 实用 5 / 可迁移 5) 把前向/后向视为可独立编排的算子对象,支持「Cutlass Fw + Flash Bw」等异构组合——
AttentionOpBase协议让每个后端提供FwOp/BwOp两个类,dispatch独立查找。 -
Selective AC + SciPy MILP policy 搜索(新颖 4 / 实用 4 / 可迁移 4)
checkpoint.py中_scipy_is_available走scipy.optimize.milp求解「在给定显存预算下保留哪些 op 内存」——把 activation checkpointing 的策略搜索从启发式升级为形式化求解。 -
Computation-Communication Overlap(新颖 3 / 实用 5 / 可迁移 4)
fwbw_overlap.py+sequence_parallel_fused_ops.py把 allgather/reducescatter 与 matmul fuse(fused_allgather_and_linear/fused_linear_and_reducescatter),让 sequence parallelism 通信「近似免费」。 -
PyTorch Stable ABI 适配(新颖 3 / 实用 5 / 可迁移 5) v0.0.34 把 C++ 扩展从
torch/extension.h切到torch/csrc/stable/library.h,实现「一次编译跨 PyTorch 版本」——是所有 PyTorch C++ 扩展库(vLLM、TGI、HuggingFace optimum)的标杆。 -
2:4 结构化稀疏训练栈(新颖 3 / 实用 5 / 可迁移 4)
sparsify24_ste(STE 梯度)+sparse24_pack.cu/sparse24_gemm_sm90.cu(高效打包 + SM90 路径)+sparsify24_like(cuSparseLt 后端)形成完整工具链,让研究者在不改模型结构的前提下吃到 NVIDIA 2:4 sparsity 红利。
可复用的模式与技巧
| 模式 | 描述 | 适用场景 |
|---|---|---|
| Registry + 协议类 | BaseOperator / register_operator 让 op 可发现 + 可检查可用性,python -m xformers.info 一键列所有 op 状态 | 任何带可选 kernel 的库(vLLM、TGI、HF optimum) |
_BuildInfo + 自定义异常 | C++ 扩展加载失败时,把「你装的是 PyTorch X / CUDA Y / Python Z」明确报出来——比裸 OSError 友好十倍 | 所有带 native 扩展的库 |
torch.library.custom_op + register_fake | 把 vendored FA 注册成 xformers_flash::flash_fwd,让用户走 torch.library 通路而不是直接 import | 第三方 kernel 库(FA、Triton kernels、cuBLASLt)集成 |
| Bias-as-Protocol | 把结构化 mask 提升为带协议方法的对象 | MoE routing、Tree Attention、Sparse FFN、Conv padding pattern |
| Module-Parallel Layers as Drop-in Replacement | ColumnParallelLinear / RowParallelLinear 既保留 FairScale 生态兼容性又提供新能力 | 分布式训练库的演进 |
关键设计决策
-
FwOp / BwOp 分离 + 后端可独立选择
- 问题:不同算子在不同 shape / GPU 上的最佳实现不同,且前后向可能用不同实现(如
CutlassFwdFlashBwOp) - 方案:
AttentionOpBase协议 +dispatch独立查找 - Trade-off:API 更复杂,但允许极致性能调优
- 可迁移性:非常高,是「策略模式 + 注册表」在数值计算库的教科书级应用
- 问题:不同算子在不同 shape / GPU 上的最佳实现不同,且前后向可能用不同实现(如
-
MSLK 重定向(最新动向)
- 问题:核心 fmha 实现已迁出 xformers 仓库
- 方案:
xformers/ops/fmha/*.py现仅是from mslk.attention.fmha import ...的 re-export 薄层(__init__.py注释明确说明 “fmha implementation has moved to the mslk package”),并通过torch.library.define + impl注册 stable 算子 - Trade-off:公开仓库瘦身(不再维护核心 kernel),但 xformers 在公开侧仅做「上游集成 + 用户友好封装」
- 可迁移性:一种「Monorepo 拆分的对外兼容」模式
竞品格局与定位
竞品对比矩阵
| 维度 | xformers | FlashAttention | PyTorch SDPA | DeepSpeed-FastAttn | Triton attention |
|---|---|---|---|---|---|
| 定位 | 算子库+调度器+训练栈 | 极致单算子 | 零门槛默认入口 | 端到端训练框架内置 | AI 编译器 DSL |
| AttentionBias 表达力 | ★★★★★(23+ 子类) | ★★(仅 causal/mask) | ★★(is_causal + mask) | ★★★ | ★★★ |
| 单算子性能 | ★★★★ | ★★★★★(H100 上最快) | ★★★★(已并 FA2) | ★★★★ | ★★★★ |
| 跨厂商硬件 | NVIDIA + AMD + CPU | NVIDIA 为主 | 全平台 | NVIDIA + 部分 AMD | 全平台(编译期生成) |
| 训练生态组件 | 2:4 稀疏/seqpar/overlap/profiler | 无 | 无 | ZeRO/FSDP/LoRA | 无 |
| PyTorch 版本兼容 | Stable ABI 一次编译跨版 | 跟 torch 版本走 | torch 自带 | 跟 torch 版本走 | 跟 torch 版本走 |
| 维护模式 | 收缩(v0.0.35 依赖上游) | 持续激进 | 官方持续 | 微软持续 | 持续 |
| 入门门槛 | 中(要学 bias 协议) | 低 | 零 | 中 | 高(要写 Triton) |
差异化护城河
- AttentionBias 协议——把「masking 知识」做成 first-class 抽象,竞品都没有;
- 多后端调度器 + Stable ABI——一份 wheels 跨 PyTorch 版本,跨 NVIDIA/AMD;
- 训练栈组件(2:4 稀疏 / seqpar / fwbw overlap / profiler)——形成「研究基础设施」生态闭环。
竞争风险
- PyTorch SDPA 持续侵蚀:PyTorch 2.5+ 已默认 FA2,未来 2.10+ 可能继续合并更多后端,xformers 的「基础 attention 加速」叙事弱化;
- FA 持续领先单算子性能:xformers v0.0.35 实质上把 FA3 当上游,自身议价权下降;
- 维护模式收缩:v0.0.34 “Removed most legacy components”,社区贡献者可能流失;
- 核心代码迁出(mslk):公开侧越来越「薄」,对独立开发者的可见价值下降。
生态定位
从「独立的高性能 attention 库」收缩为「FAIR 训练栈对外接口 + PyTorch 生态的 bias 协议标准制定者」。
xformers 已不再竞速单算子性能,转而占据「协议层 + 调度层 + 训练生态层」这三个上层位——这是 Meta 主动的战略选择,也是大厂基础设施项目「去自我中心化」的样本。
套利机会分析
- 信息差:v0.0.35 的「rely on upstream FA3」转折点尚未被中文社区充分讨论——先讲清楚这次转身的意义就有差异化内容价值。
- 技术借鉴:
- 任何 PyTorch C++ 扩展库都应抄 Stable ABI 迁移的作业(vLLM / TGI / HF optimum);
- AttentionBias 协议可平移到 MoE routing、Tree Attention、Sparse FFN 场景;
- Selective AC + SciPy MILP policy 搜索的思路可下沉到任意显存受限的训练 pipeline。
- 生态位:填补了「开源 + 不绑定 PyTorch 主分发 + 多后端 + 训练生态完整」的中间地带——是 PyTorch 2.10 Stable ABI 时代的代表性参考实现。
- 趋势判断:项目自身在收缩(核心代码迁出 mslk),但 AttentionBias 协议 + Stable ABI 这两条「上层资产」正变得越来越重要——是「向下沉、向上让」的典型路径。
风险与不足
- 公开侧越来越薄:核心 fmha 已迁出到内部
mslk包,PR 入口变得隐蔽,社区贡献者参与门槛升高; - 长期未关闭的 issue:Torch 2.7 / CUDA 12.8 不兼容、训练 NaN 等问题在 issue 区持续出现,公开 issue 响应体验待改善;
- 文档与代码脱节:
docs/source/components/仍存在但对应代码大部分已 Removed(v0.0.34); - 维护节奏放缓:近 30 天仅 1 commit、近 90 天 8 commit,活跃度从「密集开发」降至「低维护」;
- 战略不确定性:v0.0.35 “Rely on upstream FA3” 后,下一步是融入 PyTorch 官方分发、还是继续作为独立 wheel?路线图不明朗。
行动建议
如果你要用它
- 作为 attention 后端调度器:在
xformers.ops.memory_efficient_attention上做研究时,优先用op=关键字显式指定后端(flash3 / cutlass / ck),而不是依赖默认 dispatch; - 作为训练栈组件库:直接用
xformers.components.multihead做多模态 ablation、用xformers.ops.fused跑 seqpar; - 不建议:在生产大模型训练中把 xformers 当「唯一加速来源」——基础 attention 路径已被 PyTorch SDPA + FA 充分覆盖,xformers 真正的价值是 AttentionBias + 训练生态组件。
如果你要学它
- 必读文件:
xformers/ops/fmha/attn_bias.py(23+ AttentionBias 子类,看协议怎么写)xformers/ops/fmha/dispatch.py(FwOp/BwOp 独立 dispatch 范本)xformers/ops/memory_efficient_attention.py(统一入口)xformers/checkpoint.py(Selective AC + SciPy MILP)xformers/csrc/attention/attention.cpp(Stable ABI 入口)xformers/_cpp_lib.py(_BuildInfo+xFormersInvalidLibException错误处理范本)
- 必跑命令:
python -m xformers.info(列出所有 op 的 available/unavailable 状态,是观察「本机环境 + 库版本」耦合关系的最佳起点) - 必看 CHANGELOG:v0.0.30(AMD CK 后端)、v0.0.32(移除 autograd backward)、v0.0.34(Stable ABI + 移除 legacy components)、v0.0.35(rely on upstream FA3)
如果你要 fork 它
- 可改进方向:
- AttentionBias 协议下沉到 PyTorch core:在
torch.nn.attention.bias中实现官方版,把 23+ 子类变成可被 SDPA 直接消费的 API; - mslk 拆分时的社区治理:核心代码迁出后,公开侧如何保留可贡献性?需要一个「公开内核子项目」+「私有扩展子项目」的双层 monorepo 范本;
- Triton DSL 版本的 AttentionBias:用 Triton 实现一个 mask 协议解释器,让用户写 Python bias、Triton kernel 自动生成对应加载逻辑。
- AttentionBias 协议下沉到 PyTorch core:在
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/facebookresearch/xformers |
| Zread.ai | https://zread.ai/facebookresearch/xformers |
| 关联论文 | 「Hardware-aware Computations for Large Transformer Models」等(项目 README 引用)—— xformers 本身无独立顶会论文,是工程沉淀项目 |
| 在线 Demo | 无(库项目,无交互 demo) |
| 官方主页 | https://facebookresearch.github.io/xformers/ |
| 官方文档 | https://facebookresearch.github.io/xformers/components/ |