GitHub 推荐:8.5 个月 5000 stars:Searx 作者 Adam Tauber 把「私人搜索引擎」做成了 MCP 时代的 RAG 基础设施
一句话总结
Hister 是一个把”你看过/打开过的网页 + 本地文件”自动建索引、自托管、可被 AI 客户端直连的私人全文搜索引擎——同时也是 Searx 作者 Adam Tauber 在「个人数据侧」对自家元搜索产品线(Searx/Colly)的纵向延伸。
值得关注的理由
- AI 时代自托管 RAG 的”事实标准候选”——它是少数把”Bleve 全文检索 + 可选向量 + MCP server”三件套在同一二进制里都打通的个人搜索引擎,并且内置
Trusted/Untrusted分区主动防御 prompt injection,这是技术深度而不是又一层 wrapper。 - 作者可信度极高——同作者作品 Searx(10 万+ star 元搜索)+ Colly(Go 爬虫框架事实标准)+ wuzz(10k+ star HTTP 调试工具),账号 18.1 年;Hister 在他最近 push 的仓库里排第 1,是”主产品级”投入。
- 罕见的”产品 + 协议 + 生态”三位一体扩张——8.5 个月、20 个 release、66 位贡献者、25 篇官方文档 + 9 篇博客、6+ 个 GitHub Actions、9 个分发渠道(goreleaser 多平台 / Docker Hub / ghcr.io / Nix / Homebrew / WinGet / Webi / Forgejo 镜像 / compose),并通过
#305 Extractors wanted!把”格式支持”开放给社区。
项目展示
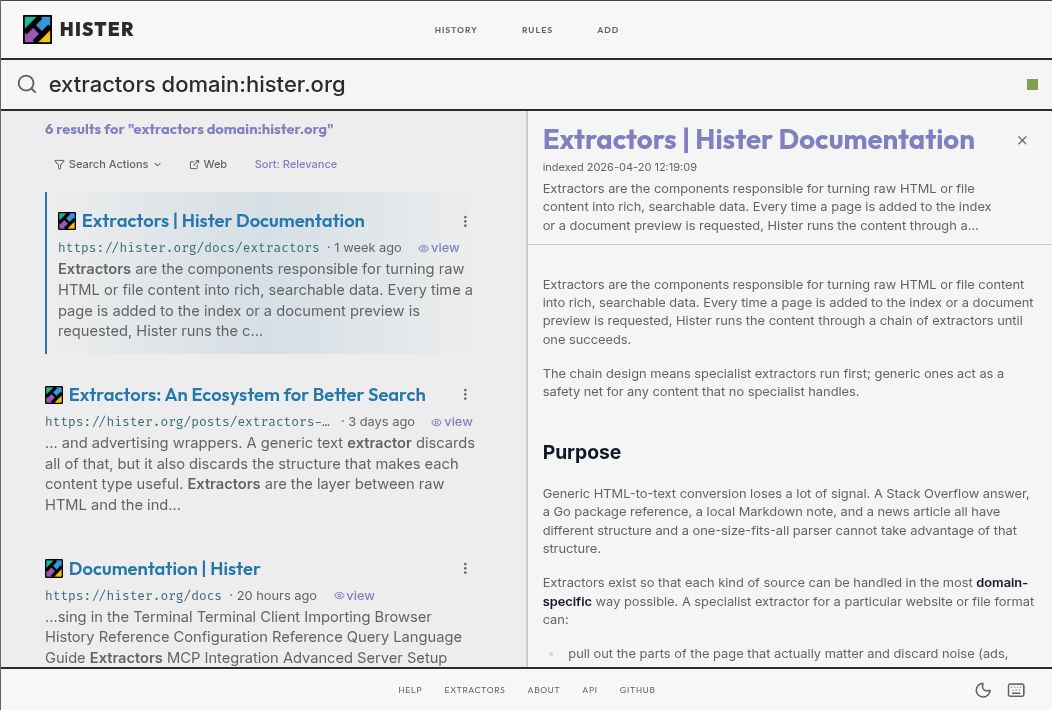
主界面截图:左侧搜索结果列表 + 右侧已存储文档预览,体现「找得到 → 读得回」的闭环。
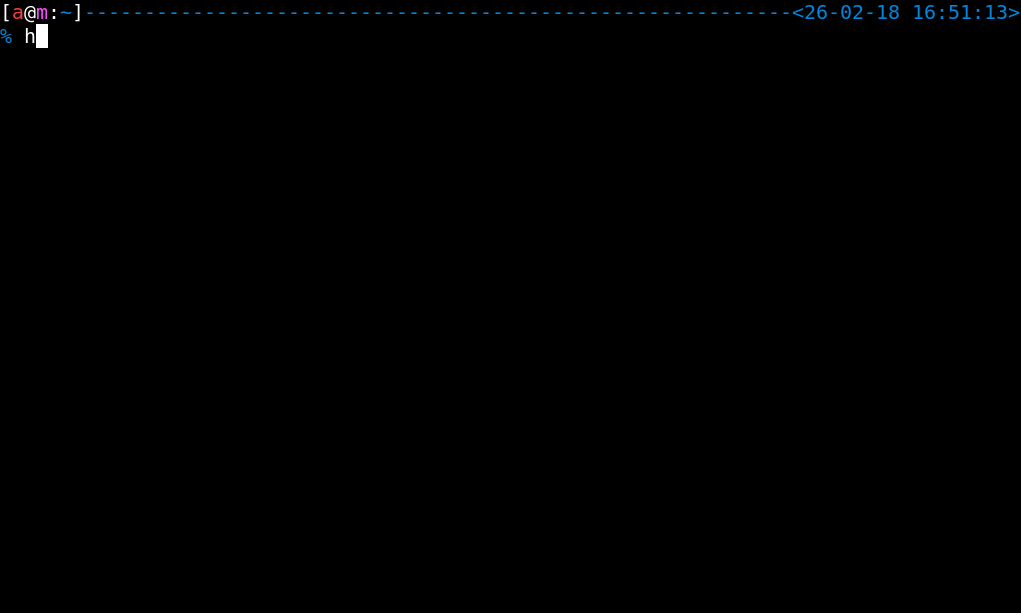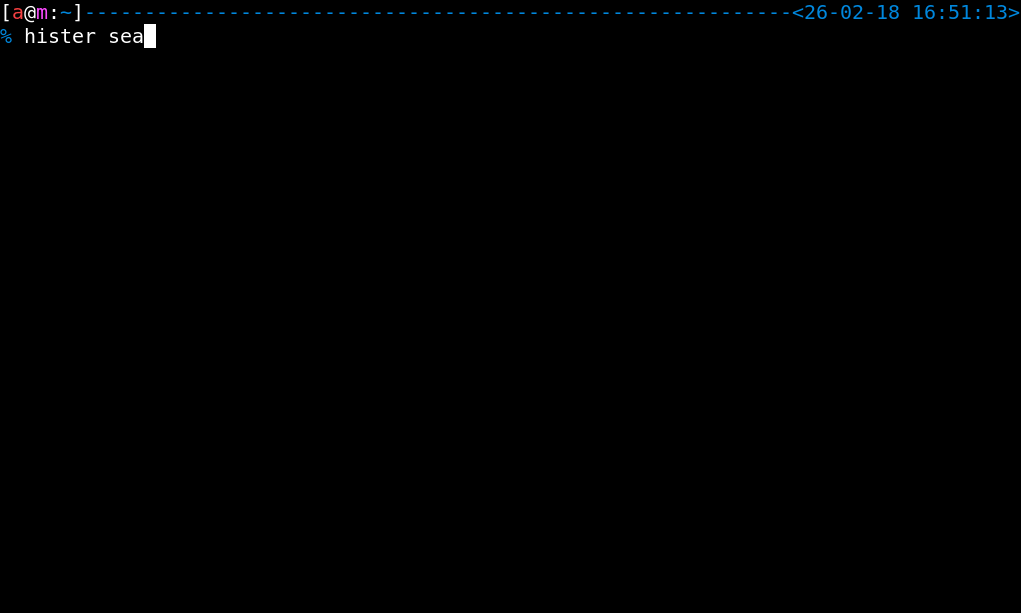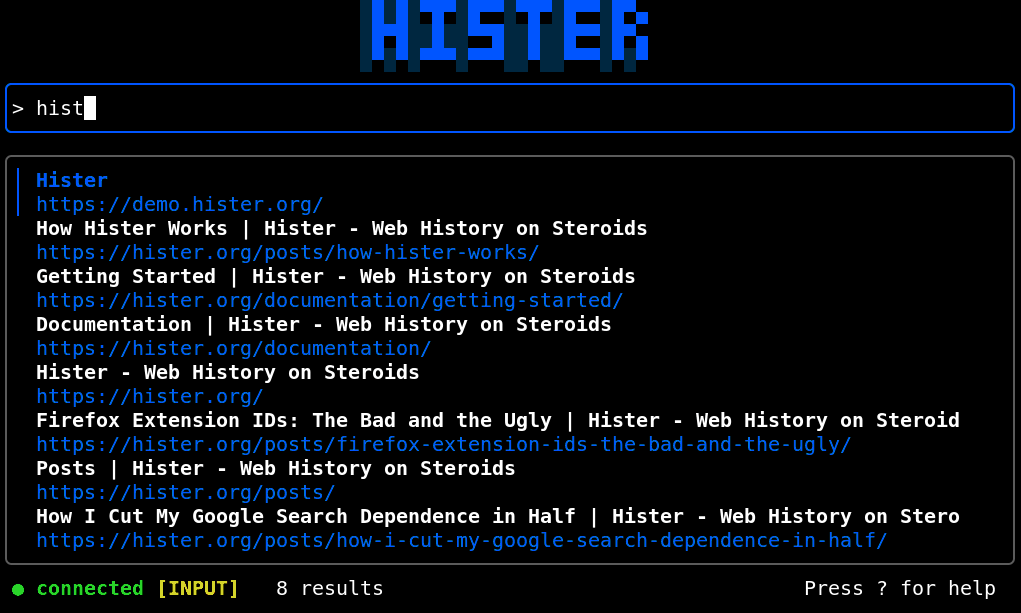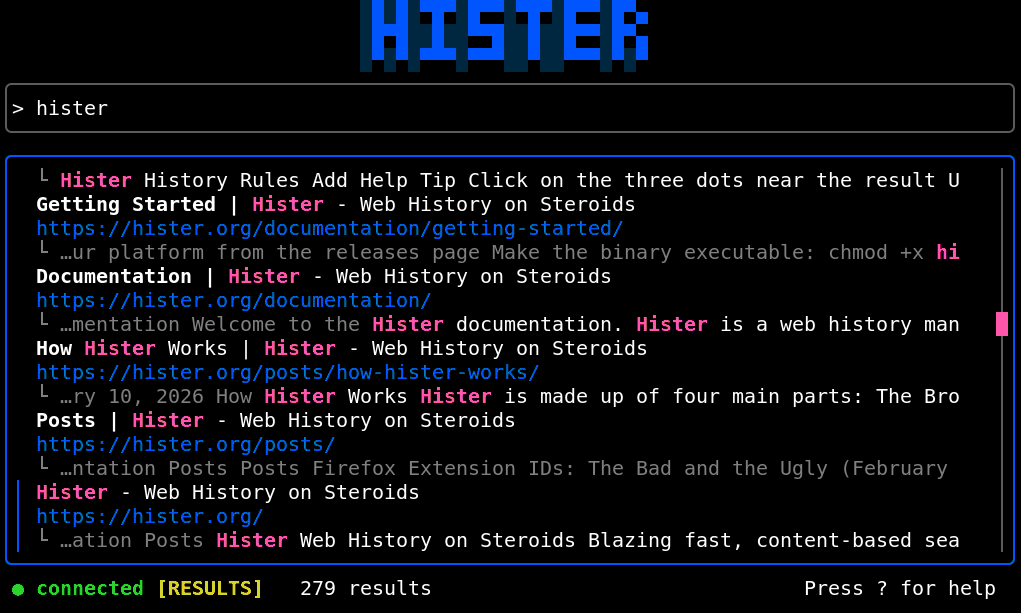
TUI 终端演示:除 Web 外的第二客户端,bubbletea/v2 实现。
项目吉祥物/Logo,README 中也作为赞助商露出——印证了”genuinely open、不做 SaaS”的商业模式。
官网
https://hister.org/与https://demo.hister.org/也提供 live demo 与 hero 图,本次选 README 中三个已校验素材即可覆盖 hero / screenshot / demo 三类。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/asciimoo/hister |
| Star / Fork | 5008 / 209 |
| 热度级别 | 大众热门 |
| 代码行数 | 90,802(语言:Go 67.3% / Svelte 9.4% / C 8.9% / JSON 4.8% / TypeScript 4.3% / 其他 ~2.8%) |
| 项目年龄 | 8.5 个月(首次提交 2026-01-04) |
| 开发阶段 | 密集开发(8.5 月产出 2125 commit,月均 ~250;近 30 天 239) |
| 贡献模式 | 单人主导(Top1 Adam Tauber 1262 commit,占 70.9%) |
| 贡献者 | 66 人(核心少数 + 社区,FlameFlag/dependabot/4evy/ISSOtm 等) |
| 部署形态 | 单二进制 + SQLite 默认 / PostgreSQL 可选 / Docker + Nix + Homebrew + WinGet + Webi + Forgejo 共 9 渠道 |
| 许可证 | AGPLv3-or-later |
| 质量评级 | 代码[优秀] 文档[优秀] 测试[充分] CI/CD[完善] |
作者视角:为什么存在这个项目
创始人/作者背景
Adam Tauber(asciimoo),布达佩斯独立开发者,账号 18.1 年。其作品序列本身就是一条「隐私/搜索基础设施」产品线:Searx(10 万+ star 的元搜索引擎,长期被广泛自部署用于隐私搜索)→ Colly(Go 生态事实标准的爬虫框架)→ wuzz(10k+ star 的 HTTP 调试交互工具)。Hister 是这条产品线向「个人数据侧」的纵向延伸——把 Searx 抽象出的 plug-in / parser 思路,从”搜互联网”反向应用到”搜自己的数据”。
问题判断
作者明显看到了三件事:
- 普通书签/历史只记 URL/标题——用户想找回「我记得在某个页面看到过那句话」时无能为力,链接失效后内容直接消失。
- 云端笔记要求主动整理——被动浏览产生的信息流天然无法被结构化捕获。
- 2025–2026 三股浪潮同时成熟:本地 LLM 普及(Ollama/qwen3-embedding 默认 endpoint)、MCP 协议标准化(Anthropic 2024 年末发布)、隐私回潮(NotebookLlama、自托管 RAG 走红)。三者交集出现了一个明确空白——个人数据 + 全文索引 + AI 直连还没有一个成熟答案。
解法哲学
作者选了一条”功能完整”路线,同时承担了取舍成本:
- 明确选择做什么:Bleve 关键词 + 可选 sqlitevec/pgvector 向量,20+ 内置 extractor(HTML/Markdown/Discourse/Twitter/Reddit/YouTube/ChatGPT/Notion 等),Web UI + TUI + 浏览器扩展 + MCP + CLI 五端,SQLite 与 PostgreSQL 双后端。
- 明确选择不做什么:不做云服务(README「No telemetry or mandatory cloud service」明文声明);不做协同编辑(不是笔记工具);不做内嵌 AI 对话(MCP 已把搜索外包给 AI 客户端);不做全网爬虫(Crawler 配置按域,默认 robots 守门)。
- 隐私由架构强制而非策略——所有索引内容只发往用户配置的那台 Hister 服务,敏感字段(AWS key / GitHub token 等)正则自动屏蔽;MCP 协议层显式声明
Trusted/Untrusted分区防止 prompt injection。
战略意图
- 个人核心产品——Hister 在作者最近 push 的仓库中排第 1,是投入权重最高的项目。
- genuinely open——非 open-core,无 SaaS/托管版/企业版;商业意图通过 README 公示的赞助商(Uruky logo)实现,不锁闭源代码。
- 长期定位是”个人 AI 时代的基础设施”——让本地大模型能搜你的数据,而不是被云端 LLM 记忆垄断。
核心价值提炼
创新之处
按新颖度 × 实用性排序:
- MCP 协议层 trust boundary 设计(Trusted vs UntrustedContent 分区) — 工具结果显式声明
trust: untrusted+trust_scope: all values in fields+ 每条 record 的 source_type,HTML 默认不返,必须在search显式要求或get_preview渲染后才返回,且仍包在 untrusted 分区内;不可见控制字符主动清理。新颖度 5/5,实用性 5/5,可迁移性 4/5。任何把数据直连 AI 的系统都应该复制这套三件套。 - 内容寻址存储 + 引用计数 GC 的 dataStore — 256 个分片的
sync.RWMutex池 + 4 级目录前缀 + gzip 压缩 + “写时算 SHA-256 + stat 已存在则 skip” + “shard 锁内做 refCount + atomic 删除”。新颖度 4/5,实用性 5/5,可迁移性 5/5。适用:多源同内容去重 + 大对象存盘 + 并发安全。 - 抽取器三阶段链式抽象(Enrich/Extract/Preview + Decision 构造器) — 抽取器接口仅 6 个方法;
Capabilities三阶段解耦 enrich/extract/preview;ExtractResult强制走构造器,编译期防止零值混淆;ContextExtractor可选接口让框架自动 type-assert 切换到带 cancellation 的版本。新颖度 4/5,实用性 5/5,可迁移性 4/5。 - Reindex 临时目录 + 共享 dataStore + atomic rename 升级 —
reindex/子目录写入新索引,live 索引继续服务;dataStore 共享保证 content 不重写;backfillEmbeddingFingerprint标记避免全量回填阻塞启动。新颖度 3/5,实用性 5/5,可迁移性 5/5。 - 抽取器生态化(#305 设计意图) — 23 个内置 extractor +
_extractor_template+ sdk 文档 +extractors.md,把”格式支持”开放给社区;RegisterBefore(name, candidate)支持用户级插入。新颖度 3/5,实用性 5/5,可迁移性 4/5。 - 可选向量搜索(sqlitevec / pgvector + HNSW)+ Embedding 指纹漂移检测 — embedding 队列与 Bleve 关键词搜索并行,融合
SemanticWeight加权排序;EmbeddingFingerprint检测配置漂移自动警告 reindex。新颖度 3/5,实用性 4/5,可迁移性 4/5。
可复用的模式与技巧
- 协议层 trust boundary + untrusted scope 分区:AI 直连数据系统的 prompt injection 防护(自托管 RAG / 企业知识库 / AI 客服)。
- 插件接口最小化 + 阶段解耦 + Decision 构造器:内容格式异构系统的扩展点设计。
- Reindex 临时目录 + shared dataStore + atomic rename:全文索引系统零停机升级。
- 内容寻址 + 分片锁 + 引用计数 GC:多源同内容去重 + 大对象并发安全存取 + 异步 GC。
- 多客户端共享 client SDK + origin 白名单 CSRF 绕过:Web 工具的多端化(Go client 包同时驱动 CLI 与 TUI;
browserExtensionRequest+hister://协议头兜底)。 - Viper + XDG Base Directory + HISTER__ 前缀环境变量:Go 自托管工具的标准配置加载范式。
- 容器只读 + cap_drop + tmpfs + uid 65532 + no-new-privileges:自托管工具的安全加固模板(Dockerfile + compose.yml 都已落地)。
关键设计决策
-
Bleve 全文索引 + SQLite/PostgreSQL 双后端 + 可选 vector store
- 问题:亿级文档秒级响应 + 单用户本地/多用户共享两种部署 + 关键词→向量渐进扩展。
- 方案:
scorch段格式 + 自定义bolt_timeout: 2s、NumPersisterWorkers: 4、FloorSegmentFileSize: 20MB;不同语言分桶(index_<lang>.db),用bleve.NewIndexAlias跨索引并行搜索;连接串含=即视为 PostgreSQL;SQLite 走sqlitevec,PostgreSQL 走 pgvector + HNSW(2000 维上限)。 - Trade-off:牺牲了”一份数据多端可用”(SQLite/PostgreSQL 不能热迁移),换来部署灵活度 + 关键词与向量可叠加(融合
SemanticWeight)。 - 可迁移性:高。
-
抽取器链式抽象(
Extractor+Capabilities+Decision)- 问题:互联网内容格式持续演化(HTML 静态→SPA→讨论→社交→AI 对话),任何”内置解析器”都会过时。
- 方案:
sdk.Extractor仅 6 个方法;Capabilities{Enrich, Extract, Preview}三阶段解耦;ExtractResult.decision私有强制走构造器;Registry按顺序取首个 Extract 成功的;RegisterBefore(name, candidate)用户级插入。 - Trade-off:牺牲了”插件独立部署”(抽取器必须编译进主二进制),换来编译期类型安全 + SDK 演进兼容 + 易测试。
- 可迁移性:高。
-
MCP Streamable HTTP 端点 + structured untrusted-content 边界
- 问题:搜索结果直接喂给大模型会被 prompt injection。
- 方案:
POST /mcp实现 MCP2025-06-18规范;mcpStructuredResult拆Trusted+UntrustedContent;每条 untrusted record 都附mcpUntrustedContentInstruction;HTML 默认不返;不可见控制字符清理。 - Trade-off:牺牲了”AI 端开箱即用的便利”(客户端必须理解 trust 分区),换来”prompt injection 攻击面被协议层声明而非客户端自行假设”。
- 可迁移性:高。
-
多端共用同一后端 + client SDK 共享
- 问题:Web UI、TUI、CLI、MCP 客户端各自实现 HTTP 调用会导致接口漂移;浏览器扩展又是另一种 origin。
- 方案:
client/包被cmd/与cmd/tui/共享;webui/app/SPA +webui/website/Astro 文档站 +webui/ext/浏览器扩展共享webui/components/;withCSRF中间件特别处理浏览器扩展 origin + CLIOrigin: hister://协议头。 - Trade-off:牺牲了”前端技术栈统一”(四套独立构建链),换来了”后端协议是唯一真值源,任何客户端替换不会破坏数据契约”。
- 可迁移性:中。
-
单二进制 + SQLite 默认 + 9 渠道分发
- 问题:面向”非运维开发者”群体,部署摩擦必须为零。
- 方案:Dockerfile 多阶段(frontend → builder 静态链接 +
-trimpath -s -w→ ytdlp 校验 → runtime uid 65532 + read_only + cap_drop ALL + no-new-privileges);compose.yml 加read_only、tmpfs、pull_policy: missing、init、restart: unless-stopped;Nix flake 升级到 nixpkgs module 自留 package;goreleaser 6 平台 + Docker Hub + ghcr.io + Nix + Homebrew + WinGet + Webi + Forgejo + compose。 - Trade-off:牺牲了”更小的二进制”(CGO 强制 sqlite3 + chromedp + ytdlp 子进程让镜像 ~100MB),换来了开箱即用 + 多平台覆盖 + 默认安全加固。
- 可迁移性:中。
竞品格局与定位
竞品对比矩阵
| 维度 | Hister | Karakeep(原 Hoarder) | WorldBrain Memex | Linkding |
|---|---|---|---|---|
| Stars / 热度 | 5,008 / 大众热门 | ~20k / 大众热门 | ~3k / 小众精品 | ~8k / 中等热度 |
| 索引范围 | 网页正文 + 本地文件 + 浏览器历史 + 社交抽取 | 仅书签元数据 + 部分 monolith 抓取 | 仅浏览器内页面 | 仅书签元数据 + Wayback 快照 |
| 全文索引 | ✓(Bleve) | ✗(按 tag/标题搜索) | 部分(标题 + 选中文本) | ✗ |
| 离线快照可读原文 | ✓(核心差异化) | 部分(缓存但弱解析) | ✗ | 仅 Wayback 链接层 |
| 向量/语义搜索 | ✓(可选 sqlitevec/pgvector) | ✓(AI 自动打标签) | ✓(Steward AI) | ✗ |
| MCP server / AI 直连 | ✓(协议层 trust boundary) | ✗ | ✓(但非 MCP) | ✗ |
| 多客户端 | Web + TUI + Ext + MCP + CLI | Web + iOS/Android + 三大浏览器扩展 | 浏览器扩展为主 | Web |
| 存储后端 | SQLite / PostgreSQL 双后端 | 自带 DB | 浏览器 IndexedDB + 服务端 | SQLite(单文件 Django) |
| 抽取器扩展 | 23 个内置 + SDK + #305 开放社区 | 内置有限 | 内置有限 | 无 |
| License | AGPLv3 | MIT | AGPLv3 | MIT |
| 移动端 | ✗ | ✓(iOS/Android 完整) | 仅扩展 | ✗ |
差异化护城河
- 技术护城河:MCP server + 全文索引 + 离线快照存档 + 协议层 trust boundary 四件套目前只有 Hister 全占。
- 生态护城河:Searx + Colly 系谱 + AGPLv3 社区 + 9 渠道分发 + 双平台镜像(GH + Forgejo)+ Nix module 升级到上游。
- 信任护城河:单开发者主导 + 18 年账号 + Searx 10 万+ star 的历史信誉背书 + 严格的 AI 政策(README/CONTRIBUTING 明确要求”AI 协作必须披露、人类必须主导、AI 不能作为 good first issues 的低垂果实”)。
竞争风险
- 短期风险:Karakeep 的”全平台书签 + AI 标签 + 移动端”对一般用户更友好,可能蚕食「只想存书签」的用户。
- 中期风险:Obsidian + 自建 RAG 插件对”笔记 + 检索”二合一的用户可能更直接,Hister 没有笔记编辑能力。
- 长期风险:如果 MCP 协议被标准化,任何带搜索的工具都能加 RAG——Hister 的护城河最终要落在”全文 + 隐私 + 自托管 + 离线快照”四件套的组合深度,而非单一功能。
生态定位
- 搜索生态中的”个人数据侧” —— SearXNG 搜互联网、Hister 搜自己、Obsidian 写笔记、Karakeep 管书签,四者交叉而非完全替代。
- AI 生态中的”本地 RAG 后端候选” —— MCP 让 Claude/Cursor 能直接挂上 Hister 作为知识库,是少有的”自托管 + AI 直连 + prompt injection 防护”一体化方案。
- 隐私生态中的”AGPLv3 自托管工具系列” —— 和 Searx/Colly/wuzz 一起构成”不依赖 SaaS 的个人工具集”。
套利机会分析
- 信息差:Hister 5000 star 在”个人全文搜索引擎”垂直里已是头部,但相对 Karakeep(20k)/ SearXNG(16k)/ Linkding(8k)还有明显差距——读者此刻关注到就是套利窗口。Seeyeetech 上目前没有他的中文深度分析(本次首发)。
- 技术借鉴:
- MCP trust boundary 三件套:任何”AI 直连数据”项目(自托管 RAG、企业知识库、AI 客服、AI Code Review)都可以直接复制
Trusted/Untrusted分区 +untrusted scope+required instruction设计。 - 内容寻址 + 分片锁 + 引用计数 GC:邮件归档、对象存储代理、跨集群缓存、日志聚合系统都能套用。
- Reindex 临时目录 + shared dataStore + atomic rename:任何全文索引系统(ES / Lucene / Bleve / Meilisearch 替代品)平滑升级的通用方案。
- MCP trust boundary 三件套:任何”AI 直连数据”项目(自托管 RAG、企业知识库、AI 客服、AI Code Review)都可以直接复制
- 生态位:Hister 填补了”个人数据 + 全文 + AI RAG + 自托管”四要素的交叉空白——之前的解决方案要么缺全文(Karakeep)、要么缺 AI(Linkding)、要么缺本地文件(Memex)、要么不在 MCP 协议层做 trust boundary(所有其他 RAG 工具)。
- 趋势判断:MCP 协议从 2024 年末发布到 2025 年成为 Anthropic / Claude / Cursor 等多家的事实标准,2026 年是”个人 MCP server”集中爆发的一年——Hister 已稳定内置,是难得的”现在就能用”的成熟方案,符合趋势且比竞品(Karakeep / Memex)有协议层深度的后发优势。
风险与不足
诚实评估:
- 单开发者主导 70.9% —— Adam Tauber 一人 1262 commit,第二名 FlameFlag 仅 153 commit。一旦作者精力转移(与 Searx/Colly 同步维护),项目可持续性是真实风险。Searx 长期也是单人主导,“个人长期项目”模式可参考但非可保证。
- 0.x 版本(v0.19.0)+ ~12.7 天/版的激进发布节奏 —— API / 数据格式仍可能 breaking change,对依赖 Hister 做二次集成或自托管升级的用户,需要逐版本看 changelog。
- CGO 强制 + chromedp + ytdlp 子进程 → ~100MB 镜像 —— 对资源受限场景(树莓派 / 容器冷启动)不友好,且 CGO 跨平台编译比纯 Go 麻烦。
- 测试类型分布偏低 ——
commit_type_distribution中refactor: 0%+test: 2%,不过实际仓库内有 103 个_test.go文件 / ~23797 行测试代码,包括活站点回归(live_test.go12KB 验证 Discourse/Twitter 等真实站点),说明约定上没有为重构建独立标签,测试覆盖率实际是充分的。 - 核心难点在亿级数据下的资源管理 —— #463 Memory Leak OOM + #173 Reindex uses a lot of memory 共同指向:个人搜索引擎的核心张力在”十亿级页面正文”的内存/磁盘管理。作者已解决但这是架构关键弱点,规模化使用前需评估。
- 没有移动端 —— 对”随手收藏 + 移动阅读”用户,Karakeep 的 iOS/Android 客户端仍是更直接的选择。
行动建议
如果你要用它
- 自托管搜索本地数据:从 Docker compose 一行起手(
docker compose up -d),安装浏览器扩展自动捕获浏览历史,配合crawl命令把本地 PDF/Markdown/DOCX 纳入索引。 - 给 Claude/Cursor 做本地 RAG:在 Hister 配置启用 MCP server(
POST /mcp),客户端把 Hister 当知识库后端——这是 Hister 最稀缺的价值,建议优先尝试。 - 从其他书签服务迁入:Hister 已内置
import karakeep/import linkding/import readeck/import wallabag/import shaarli/import raindrop/import linkwarden一键迁移,迁入成本极低。 - 什么情况下选它:需要全文索引 + AI 直连 + 离线可读 + 自托管。
- 什么情况下不选它:仅需轻量书签管理选 Linkding;需要移动端随手收藏选 Karakeep;想做笔记编辑选 Obsidian + 自建 RAG。
如果你要学它
- 架构:重点读
server/indexer/indexer.go(217 次改动、索引器核心)、server/extractor/sdk/(6 方法接口设计)、server/datastore.go(256 分片锁 + 引用计数 GC)、server/mcp.go(trust boundary 设计)。 - 设计哲学:读
CONTRIBUTING.md(含 AI 政策),webui/website/src/content/docs/下 25 篇官方文档(特别是mcp.md241 行 /extractors.md413 行 /configuration.md1255 行)。 - 抽取器:从
server/extractor/extractors/任选一个内置抽取器(如markdown/discourse)模仿;用_extractor_template写自己的第一个抽取器并通过sdk测试。
如果你要 fork 它
- 可改进方向:
- 增加 桌面 GUI 客户端(目前只有 Web + TUI + 扩展 + CLI + MCP 五端,桌面 GUI 仍空缺)。
- 增加 iOS / Android 客户端(Karakeep 的护城河之一)。
- 优化 CGO 镜像体积(从 ~100MB 缩到 <30MB,对边缘部署有意义)。
- 增加 增量 embedding 更新(当前 embedding 漂移需整库 reindex,对增量更新场景可加约束缓存)。
- 补齐 Zread.ai / DeepWiki 中文版文档(目前 DeepWiki 已自动索引但中文社区资料稀缺)。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/asciimoo/hister(已收录,最近索引 2026-09-14,12 节结构化文档) |
| Zread.ai | 未收录 |
| 关联论文 | 无(工程实践项目,无学术对应) |
| 在线 Demo | https://demo.hister.org/(官方 live demo) |
| Hacker News | Story 49351802(社区讨论) |
| 官方文档站 | https://hister.org/ |
| 作者前作 | Searx / Colly / wuzz |