Redis 之父的新战场:1 个月 13K stars 的 DwarfStar(ds4) 怎么把 1M 上下文搬上 96GB MacBook
GitHub: https://github.com/antirez/ds4
一句话总结
antirez (Salvatore Sanfilippo,Redis 之父) 离开 Redis Labs 之后用纯 C 写的 DeepSeek V4 专属本地推理引擎 DwarfStar,把「KV cache 是磁盘一等公民」和「MoE 路由专家 SSD 流式」两个反传统假设做成了端到端可用的 1M 上下文本地推理。
值得关注的理由
- 作者光环 + 持续产出:Redis 之父独立项目,1 个月 284 commits,注释:代码 = 3.77:1,零依赖、零 C++、纯 C 哲学
- 把「不可能」重新定义:把「模型必须能装进 RAM」从硬阈值变成「运行速度谱」—— SSD 流式 MoE 专家 + KV 磁盘化,让 1.6T 参数的 PRO 模型在消费级硬件上理论可跑
- 独家方向引导(dir-steering):无需 fine-tuning、无需 prompt 注入,连续可调的激活方向投影,调节模型 verbosity / 安全 / 风格
项目展示
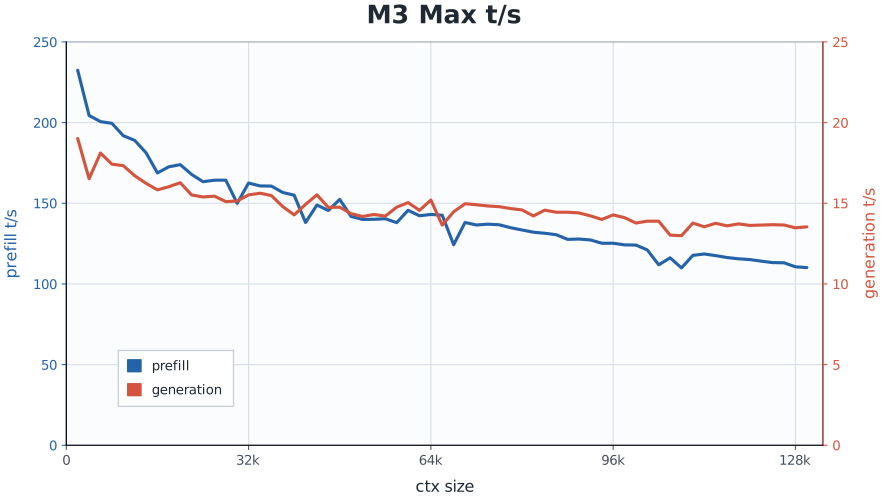 — 类型: hero(性能基准)
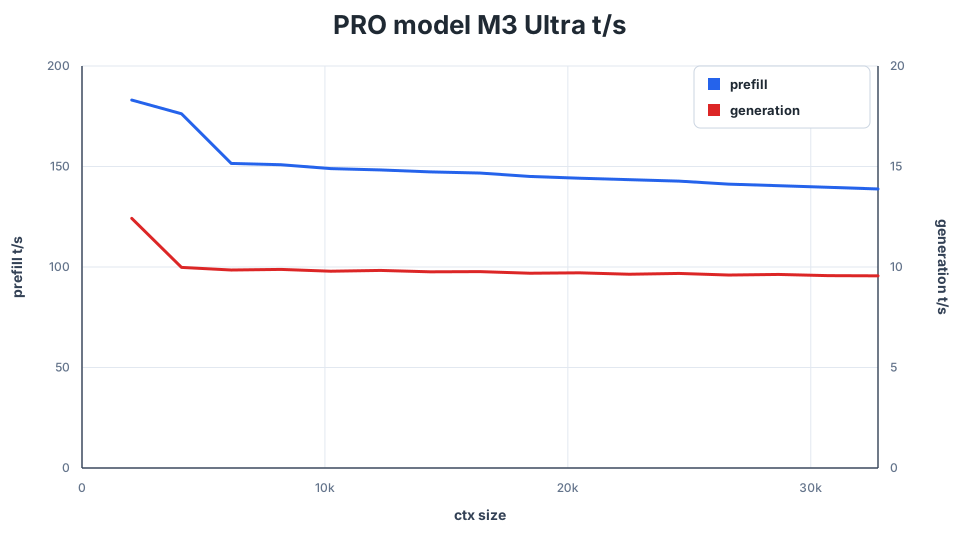 — 类型: screenshot(旗舰款性能)
项目正式名为 DwarfStar,仓库路径沿用 ds4。性能图为 README 唯一展示素材。
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/antirez/ds4 |
| Star / Fork | 13,138 / 1,154 |
| 代码行数 | 108,060(C 68% + Objective-C 21.9% + Cuda 8.8% + Metal 7.5% + Python 3.4% + JSON 4.3% + 其他) |
| 注释行数 | 407,268(注释:代码 = 3.77:1,主动教育读者的代码) |
| 文件数量 | 80 |
| 项目年龄 | 1 个月(首 commit 2026-05-07) |
| 总 commits | 284(30 天 283 个) |
| 开发阶段 | 密集开发(首月爆发后进入打磨期) |
| 贡献模式 | 单人主导(antirez 占 62.9% git log / 82.0% GitHub API,32 位 git 贡献者 / 25 位 GitHub 贡献者) |
| 热度定位 | 大众热门(1 个月内 13K stars,6 月采样 1.9 天内 138 星) |
| 质量评级 | 代码 A / 文档 A+ / 测试 B / 错误处理 A- |
| License | MIT |
作者视角:为什么存在这个项目
创始人/作者背景
Salvatore Sanfilippo(antirez)生于 1977 年,意大利西西里岛 Catania,2009 年开始写 Redis(后来被 Redis Labs 收购),2020 年前后离开 Redis Labs 转为独立开源作者,账号 17.2 年、28,493 粉丝、108 个公开仓库。
2026 年他同时活跃在 ds4、gguf-tools、linenoise(4.3K stars,C REPL 库)、picol(Tcl 解释器)、llama.cpp-deepseek-v4-flash 等多个 C 项目。本项目 ds4 是他目前投入权重最高的仓库(repo_rank=1),延续他「一个 C 文件打天下」、单文件巨型实现、极简可读的工程哲学。
更值得注意的是:本项目 README 第一段就主动声明「developed with strong assistance from GPT 5.5 and humans leading the ideas, testing, and debugging」—— 这是罕见的元层声明,反映 antirez 在 AI Coding 时代重新定义「我是作者」。
问题判断
antirez 观察到三个问题叠在一起:
- V4 模型出来了,但所有现有引擎都没准备好:DeepSeek V4 Flash (284B/13B 激活/1M ctx) 和 PRO (1.6T/49B 激活/1M ctx) 是「quasi-frontier」模型,但 llama.cpp、vLLM、mlx-lm、ollama 都没有端到端原生支持。社区出现 llama.cpp-v4、mlx 适配等「补丁式」实现,碎片化且不可靠。
- 「模型必须能装进 RAM」是过时假设:现代 MacBook NVMe SSD 的访问模式高度可预测(顺序读 + 预取友好),但所有现有方案都把 SSD 当成「慢速后备」。
- MoE + 压缩注意力改变了内存经济学:V4 的 128 压缩比 KV 缓存让长上下文成本暴跌,但推理栈跟不上。
时机为什么是现在?因为 DeepSeek V4 释出 + 大内存 Apple Silicon (M3 Max 96GB / M3 Ultra) 普及 + 高速 SSD 三件事同时发生,缺一不可。
解法哲学
antirez 在 AGENT.md 第一条写明:「Do not introduce C++」,第二条:「Preserve correctness before speed」。这定义了 ds4 的全部技术取舍:
- 零依赖哲学:没有 package.json、没有 CMake find_package,所有 HTTP server / JSON 解析 / tokenizer 全部自撸。可执行文件易分发,但基础设施重造
- 极简 C 单文件:ds4.c 一个 1.1MB 文件承担 GGUF 加载 + CPU reference + Metal graph 调度 + session 管理 + KV 序列化
- CPU backend 只作 reference:macOS 上 CPU 路径会触发 kernel VM bug(README 主动声明),CPU 仅用于单元测试和正确性检查
- mmap-first 加载:不 eager copy 整个 GGUF,让 kernel page cache 决定何时加载;Metal 把 mmap 切片 wrap 成 no-copy MTLBuffer
- 可读性 > 性能:注释:代码 3.77:1,ds4.h 公共 API 故意窄(CLI/server 不应知道 tensor internals)
战略意图
三层战略:
- 短期:成为 DeepSeek V4 的事实标准本地推理方案(参考 llama.cpp 对 Llama 系列的「事实标准」地位)
- 中期:dir-steering(向量方向引导)成为研究社区认可的「prompt-free steering」技术
- 长期:把 mmap + SSD KV + LRU 的整套工程范式反向输出到 llama.cpp / vLLM
纯个人 OSS 项目(MIT),无商业化路径,与 Redis Labs 路径完全不同。
核心价值提炼
创新之处
按新颖度×实用性排序:
- 「KV cache 是磁盘一等公民」:filename = 渲染后 byte 前缀的 SHA-1 哈希(不是 token sequence 本身),跨 session 自动恢复;entry 自带 reason enum (COLD/CONTINUED/EVICT/SHUTDOWN/AGENT_SYSTEM/AGENT_SESSION) 反映设计意图;6 小时 hit half-life 衰减;默认 4GB budget
- MoE 路由专家的 SSD 流式:用当前层 inference 时间隐藏下一层 expert 异步加载;自动 cache plan 分配 (ds4_ssd_auto_cache_plan);从「能不能跑」硬阈值变成「跑多快」连续谱
- Directional Steering(方向引导):43 层 × 4096 维的方向向量矩阵,推理时对每层 hidden state 做投影减法
y = y - scale * d * dot(d, y),FFN output 是经验最佳 target;无需 fine-tuning 即可连续调节模型行为 - DSML tool calling 协议:专有 tool calling 格式,无 OpenAI 兼容层转换开销,ds4_agent.c 内嵌 coding agent loop
- mmap + Metal no-copy buffer wrap:GGUF mmap 后让 Metal 直接 slice 用,零拷贝
- Layer 切分 + activation_bits 分布式推理:ds4_distributed.h 显式 COORDINATOR/WORKER 角色,prefill_chunk + replay_check + activation_bits 配置项
- official API logprobs 对拍回归测试:用官方 DeepSeek V4 API 抓的 top_logprobs 作为 ground truth,本地
./ds4 --dump-logprobs输出做 byte-级对比,tokenizer/template/attention 回归先于长生成失败前被捕获 - 2-bit 量化配对 43 层 MoE 路由:「2 bit quantizations provided here are not a joke: they behave well, work under coding agents, call tools in a reliable way」,imatrix 只对 routed MoE 专家做(
gguf-tools/imatrix),保留 shared expert 全精度
可复用的模式与技巧
- mmap-first 权重加载:不复制 GGUF 进 RAM,直接 mmap 进程虚拟地址 + mlock 关键页避免 swap;对启动速度和内存峰值同时友好
- engine/session 双层 API:
ds4_engine纯模型权重(mmap 指向 GGUF),ds4_session持有 KV/对话/think mode;多 session 共享单 engine,符合服务端化思路 - entry-level LRU + reason enum + half-life 衰减:每条缓存项自带状态标签,用频率衰减而非纯时间戳做淘汰,调试时可追溯每条 KV 的生死
- filename = 字节哈希的 O(1) 寻址:弃用目录树/中央索引,用 key 前 N 字节的哈希做文件名;SSD 友好、无元数据一致性顾虑
- 多 backend 共用 reference 实现:CPU backend 作 reference,AGENT.md 明文禁止 CPU 用于真实推理,强制 GPU/CPU 一致性
- AGENT.md 风格契约:把「不引入 C++」「先正确后速度」等隐性约定写进明文文件,配合 review 流程
- dsml tool calling 协议:自定义 token-level 工具调用格式,省去 OpenAI 兼容层解析开销
关键设计决策
决策 1:mmap GGUF + 不 eager copy
- 问题:1.6T 参数 PRO 模型 800GB+,eager copy 进 RAM 不可行
- 方案:mmap 后让 kernel page cache 决定何时加载;Metal 把 mmap 切片 wrap 成 no-copy MTLBuffer
- Trade-off:首次冷启动有 page-in 延迟;mlock 用量需用户调
- 可迁移性:高——任何 >10GB 的模型文件加载都适用
决策 2:engine/session 严格分离
- 问题:多 session 共享模型时,模型权重不应被会话状态污染
- 方案:
ds4_engine只持有模型权重和静态配置;ds4_session持有 KV cache、对话历史、think mode;session 持有 engine 引用 - Trade-off:调用方需理解两阶段 API,心智负担增加
- 可迁移性:高——与「模型即资源、对话即状态」的服务化思路完全契合
决策 3:三个 think mode 显式建模(NONE/HIGH/MAX)
- 问题:不同任务对 KV 预算、stop token、工具调用语法的需求差异巨大
- 方案:engine 创建时指定 think_mode,影响 stop condition、KV retention 策略、system prompt 模板
- Trade-off:模式切换需 recreate session
- 可迁移性:中——三档分类是经验性的
决策 4:dir-steering 公式 y = y - scale * d * dot(d, y)
- 问题:现有 activation steering 要么 prompt 工程(弱)、要么 fine-tune(重)
- 方案:43 层 × 4096 维的「方向向量矩阵」做投影减法;FFN output 是经验最佳 target
- Trade-off:方向向量本身需要预先计算(offline 步骤);不同模型/任务需要不同方向集
- 可迁移性:中——公式本身模型无关,但「哪一层 + 哪个子空间」需针对具体模型调
决策 5:CUDA/Metal 双 GPU 后端 + CPU 仅 reference
- 问题:多后端测试容易出现「GPU 通过但 CPU 不过」的歧义
- 方案:ds4.h 统一 API,三个 backend 实现同一接口;AGENT.md 明文禁止 CPU 用于真实推理
- Trade-off:增加一层间接调用开销;统一 API 难以暴露 backend-specific 优化(如 Metal MPSGraph)
- 可迁移性:高——任何想加 AMD ROCm 后端的项目都可按此模式添加
决策 6:AGENT.md 明文约束「Do not introduce C++」
- 问题:社区 PR 容易为了性能把代码改成 C++ 或过早优化
- 方案:写进 AGENT.md 硬性约束,review 时优先拒绝违反约束的 PR
- Trade-off:牺牲部分底层优化空间(C++ 模板元编程的 kernel fusion)
- 可迁移性:高——这种「风格契约」机制可被任何追求简洁的小型 OSS 项目复用
决策 7:0 tag / 0 release / 持续 main 分支
- 问题:早期项目如何既快速迭代又满足生产用户?
- 方案:暂时不发布 tag,issue #46 已有 96GB 显存(H100/A100 级别)用户在 production-like 场景跑
- Trade-off:对生产用户不友好;用户需追 head 跑
- 可迁移性:低——只适合项目早期阶段
竞品格局与定位
竞品对比矩阵
| 维度 | ds4 (DwarfStar) | llama.cpp | mlx-lm | vLLM | sglang | ollama |
|---|---|---|---|---|---|---|
| Stars | 13K | ~75K | ~25K | ~35K | ~15K | ~110K |
| 主语言 | C (无 C++) | C++ | Python | Python | Python | C++ shell |
| DeepSeek V4 专精 | ★★★★★ | ★★★ | ★★ | ★★ | ★★ | ★★ |
| Metal 一等公民 | ★★★★★ | ★★★ | ★★★★★ | × | × | ★★ |
| CUDA 一等公民 | ★★★★ | ★★★★★ | × | ★★★★★ | ★★★★★ | ★★★ |
| 长上下文 (1M) | ★★★★★ | ★★ | ★★ | ★★★ | ★★★ | ★★ |
| SSD 流式专家 | ★★★★★ | × | × | × | × | × |
| KV 磁盘化 | ★★★★★ | × | × | ★★ (PagedAttention) | ★★★ (RadixAttention) | × |
| Activation Steering | ★★★★★ (原生) | × | × | × | × | × |
| 端到端 agent loop | ★★★★ | × | × | × | ★★★ | × |
| 用户体验 | ★★ | ★★★ | ★★★★ | ★★★ | ★★★ | ★★★★★ |
| 生态广度 | ★ | ★★★★★ | ★★★ | ★★★★ | ★★★ | ★★★★★ |
差异化护城河
- 方向引导(dir-steering)独家方法论:基于 Refusal in Language Models Is Mediated by a Single Direction 论文,但 ds4 把它工程化为 43 层 × 4096 维的运行时激活编辑,这是其他推理框架都没有的
- mmap + SSD + KV 一体化工程范式:把「模型加载」「KV cache」「MoE 专家流式」三件以前分开的事做成一个统一的 mmap-first 架构
- antirez 个人品牌 + Redis 父亲背书:吸引 Armin Ronacher (Flask 作者) 等高质量贡献者
- DeepSeek V4 事实标准本地实现:与 llama.cpp 有 fork 血缘(antirez 的 llama.cpp-deepseek-v4-flash 项目),保留 GGUF quant layouts/tables/CPU quant logic
- 纯 C 简洁栈对研究者透明:AGENT.md 写明设计哲学,注释:代码 3.77:1,公开 API 窄
竞争风险
- 生态体量远小于 llama.cpp/vLLM:109 个 open PRs 反映社区涌入极快,但 antirez 单人 review 速度跟不上
- 硬件后端广度不及 llama.cpp:仅 Metal + CUDA,AMD ROCm 缺失(issue #16 是社区最热需求,103 评论)
- 企业级特性缺失:监控 / 多租户 / HA / K8s 部署都没有
- 模型支持范围窄:专注 V4 Flash/PRO,主动声明「如果明天有更好的 128GB 级别模型,我们可能切换,旧模型可能完全移除」
- 稳定性风险:beta quality,无 tag 无 release,0 个 refactor commit / 0 个独立 test commit,CPU 路径在 macOS 上会触发 kernel VM bug
生态定位
ds4 在整个 LLM 推理生态中扮演**「DeepSeek V4 + 长上下文 + 可解释性研究的参考实现 + 高级研究者的本地游乐场」**角色。它不与 llama.cpp/vLLM 正面竞争 serving 市场份额,而是占据「小而美研究型 + 特定模型参考」这个生态位。
在 macOS/Metal × DeepSeek V4 这个细分象限属蓝海;通用 LLM 推理大市场是红海。
套利机会分析
- 信息差:ds4 不是被低估,而是被「redis 作者新项目」的品牌效应高估了 star 数;但技术深度可能超出 star 数所反映的层面——很多人 star 完不会读 AGENT.md 和 dir-steering 论文,能深入用起来的人少
- 技术借鉴:
- mmap + mlock + 自动 cache plan 范式可直接迁移到任何大模型本地推理项目
- engine/session 双层 API是 LLM serving 网关的标准设计
- dir-steering 投影公式对任何想做激活工程的人都值得学
- filename = 字节哈希的 O(1) 寻址可移植到嵌入式 KV store
- 生态位:填补「DeepSeek V4 在消费级硬件上原生端到端跑」的空白;填补「activation steering 在推理引擎原生集成」的空白
- 趋势判断:
- 增长曲线是爆发型(1 个月 13K stars,1.9 天采样 138 星),仍在上升期
- DeepSeek V4 持续迭代、MoE + 压缩注意力架构被其他厂商跟进(README 说「Other vendors are using this approach」)
- 比 llama.cpp 的后发优势:在 V4 上从零设计,不是从通用引擎补丁来
- 主要风险:amd ROCm 后端空缺、antirez 单人主导 review 压力大、模型支持范围窄
风险与不足
- 稳定性风险:beta quality,0 tag / 0 release,issue #41 暴露过 buffer overflow + shell injection 安全漏洞(已修复但暴露单文件哲学的代价)
- 平台限制:CPU 路径在 macOS 上会触发 kernel VM bug 死机;AMD GPU 用户被发配到独立
rocm分支 - 生态薄:模型支持范围窄,专注 V4 Flash/PRO,README 主动声明「可能切换到更好的 128GB 级别模型,旧模型可能完全移除」
- 贡献者 review 瓶颈:antirez 占 82% 合并权重,109 个 open PRs 涌入,单人 review 速度跟不上
- 版本管理缺失:0 tag / 0 release,issue #46 已有 96GB 显存生产用户,反过来印证版本管理需求
- 缺少结构化输出:issue #210(12 评论)显示 agent 用户需要结构化输出但还没做
- CI/CD 缺失:仓库无 .github/workflows/,无自动 CI 状态徽章
- commit 风格混乱:refactor 0%、test 0%、other 63.5%,未走 conventional commits 范式
行动建议
如果你要用它
- Mac 本地跑 DeepSeek V4 Flash:✓ 首选,Metal 一等公民 + SSD 流式 + imatrix 量化都为你准备好
- Linux + NVIDIA 单卡 48-96GB 跑 V4 PRO:✓ 可用,CUDA 后端已成熟(issue #34 关闭),但性能优化空间大(issue #244)
- AMD GPU:✗ 别选,得用社区维护的
rocm分支,自己编译 - 生产部署:✗ 暂不推荐,0 tag / 0 release,antirez 自己说「beta quality code」,issue #41 安全漏洞暴露早期产品代价
- 想用 DeepSeek V4 之外的模型:✗ README 明确说只支持 V4 Flash 和 V4 PRO 的特定 GGUF
如果你要学它
重点关注这些文件(按价值排序):
ds4.c(1.1MB)—— 单文件 C 哲学的极致;mmap 加载、CPU reference、Metal graph 调度都在这一个文件ds4.h(14KB)—— 公共 API 设计示范;engine/session 分离的范例ds4_kvstore.h+ds4_kvstore.c(9KB + 52KB)—— KV 磁盘化设计:entry reason enum、6h half-life、filename = byte prefix hashds4_ssd.h+ds4_ssd.c(1KB + 6KB)—— SSD 流式专家:自动 cache plan、内存锁、GiB 参数解析dir-steering/—— 方向引导的完整实现(公式 + 工具 + 例子)metal/*.metal(moe.metal / dense.metal / dsv4_hc.metal / dsv4_kv.metal / flash_attn.metal)—— 5 个职责分明的 Metal kernel,是少见的「结构化 GPU 内核组织」AGENT.md—— antirez 写给 AI agent 看的设计契约,「Do not introduce C++」是核心
如果你要 fork 它
可以改进的方向:
- 加 AMD ROCm 后端:issue #16 是 103 评论的社区最大呼声,按 ds4.h 的三 backend 模式添加第 4 个
- 加版本管理:从 0 tag / 0 release 转向 0.1 → 0.2 → 1.0 语义化版本
- 加结构化输出:issue #210 是 agent 用户的下一阶段需求
- 加 vLLM 风格 PagedAttention:用 paging 替代 ds4 当前的固定 KV 槽位
- 加 multi-GPU 调度:issue #123,ds4_distributed.h 已有 coordinator/worker 抽象
- 加 CI/CD:仓库无 .github/workflows/,加 GitHub Actions 自动跑 make test + speed-bench
- 把 dir-steering 做成 library:方向向量是模型无关的,可抽出来给其他框架用
- 把 mmap + SSD 流式范式输出到 llama.cpp:这是 antirez 战略意图的第 3 层
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | https://deepwiki.com/antirez/ds4 |
| Zread.ai | 未收录(403 错误) |
| 关联论文 | Refusal in Language Models Is Mediated by a Single Direction(dir-steering 理论基础) |
| 在线 Demo | 无(本地推理项目,无 hosted demo) |
| 作者博客 | http://invece.org(SSL 异常,访问受限) |
| DeepSeek V4 模型卡 | https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash |