📰 公众号已发布 2026-06-08
本地 LLM 选型不靠猜大小:whichllm 3 个月 3.4K stars 的 evidence-based ranking
一句话总结
whichllm 是一款本地 LLM 选型 CLI——把推荐函数从「能 fit 哪个」升级到「能 fit 的里面哪个最可能用得顺手」,核心是用 6 源评测合并 + lineage-aware 折扣 + MoE 双参数建模,给出可解释、可审计的 evidence-based ranking。
值得关注的理由
- 3 个月从零到 3.4K stars:84.5% 单人开发、207 commits、9 个 0.5.x 版本,是典型的「独立开发者 + 工程深度 + 真实痛点」组合。
- 直击本地 LLM 的真实选型痛点:HF/Ollama 按 popularity 排序让新模型被埋没,whichllm 用 lineage discount + frozen/current tier 把 stale leaderboard 倒置新模型的问题正面打掉。
- 可迁移的工程范式:5 级 evidence discount、partial_offload step-function、fail-safe detector pattern、multi-source concurrent + soft-fail pipeline,每一项都是跨域可复用的工程模板。
项目展示
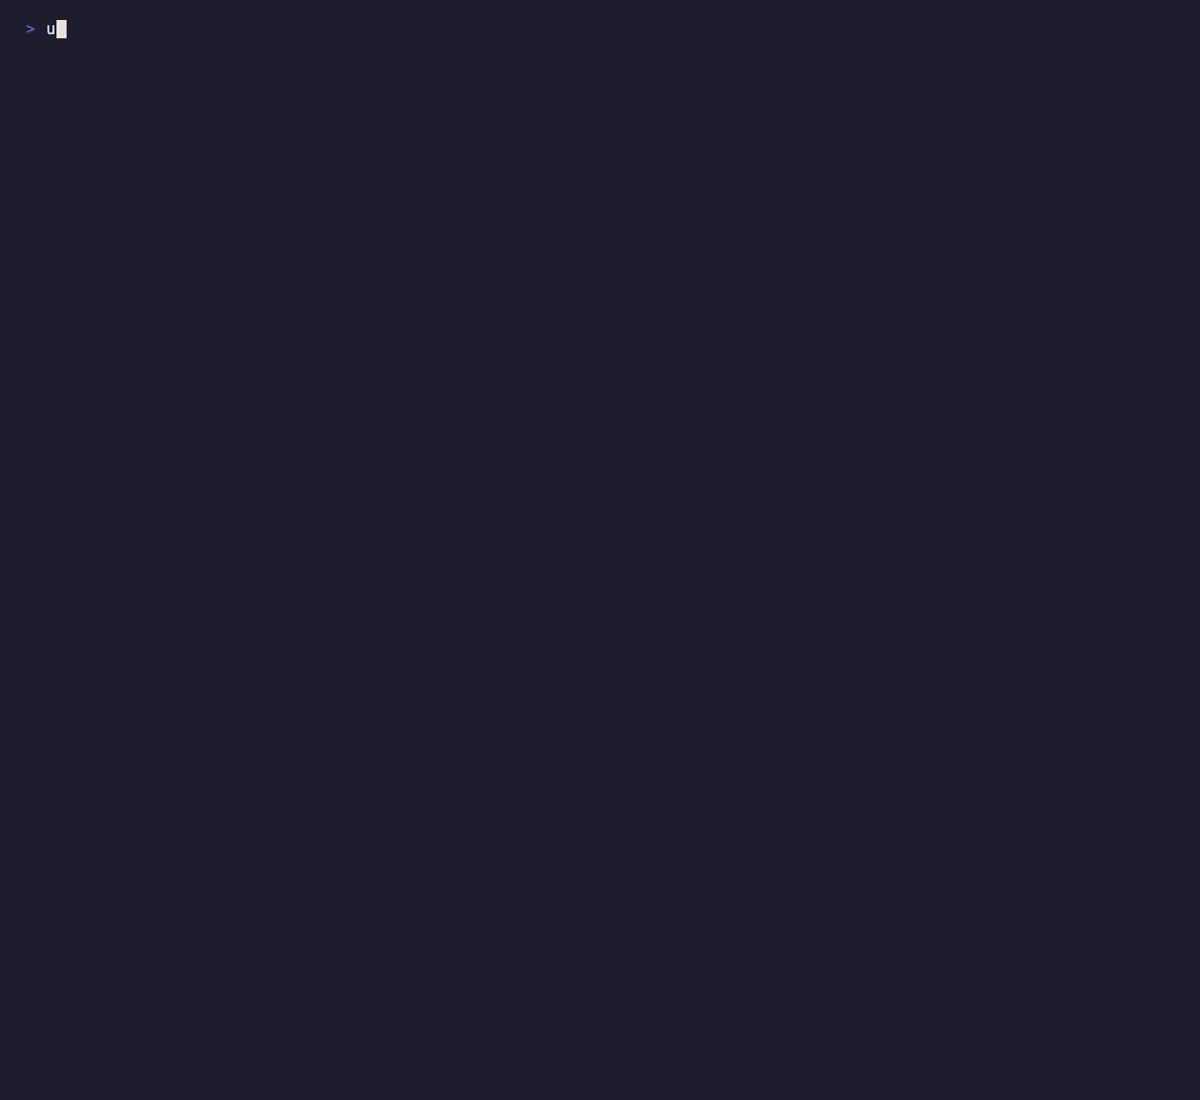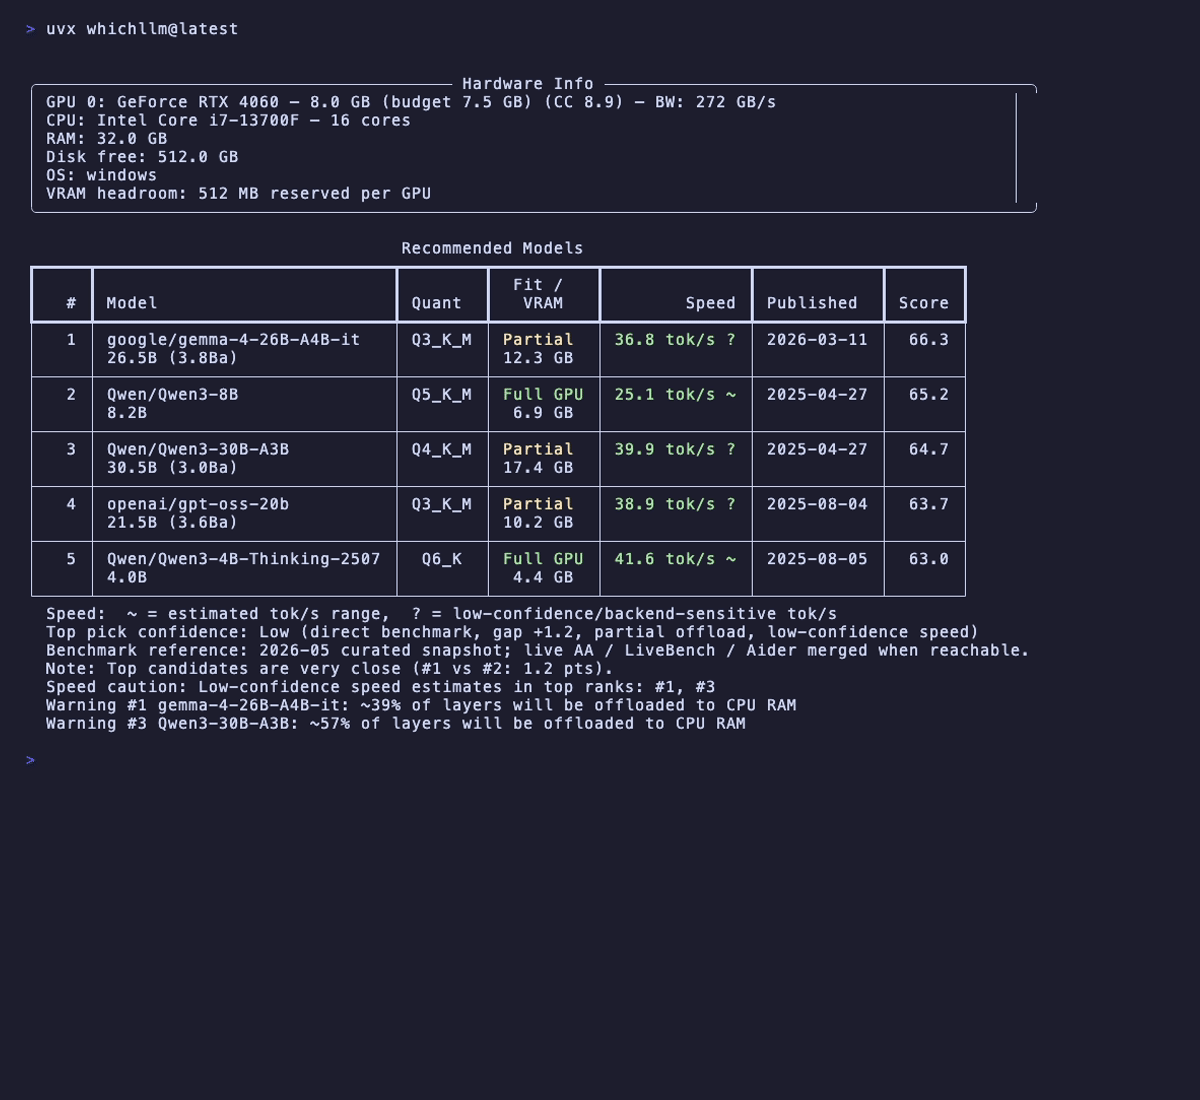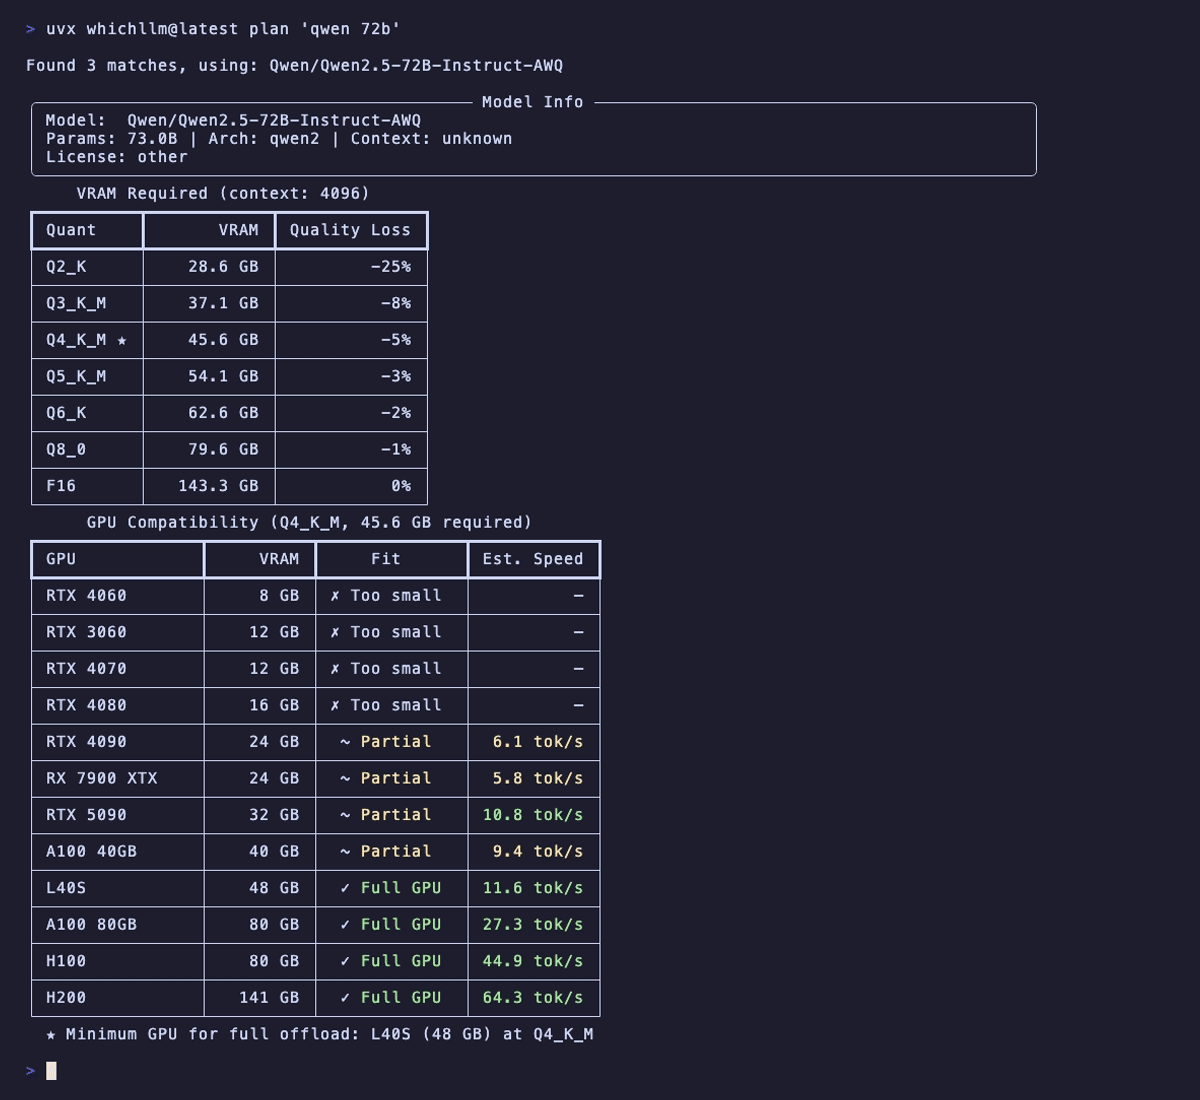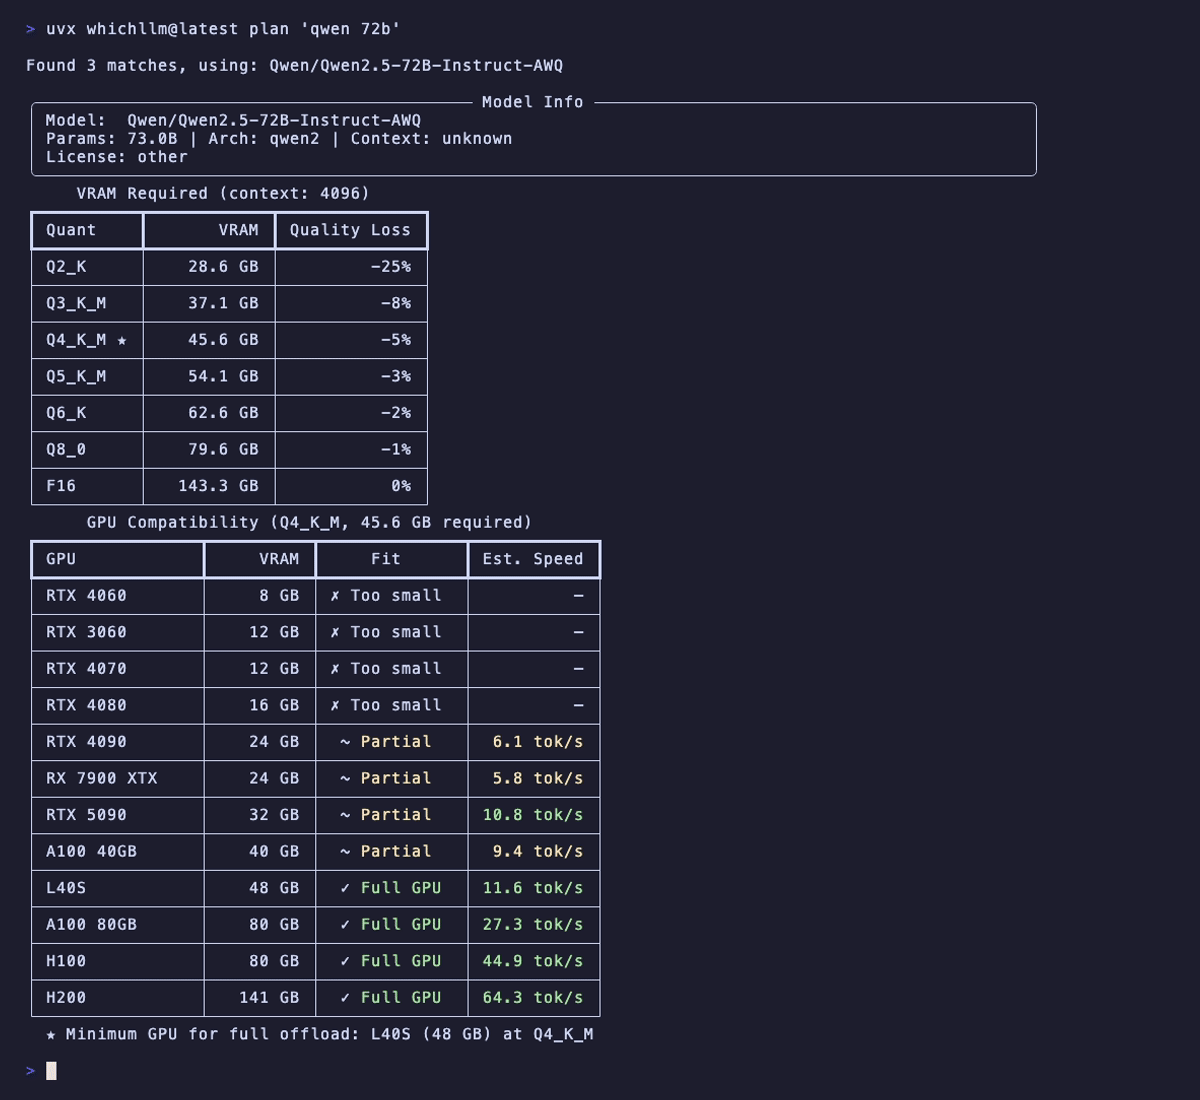
whichllm --gpu "RTX 4090" 主推荐流程演示
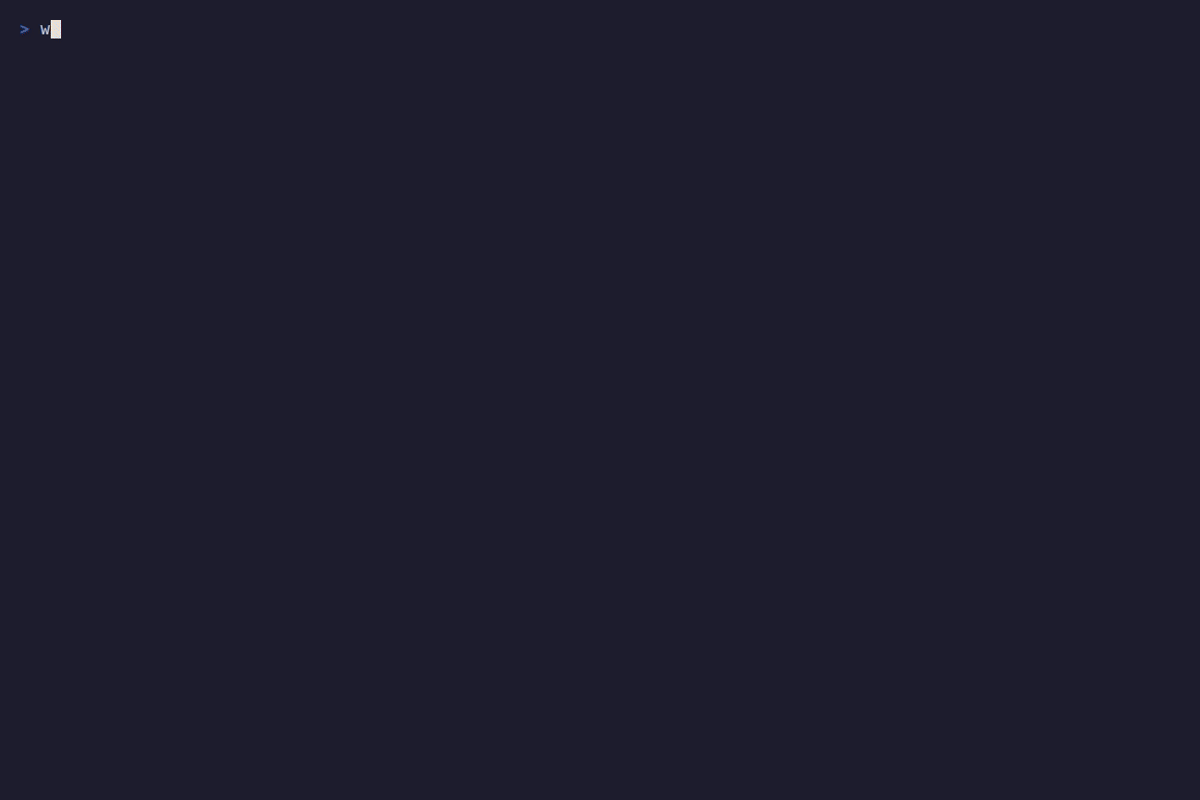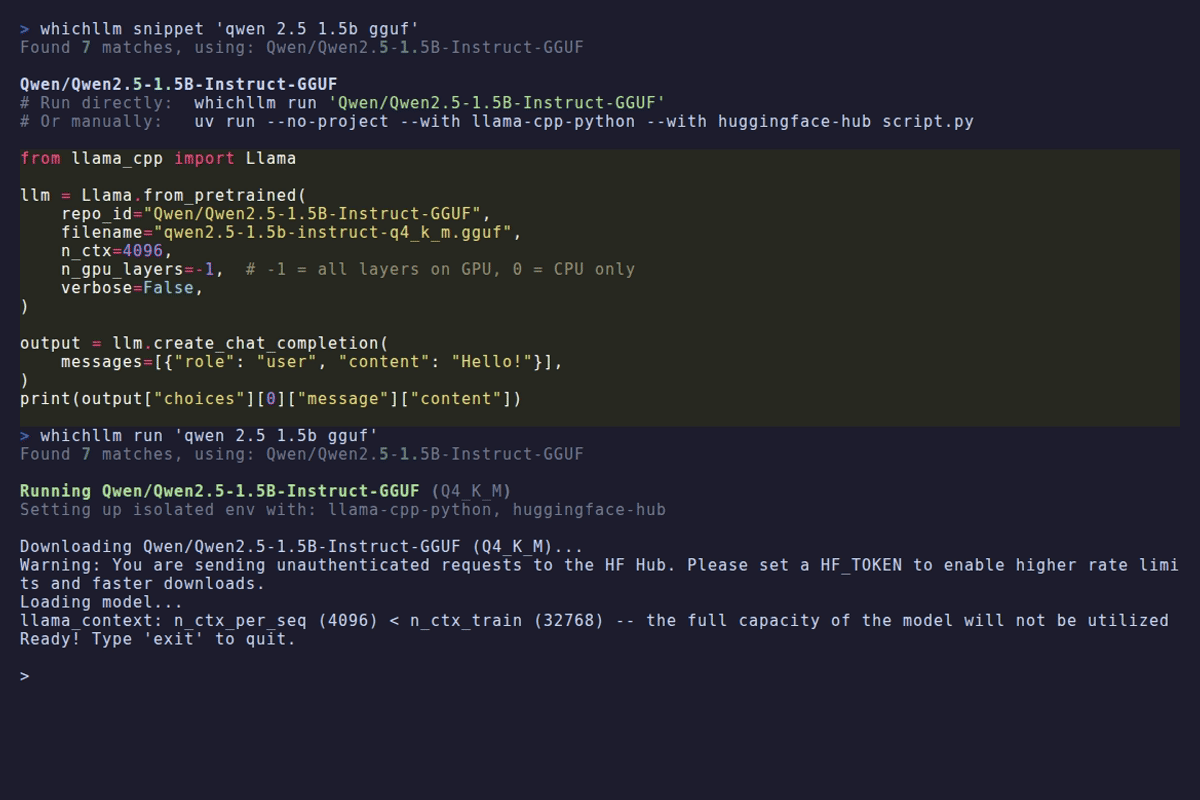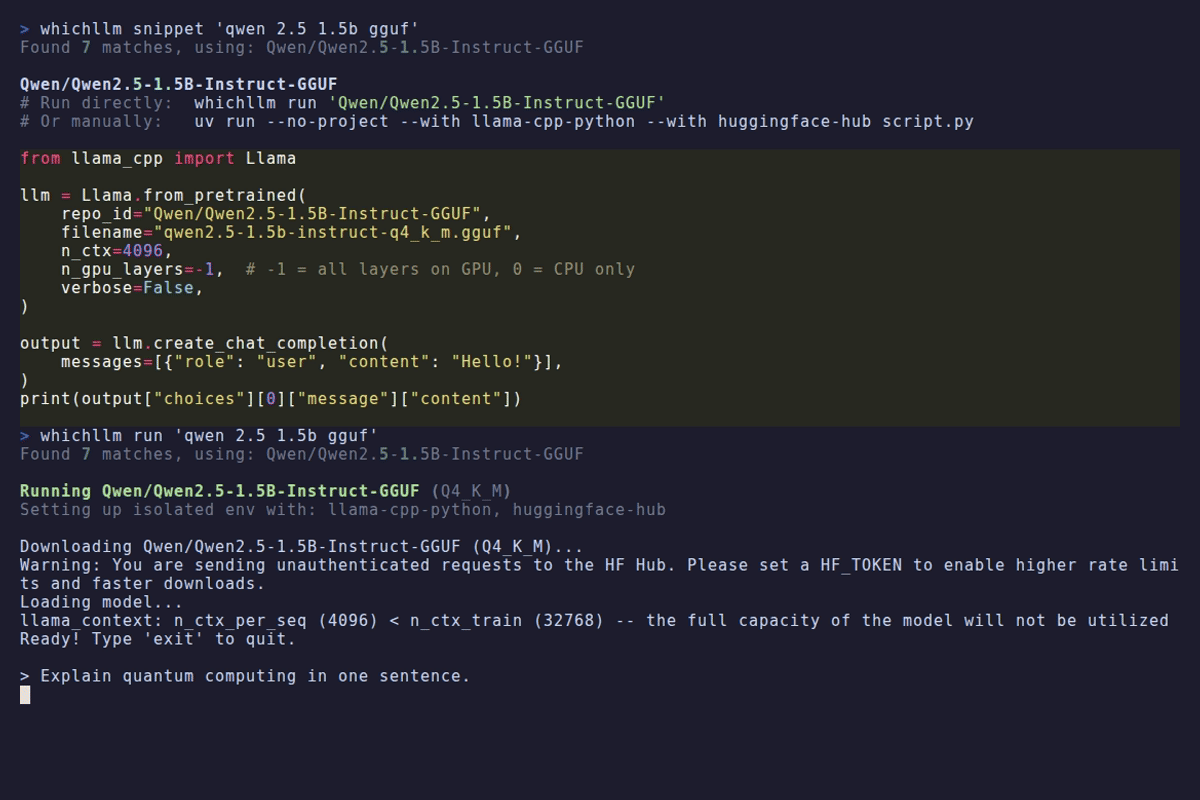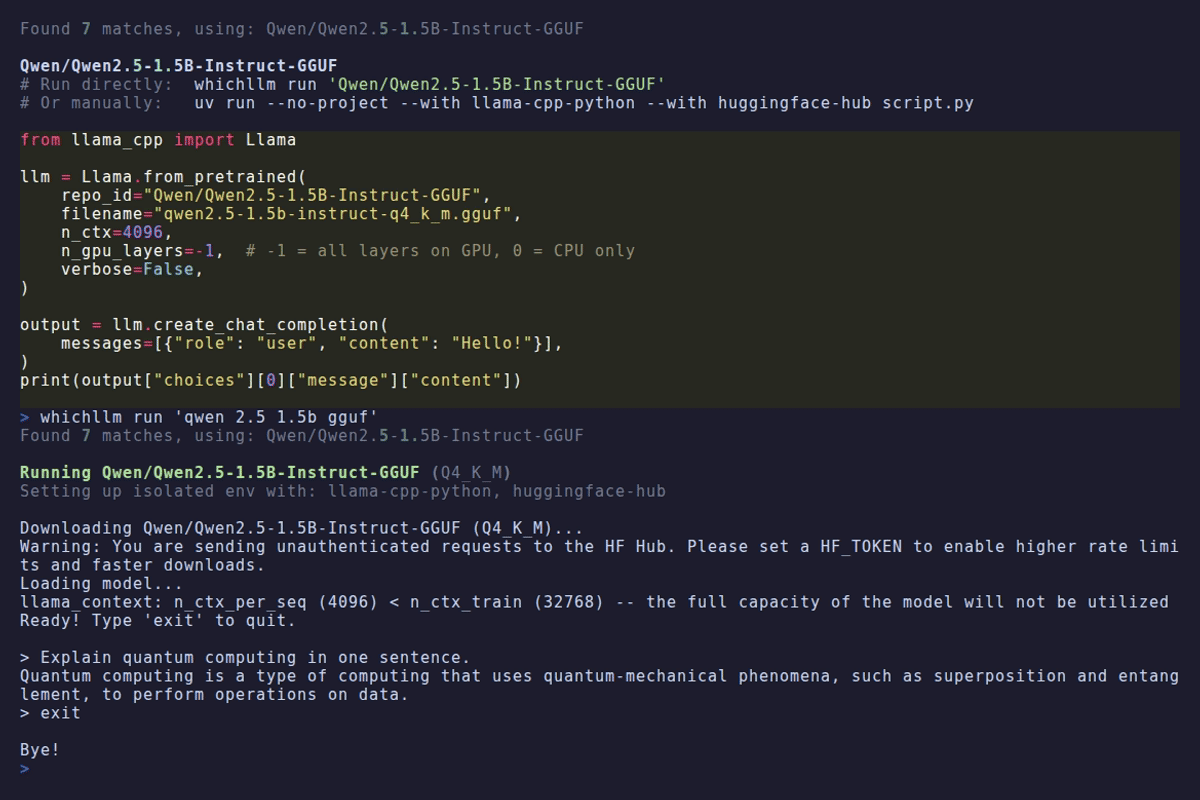
whichllm run "qwen 2.5 1.5b gguf" 一键下载并启动对话
star 增长曲线:3 个月从零到 3.4K,验证爆发型增长曲线
项目画像
| 维度 | 数据 |
|---|---|
| GitHub | https://github.com/andyyyy64/whichllm |
| Star / Fork | 3,392 / 200 |
| 代码行数 | 10,746 行(Python 99.5% / TOML 0.5%) |
| 项目年龄 | 3.2 个月(首次提交 2026-03-04) |
| 开发阶段 | 密集开发(近 30 天 125 commits) |
| 贡献模式 | 独立开发(84.5% 单人占比,16 名贡献者) |
| 热度定位 | 中等热度(小众精品出圈中) |
| 质量评级 | 代码 A- 文档 A 测试 A- |
作者视角:为什么存在这个项目
创始人/作者背景
- andy / andyyyy64:4.1 年 GitHub 账号、72 followers、95 个公开仓库,bio 仅写「love computer」,无公司隶属。独立开发者,专注本地 LLM 工具链,已发布 PyPI / Homebrew / uvx 多渠道包,并自建
homebrew-whichllmtap。 - 投入权重:本 repo 是其最近活跃仓库中第 2 名(仅次于
openTiger),3.4K stars 占其个人可见 star 的绝大多数——这是「all in」级别投入。
问题判断
作者从「a 32B Q4_K_M 真的比 27B Q5_K_M 好吗」这一具体困惑反推。在他的从业直觉里,「参数-质量对数律在 27B→32B 已经接近饱和」——但 HF/Ollama 给的 popularity-sorted 列表不体现这个事实,Ollama 只问「你能跑吗」而不问「你应该跑吗」。
时机:2026 上半年正是 MoE 模型大爆发(DeepSeek-R1、Qwen3 系列、MiniMax-M2 等 frontier MoE 集中发布)+ 用户从「单卡 24GB」升级到「48GB / 64GB」的关键过渡期,「ranked recommendation」从可有可无变成必备功能。
解法哲学
- 「Evidence-based ranking, not a size heuristic」:把推荐拆成可解释、可调、可审计的若干因子(benchmark quality + size proxy + 量化惩罚 + 证据置信 + 运行时 fit + 速度 + 来源可信度 + 热度 tie-break),并对每条 score 打
~/!sr/?标记让陈旧或自我报告一目了然。 - 「证据层」而不是「数据层」评分:把「是否有独立 benchmark」作为主信号(
_SOURCE_WEIGHTS6 档:0.62/0.50/0.55/0.40/0.30/0.0),把「参数大小」作为粗代理。 - 明确不做什么:不做 runtime(让 Ollama 做)、不做 chat UI(让 open-webui 做)、不做 live benchmark measurement(速度是 planning estimate,不是实际跑分)—— whichllm 是「路由器 + 启动器 + curated 评测」的精准定位。
战略图景
- 商业化:GitHub Sponsors 入口 + 文末「赞助可保持项目维护」——显式接受赞助但「stay open-source either way」,定位是「独立维护者 + 社区工具」。
- 生态合作:README 显式提供
whichllm --top 1 --json | jq ... | ollama run管道,把 Ollama 当 target runtime 而非竞品;run子命令直接用uv run --with llama-cpp-python/transformers拉起临时环境——这是「路由器 + 启动器」的双重身份。
核心价值提炼
创新之处
| 创新点 | 新颖度 | 实用性 | 可迁移性 | 一句话 |
|---|---|---|---|---|
| 5 级 evidence discount + 2× 参数继承拒绝阈值 | 5/5 | 5/5 | 5/5 | 把「借分」从黑名单升级成 6 级置信度门控 |
| MoE 双参数评分(total 评知识,active 评吞吐) | 4/5 | 5/5 | 4/5 | 同一模型给出「知识容量」和「推理速度」两条独立曲线 |
| Lineage-aware 12%/gen recency 折扣 | 5/5 | 4/5 | 3/5 | 14 个 family 的 generation index + 「老 leaderboard 倒置新模型」修复 |
可解释多因子 score + ~/!sr/? marker | 3/5 | 5/5 | 5/5 | 任何 ranked output for non-experts 都该学这套可审计性 |
| Partial offload 分段 factor + MoE 加成 | 3/5 | 4/5 | 4/5 | 把「能 fit」和「能用」分离,4 段 + 0.08 MoE bonus |
| Apple Silicon unified-memory 0.85 vs discrete 0.45 | 4/5 | 4/5 | 3/5 | 同一 fit_type 在不同内存模型下完全不同(CHANGELOG 0.5.2 fix) |
可复用的模式与技巧
_params_compatible2× inheritance gate:任何「二手数据/继承的合理性」门控都适用——model card lineage、引用图、依赖安全。从 CVSS 评分范式移植。- multi-source concurrent fetch + tier merge + soft-fail:5 源 benchmark 用
asyncio.gather(return_exceptions=True)并发拉取,按 current/frozen tier 合并,任何单源失败只 log 不 raise。是 anti-fragile 数据采集的范式。 - fail-safe detector pattern:5 个 OS-specific 探测器各自
except Exception: return [],detector 编排层永远拿到部分结果而非 crash。Issue #85 揭示的反模式是「吞掉根因」,修正方向是「保留 half-blind + 显式告警」。 _partial_offload_quality_factorstep-function 段位:4 段非线性(>=0.75:0.42, >=0.60:0.52, >=0.40:0.62, else:0.72)+ MoE 加成 cap 0.72。直接回应 Issue #76 「A3000 6GB 推荐 27B 78% offload 不可用」的真实痛点。- display marker
~/!sr/?做可审计性:ranker.py:783–791 把 evidence 投影到 4 值 display status;speed 列也用~(medium confidence)和?(low)marker。任何 ranked output 都该标注「这个分数我们有多信」。 family_selection_key复合 single-tuple sort:多目标排序时用(-score, fit_priority, speed_b, status_rank, …)单一 tuple 一次排序,避免「加权后小数点打架」。- derived data 拆
data/模块:gpu/lineage/quantization/framework 各成 curated 字典模块,加自动测试防止「11 non-existent HF IDs」之类运营事故。
关键设计决策
决策 1:multiplicative score 而非 weighted sum
- 问题:直接叠加 8 个因子会让「benchmark 100 的小模型永远胜出」,但用户体验受 quant 和 fit 影响巨大。
- 方案:用乘法
(1 - quant_penalty) × fit_multiplier × evidence_discount,multiplier (0.72 partial / 0.50 CPU-only) 对 fit_type 锁定。 - Trade-off:multiplicative 容易产生「双重惩罚」(CHANGELOG 0.5.1 显式记录 fix),但可读性远高于 additive weighted-sum。
决策 2:MoE 双参数建模
- 问题:80B-A3B 在 parameter_count 维度 VRAM 占用大(所有 experts 都要驻留),但 per-token compute 只用 3B active;按 total 估速度会让 MoE 看起来比 7B 慢 10×,按 active 估会让用户低估显存需求。
- 方案:size_score 用 total params,VRAM 用 total experts 的 weight_bytes,speed 用
_moe_effective_read_ratio按 bandwidth 缩放。 - Trade-off:需要精确的 active_params 表(
fetcher.py:243–283维护 30+ 个 frontier MoE),缺失时退化到 0.6 expert_fraction 估算。手维护表的代价在 CHANGELOG 中可查。
决策 3:硬件 fail-safe 编排 + 异构池合并
- 问题:混合系统(dGPU + iGPU)若简单加总 VRAM,会把 4GB iGPU + 24GB dGPU = 28GB 错误归一为单池。
- 方案:
_fit_candidate_gpus显式过滤 low-aperture shared-memory(has_dedicated_gpu 时剔除),并在 data/gpu.py 维护 18 个 AMD APU marker 子串(STRIX HALO、Radeon 890M……)。 - Trade-off:维护 marker 列表需要发版跟上(CHANGELOG 0.5.4 Strix Halo / 0.5.3 Intel iGPU 都是反应式补 entry)。
竞品格局与定位
竞品对比矩阵
| 维度 | whichllm | Ollama | modelmatch | CanIRunLocalAI | Rezize |
|---|---|---|---|---|---|
| Stars | 3.4K | 不计 | 0 | 0 | 0 |
| 形态 | CLI + lib | CLI + daemon | CLI | CLI | CLI |
| 硬件探测 | NVIDIA/AMD/Apple/Intel/CPU | 无 | NVIDIA only | NVIDIA+RAM | NVIDIA only |
| 推荐模型 | ranked(6 源评测合并) | 无 | boolean fit | boolean fit | VRAM calc |
| 量化策略 | 5+ 格式 + penalty | 自动 | 无 | 无 | 无 |
| 多卡模拟 | 部分(单卡 flag) | N/A | 无 | 无 | 无 |
| 启动 runtime | ✅ uv-managed 临时环境 | ✅ 内置 | ❌ | ❌ | ❌ |
| MoE 区分 | ✅ dual-params | ❌ | ❌ | ❌ | ❌ |
| Lineage 折扣 | ✅ 5 级 | ❌ | ❌ | ❌ | ❌ |
差异化护城河
- 多源评测合并 + lineage-aware 折扣 + MoE 区分:这三个能力生态里任何一方都没做(HF 按 downloads、Ollama 按 catalog、open-webui 几乎没有 ranking 逻辑)。这是「老 leaderboard 倒置新模型」这一真实痛点的最优解。
- 运营护城河:14 个 family 的 lineage 字典 + 30+ frontier MoE 的 active_params 表是 hand-maintained 的——Ollama/HF 有资源可以做,但需要「专人对齐每周新模型」的运营成本,目前没有动力。
竞争风险
- 最可能被 Ollama 替代:如果 Ollama 上线「pick best for me」模式 + HF 加「Benchmarks」tab,whichllm 的核心 value 会被吃掉一半。
- 最可能被 HF 模型浏览器替代:HF Spaces 的「leaderboard tab」+ 用户自定义 weights,理论上能复刻 whichllm 的 evidence system,但 lineage 折扣和 MoE 区分是更深的护城河。
- Issue #65 是潜在雷点:Multi-GPU topology(PCIe/NVLink 带宽)尚未建模,如果 Hugging Face Spaces 推出多卡推荐功能,whichllm 在多卡场景会被甩开。
生态定位
在整个技术生态里扮演「路由器 + 启动器 + curated 评测」的三重身份——「不是 runtime,但打开 runtime 的门」。填补了「用户有硬件 + 用户有 runtime + 用户有 chat UI」三大件中间断层的「我应该 pull 哪个」决策真空。
套利机会分析
- 信息差:低关注度高质量窗口正在收窄(3.4K stars、PyPI+brew+uvx 多渠道、连续月度版本),但仍未进入 HuggingFace/Ollama 同类项目的 10k+ 量级,存在继续发酵空间。Wikipedia/DeepWiki/Zread.ai 均未收录。
- 技术借鉴:5 级 evidence discount、
_params_compatible2× gate、multi-source soft-fail pipeline、fail-safe detector pattern、partial_offload step-function、display marker~/!sr/?——这 6 项中任意一项都可以独立拆出来做技术博客或下游框架。 - 生态位:在「Ollama 装机量 + open-webui 用户量 + HF 模型量」的三角中心,提供 ranking 这一垂直功能,未来若 Open LLM Leaderboard 永久 archived(v2 已 archived),whichllm 的 evidence system 会成为关键替代品。
- 趋势判断:与「local-first AI」+ 「个人硬件升级」+ 「MoE 模型普及」三大趋势完全同向。3 个月从零到 3.4K 暗示用户对「不靠猜大小」的真实渴求。
风险与不足
- 单人维护风险:84.5% 单人占比 + 40.6% 深夜 commit 是典型的「bus factor = 1」画像。如果作者精力转移(如
openTiger抢走时间),项目可能进入低维护期。 - 技术债积累:cli.py 1134 行单文件 + 内联 lazy import(cli.py:267–284)开始掩盖依赖图;Refactor 仅占 1.5%;
_partial_offload_quality_factor是 step function 而非平滑函数,调参依赖 release notes 反馈。 - 运营成本不可忽略:CHANGELOG 0.5.1 显式记录「11 non-existent HF IDs removed from curated fallbacks」,说明 hand-maintained lineage 字典 + curated registry 的运营负担是真实存在的。
- silent-failure 反模式尚未根除:Issue #85 揭示异常被吞只输出空字符串,CHANGELOG 0.5.8 fix 改善了 fetch error 但根因(5 个探测器
except Exception: return [])未变。 - Multi-GPU 短板:Issue #65 仍未解决,HardwareInfo.gpu 已是 list[GPUInfo] 但 CLI
_handle_gpu_option()只接受单卡,性能模型未处理 PCIe/NVLink 带宽。 - 速度仍是 planning estimate:不是 live measurement,对「这个模型在我的卡上能跑多快」的核心问题只能给出粗估。
行动建议
-
如果你要用它:
- 直接
pip install whichllm或uvx whichllm起步;用whichllm --gpu "RTX 4090"验证主推荐流,用whichllm upgrade做买卡决策。 - 对 6GB 笔记本等「边界硬件」用户,先用
--mode quality或--mode speed显式选择,再依赖 partial_offload_factor 的 MoE 加成避免被推荐 27B 78% offload 模型。 - 想要 multi-GPU 体验:先用
--gpu "RTX 4090"模拟「如果我升级到 4090」做规划,但不要把它当作「我现在有两张卡」的真实配置。
- 直接
-
如果你要学它:
- 核心阅读顺序:
engine/ranker.py(12 修改,12 决策点) →engine/compatibility.py(partial_offload_factor) →models/benchmark.py(5 级 evidence) →data/lineage.py(curated dict) →hardware/detector.py(编排模式)。 - 设计哲学:
docs/scoring.md第 281–290 行的 8 因子表是整篇 README 的核心。 - Release 学习:CHANGELOG 0.5.0 → 0.5.8 是教科书式的「早期产品 0.x 演化」案例,每版都有清晰的 Added/Fixed/Changed 分类。
- 测试方法学:
tests/test_p1_p3_regressions.py+test_r3_regressions.py显式记录「revert-fix = test fails」,是 anti-regression 的良好工程实践。
- 核心阅读顺序:
-
如果你要 fork 它:
- 改进方向 1(最高 ROI):Multi-GPU topology + PCIe/NVLink 带宽建模——直接回应 Issue #65,是当前最大短板且无现成方案。
- 改进方向 2:live benchmark measurement——把速度从 planning estimate 升级为实测,但需要约束资源(llama-cpp-python 的 warmup + 1 token time 是合理起点)。
- 改进方向 3:把
_LINEAGE_REGEX+MODEL_LINEAGE_VERSIONS抽成可热更新的 JSON schema,让社区 PR 参与 curated 字典的运营。 - 改进方向 4:silent-failure 修复——为 5 个探测器加
_safe_detect_with_reason(),异常时返回(result, error_summary)tuple 而非空 list。 - 谨慎方向:不要试图「也做 runtime」或「也做 chat UI」——Ollama 和 open-webui 已经做得很好,whichllm 的价值在于精准定位「路由器 + 启动器 + curated 评测」,扩张反而稀释核心。
知识入口
| 资源 | 链接 |
|---|---|
| DeepWiki | 未收录 |
| Zread.ai | 未收录 |
| 关联论文 | 无(工具型 CLI 不产出论文) |
| 在线 Demo | 无(CLI 工具本地运行即 demo;PyPI 安装入口 https://pypi.org/project/whichllm/) |
| 中文 README | https://github.com/andyyyy64/whichllm(仓库根 README,15KB) |
| 日文 README | https://github.com/andyyyy64/whichllm/blob/main/docs/README.ja.md(验证日文社区为主要用户群) |
| 评分设计文档 | https://github.com/andyyyy64/whichllm/blob/main/docs/scoring.md |
| 架构文档 | https://github.com/andyyyy64/whichllm/blob/main/docs/how-it-works.md |
相关报告
MaxKB
⭐ 20.6k Python AI AgentLLM 框架开发者工具
万星小镇的 1KB 玄学:a16z × Convex 的 AI Town 凭什么让 8 个 NPC 自己聊出性格
⭐ 10.0k TypeScript AI AgentLLM 框架LLM 推理 已发布
GitHub 推荐:8.5K stars 严重低估:checkout 撑起 95% GitHub workflow 的真相
⭐ 8.5k TypeScript 开发者工具协议与规范安全 已发布
Google 工程总监的 23 份 SKILL:3.7 个月把 49.7K Star 拉爆的"工程纪律即 prompt"
⭐ 49.7k Shell AI AgentAI 编程开发者工具 已发布
SpotiFLAC
⭐ 6.6k Go 开发者工具音视频
GitHub 推荐:54K stars 的孤勇者:Motrix 用 31 个月沉默换一次 v2 turbo 重写
⭐ 54.0k TS AI Agent开发者工具协议与规范 已发布